нейросетиСбросить фильтр ×

Как улучшить дизайн-код AI-агентов

С@svyatamestoAI-инженер
4 нед
Как улучшить дизайн-код AI-агентов

Обзор новых инструментов и моделей для Krea 2

Н@GreenNeuralRobotsAI-инженер
4 нед

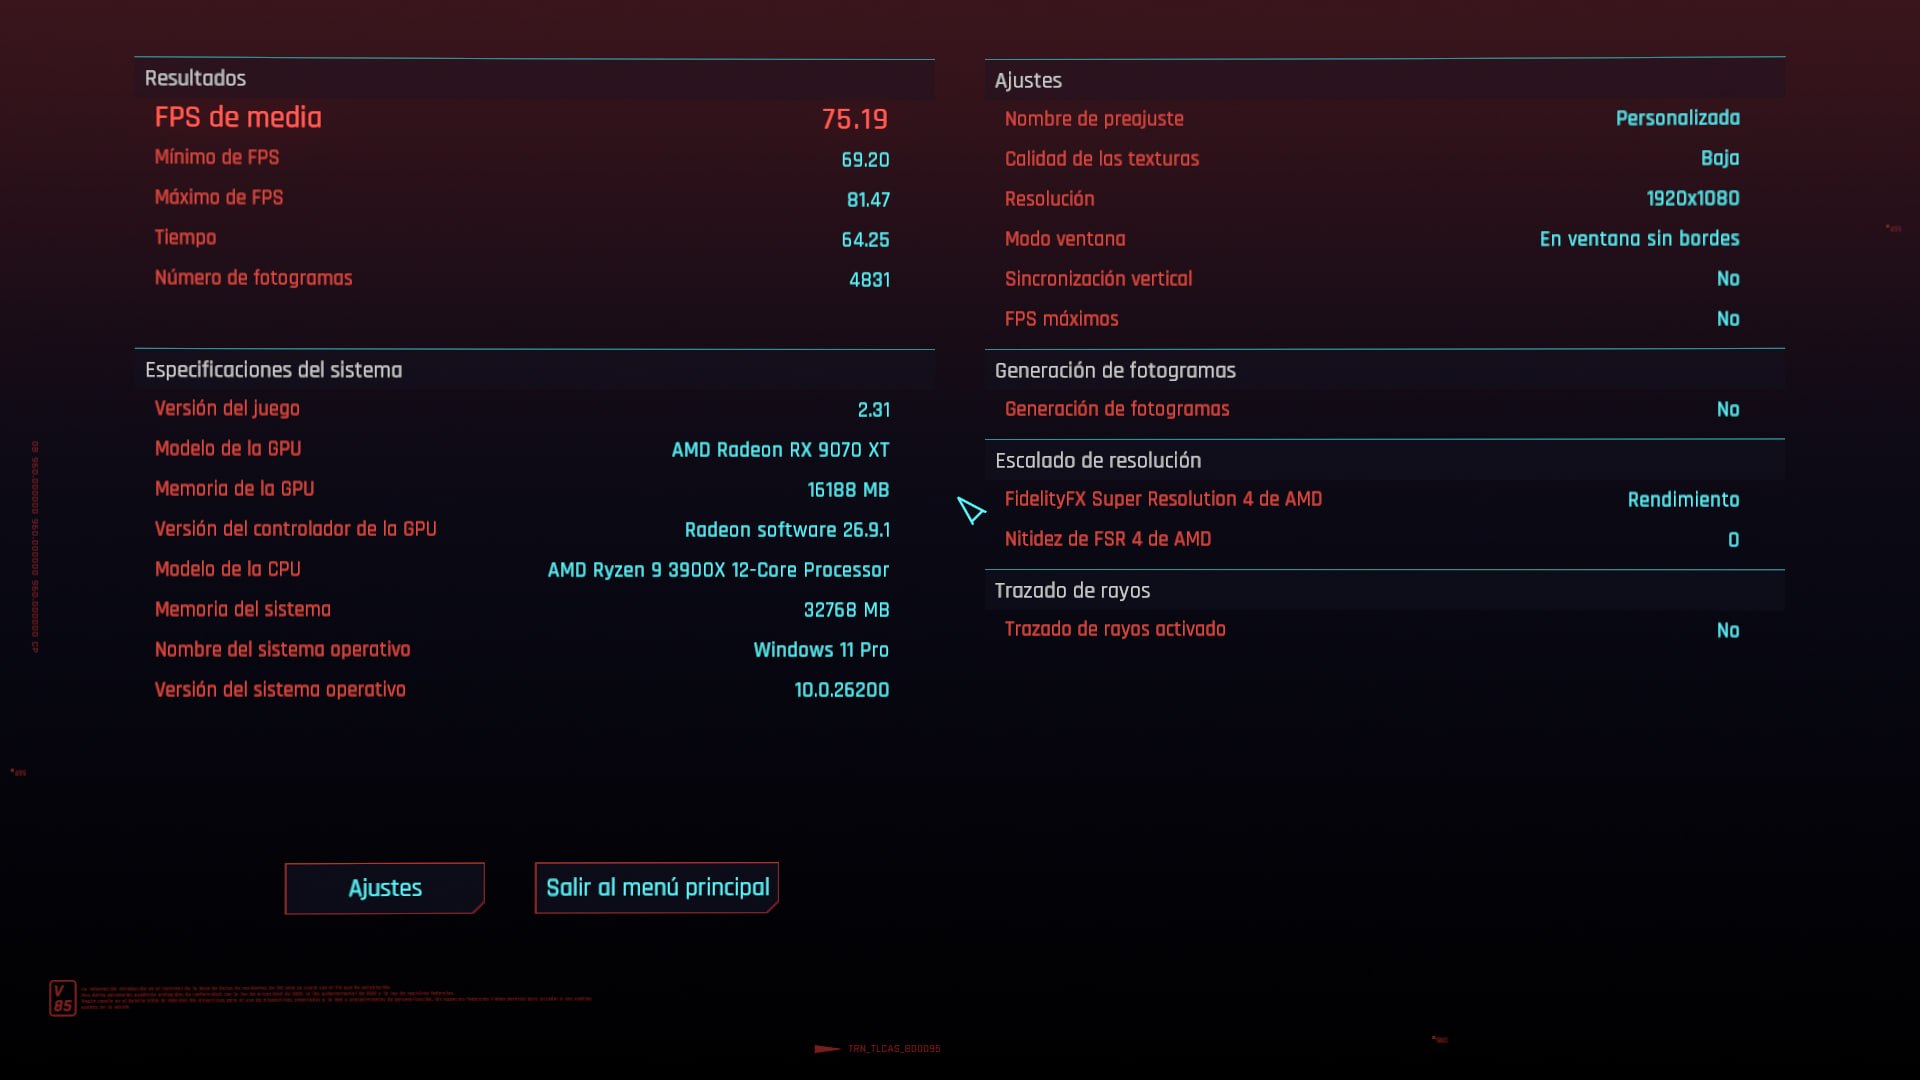
Моддер увеличил производительность Neural Rendering на картах Radeon

P@prohitecавтор про «tech»
4 нед
Моддер увеличил производительность Neural Rendering на картах Radeon

Анонс модели Naive-N0.5-Flash от NaiveAI

Н@GreenNeuralRobotsAI-инженер
4 нед
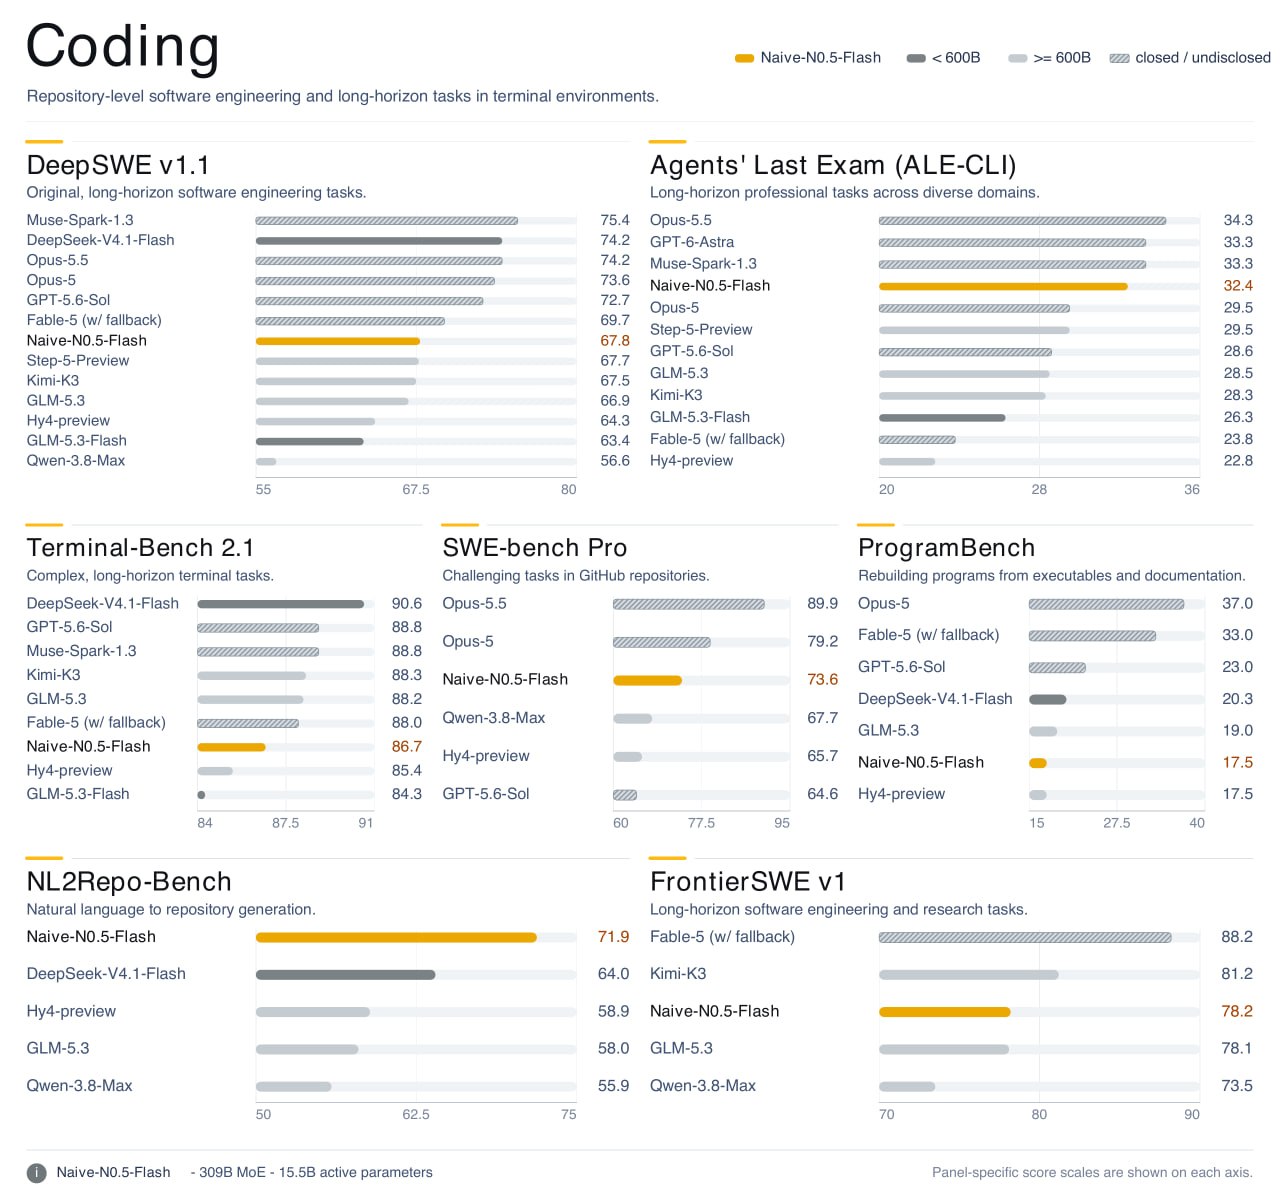
Naive-N0.5-Flash от NaiveAI Модель для кодинга и AI-исследований: 309B параметров MoE при 15.5B активных. Нативный контекст в 1 млн токенов без полного внимания - гибрид скользящего окна и разреженного внимания DSA от DeepSeek • 1M контекста целиком • до 2000 токенов/сек в режиме Ultrafast через свою систему NaiveRT • 50 токенов/сек на юзера в стандартном режиме • построена на базе Xiaomi MiMo-V2.5, дообучена на 3.25T токенов • веса под MIT, FP8 • API: $0.10 вход / $0.40 выход / $0.01 кэш за миллион токенов Только NVIDIA с FP8, веса ~315 ГБ Гитхаб HF Спасибо @m_franz #flagship #coding MAX
Анонс модели Naive-N0.5-Flash от NaiveAI

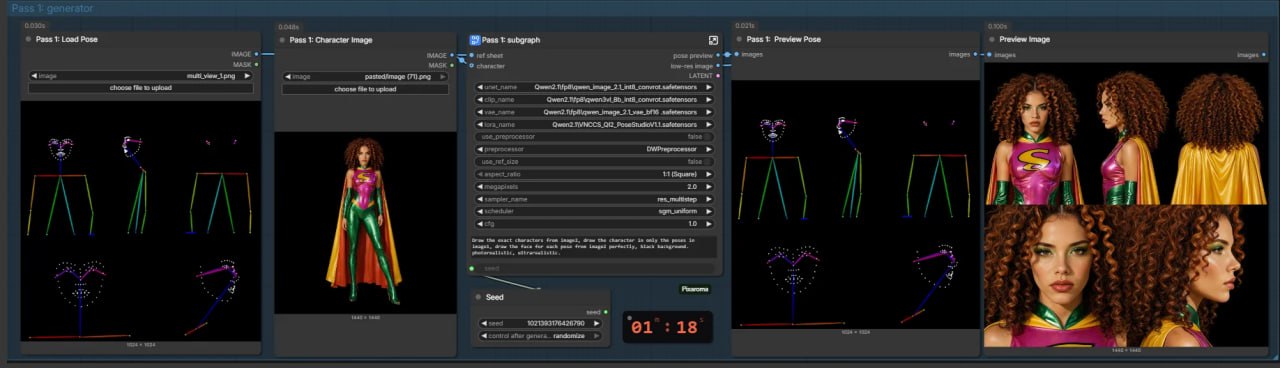
Обзор инструментов и воркфлоу для Qwen Image 2.1

Н@GreenNeuralRobotsAI-инженер
4 нед
Обзор инструментов и воркфлоу для Qwen Image 2.1

Опыт разработки лендинга с помощью GPT

А@undisruptкарьера / HR
4 нед

Запуск еженедельного дайджеста ИИ-видео и продакшна

Н@neuronutsAI-инженер
4 нед
Сделал то, что давно собирался — начиная с сегодняшнешо для и теперь каждый понедельник на канале будет выходить дайджест ИИ-нововстей. При этом это будут новости, которые касаются ии-видео и ии-продакшна. Без воды и лилнего.

Китай не верит в апокалиптические прогнозы Запада об ИИ

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 4 нед назад

По данным NYT, в Китае предупреждения американских компаний о рисках ИИ воспринимают как маркетинговую уловку, призванную замедлить развитие китайских конкурентов в индустрии. Местные СМИ называют эту стратегию «маркетингом страха».

Китайские специалисты и чиновники считают апокалиптические сценарии уничтожения человечества ИИ либо маловероятными, либо особенностью западной культуры, а не реальной угрозой.
Полный разбор →

Критика дизайна Claude

К@ilyabirman_channelмедиа / агрегатор
4 нед
Дизайн Клод-дизайна Краем глаза посмотрел на Клод-дизайн. Дизайн Клод-дизайна явно делал Клод-дизайн: вроде выглядит миленько, но никакого порядка, смысла и логики нет ни в чём. Собственно, в последнее время то же самое происходит в большинстве дизайна, сделанного людьми, так что, думаю, Клод-дизайн — вполне достойная замена многим дизайнерам.

Обзор инструментов и LoRA для Minimax H3

Н@GreenNeuralRobotsAI-инженер
1 мес

Google готовит запуск флагманской модели Gemini 4 до конца 2026 года

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 1 мес назад

Google планирует выпустить флагманскую ИИ-модель Gemini 4i до конца года — сейчас модель дорабатывается. В DeepMindi заявляют, что воодушевлены результатами и хотят как можно скорее показать предварительную версию.

Запуск призван сократить отставание Google от конкурентов: компания не выпускала новую флагманскую модель с ноября 2025 года, тогда как OpenAI и Anthropic за это время представили более сильные решения.
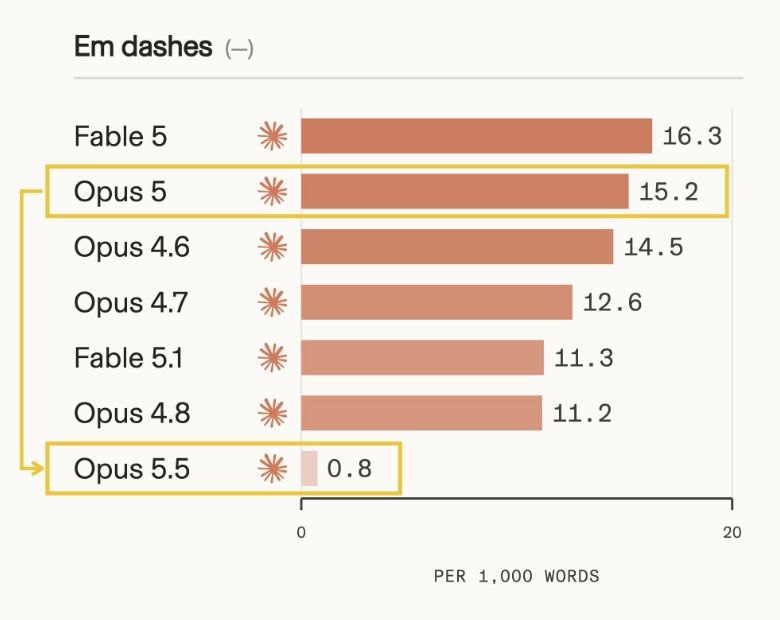
Полный разбор →

Эксперимент с генерацией видео и аудио: Opus 5.5, Gemini 3.8 и Minimax

E@ProductsAndStartupsAI-инженер
1 мес
Много вижу восторженных отзывов про видео-редакторские способности Opus 5.5 и аудио-генерацию от Gemini Flash 3.8 —> поигрался сегодня, в аттаче результаты Как вам? Смотреть лучше со звуком На всё про всё ушло $6.43 (видео + аудио), токены из подписки claude/codex не учитываются. как делал: 1) анимация - opus 5.5 2) голос - gemini 3.8 3) картинки - codex (встроенная модель, насколько я понимаю это gpt image 2.5) 4) видео вставочки - minimax-h3-max 5) lipsync видео - minimax-h3-max/lip-sync 6) общая композиция/оркестрация видео - opus 5.5 P.S. Голос пока не мой, но это тоже будет

Эксперимент с компактной языковой моделью

C@chillhousetechAI-инженер
1 мес
Запустили тут небольшой эксперимент модельку, по сути очень хорошая сжатая и довольно бодрая, господа вот тестят сами (портировали даже под движок нужный) можно глянуть что получается в видео или почитать про эксперименты у ребят https://t.me/fuckup_files/1049

Что такое отрицательная галлюцинация в ИИ

T@kryak_startupAI-инженер
1 мес
Что такое отрицательная галлюцинация в ИИ

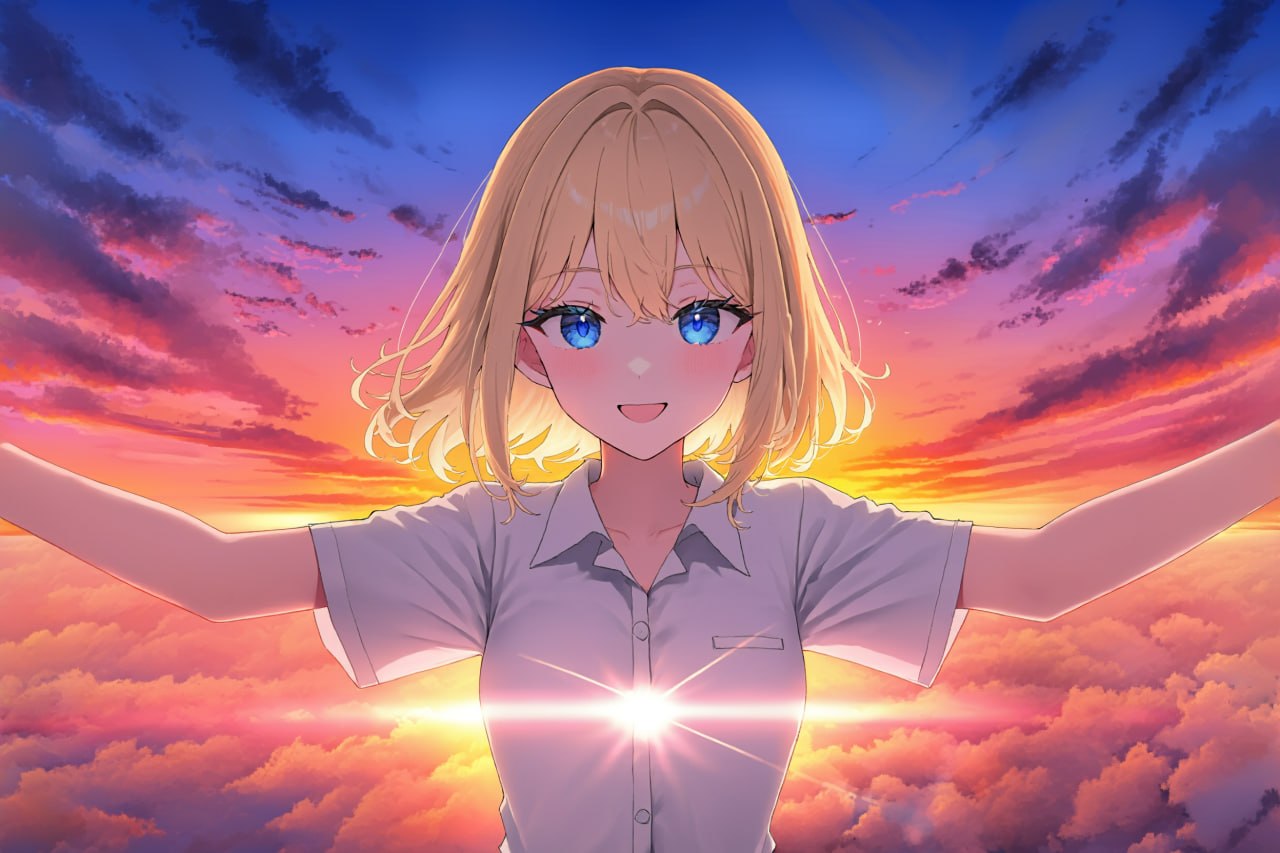
Nanosaur 2: компактная модель генерации изображений

Н@GreenNeuralRobotsAI-инженер
1 мес
Nanosaur 2: компактная модель генерации изображений

Тестирование Gemini 3.8 в голосовом ИИ-тренажере

Л@baldfrombrowserмедиа / агрегатор
1 мес

Выпущен MERT-v2-FullSong: музыкальный энкодер для анализа длинных композиций

Н@GreenNeuralRobotsAI-инженер
1 мес
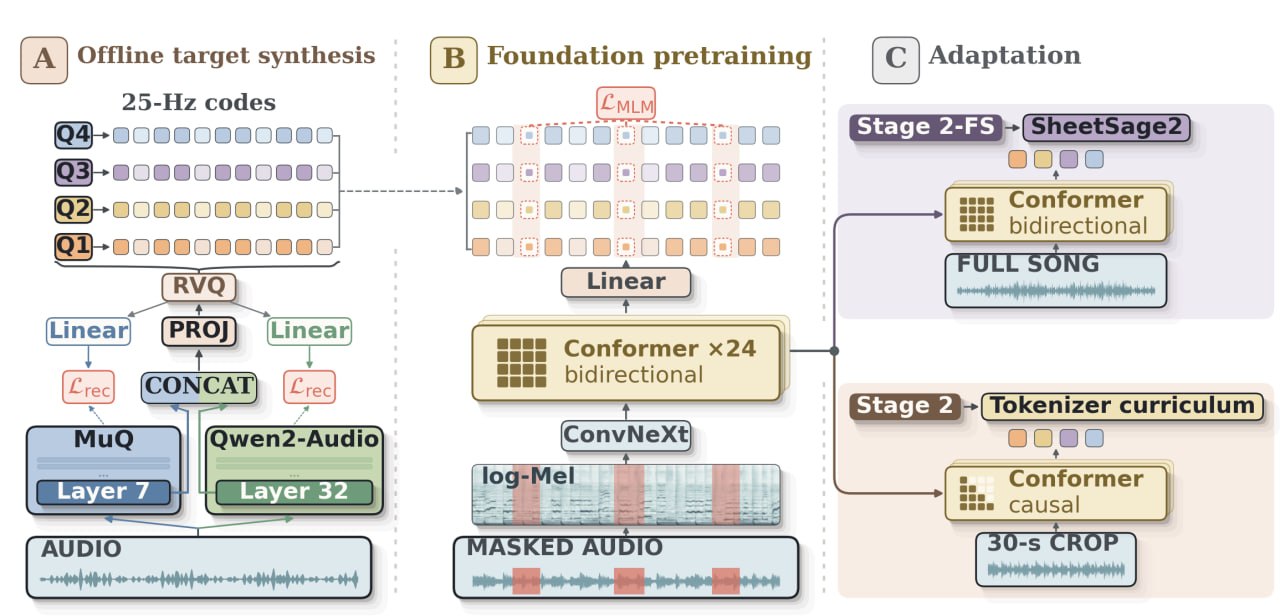
MERT-v2-FullSong Музыкальный энкодер на 632M параметров, который понимает целую песню от 30 до 360 секунд. Продолжение MERT-v2-30s, bidirectional, дообучен на полных композициях • репрезентации на уровне кадров и всей записи • 24 кГц моно, 1024 измерения, 25 Гц • жанр, бит, тональность, эмоции, инструменты, аккорды • интерфейс как у классического MERT - работает через Transformers Место в экосистеме #YuE2: causal-ветка MERT2 токенизирует аудио для генератора песен, а FullSong закрывает эмбеддинги целых треков На бенчмарке MARBLE (15 задач понимания музыки) лучше всех байзлайнов в 13 из 15 метрик #encoder #music MAX
Выпущен MERT-v2-FullSong: музыкальный энкодер для анализа длинных композиций

Opus-5.5 теперь генерирует видео с синхронизацией звука

A@oestickAI-инженер
1 мес
Скоро: видео-монтаж-слоп во всех лентах страны Opus-5.5 теперь сам такое ваншотит на remotion, и синхронизирует звук (раньше приходилось прям пинать и сильно корректировать) Сейчас для меня выглядит прям неплохо, но как ребята в чате верно заметили, нас всех через пару месяцев от такого будет тянуть блевать (а кого-то, кто глубоко в медиа-генерации, наверное, уже) P.s. контент для видео агент сам насобирал под соусом анализа моих чатов, но полезного там почти ничего нет – со смыслами все еще нужно работать вручную

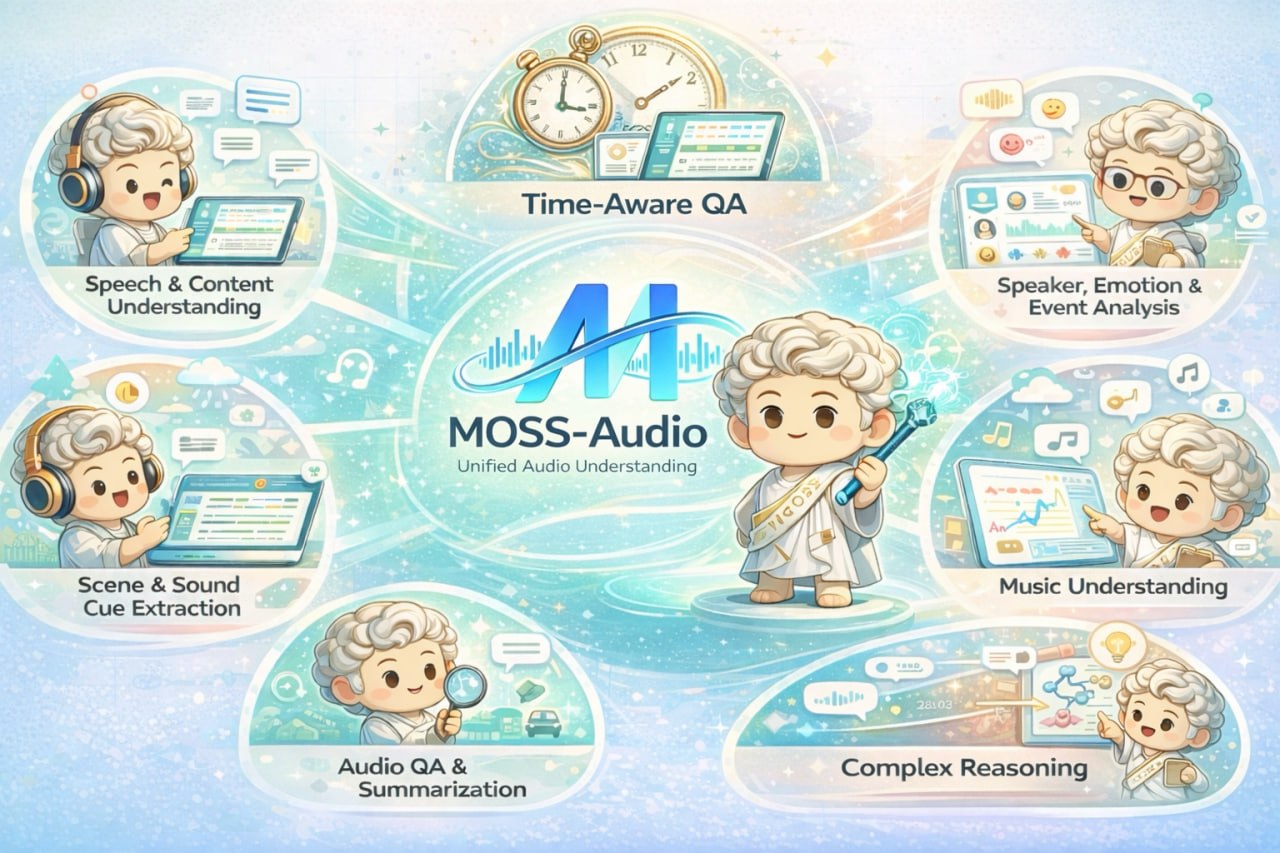
MOSS-Audio: открытая модель для анализа аудио

Н@GreenNeuralRobotsAI-инженер
1 мес
MOSS-Audio: открытая модель для анализа аудио

Claude Opus 5.5 удивил умением превращать код в анимацию, игры и рекламные видео

Anthropic выпустила новую модель Claude Opus 5.5 (релиз 22-23 сентября 2026), и пользователи массово делятся неожиданными творческими способностями модели: она пишет код на Python и JavaScript, который сам рисует картины, генерирует плавную анимацию и моушен-графику, а также создаёт игровые ассеты и уровни в Blender и Unity.

Модель хвалят не только за качество результата, но и за скорость и экономичность: по независимым тестам Artificial Analysisi Opus 5.5 medium набирает те же баллы, что и Astra high, при этом расходует значительно меньше лимитов на подписке Max. Некоторые тестировщики считают Opus 5.5 сильнее GPT-6 Sol и Astra в задачах с играми и анимацией через код.

7500 строккод Python для одной картины
51 баллоценка Opus 5.5 medium и Astra high в Artificial Analysis
2%недельного лимита Max за 1,5 часа работы

Полный разбор →

Ещё ↓