MOSS-Audio: открытая модель для анализа аудио
Н@GreenNeuralRobotsAI-инженер
4 недПредставлена MOSS-Audio — открытая модель для понимания речи, музыки и звуков с поддержкой рассуждений и анализа аудиосцен.
Появление открытых мультимодальных моделей для глубокого анализа аудио расширяет возможности автоматизации обработки звукового контента.
- Позволяет автоматизировать транскрипцию с привязкой ко времени и анализ характеристик говорящего.
- Упрощает классификацию звуковых сцен и музыкальных композиций.
- Интеграция рассуждений (chain-of-thought) позволяет задавать сложные вопросы о содержании аудиофайлов.
MOSS-Audio
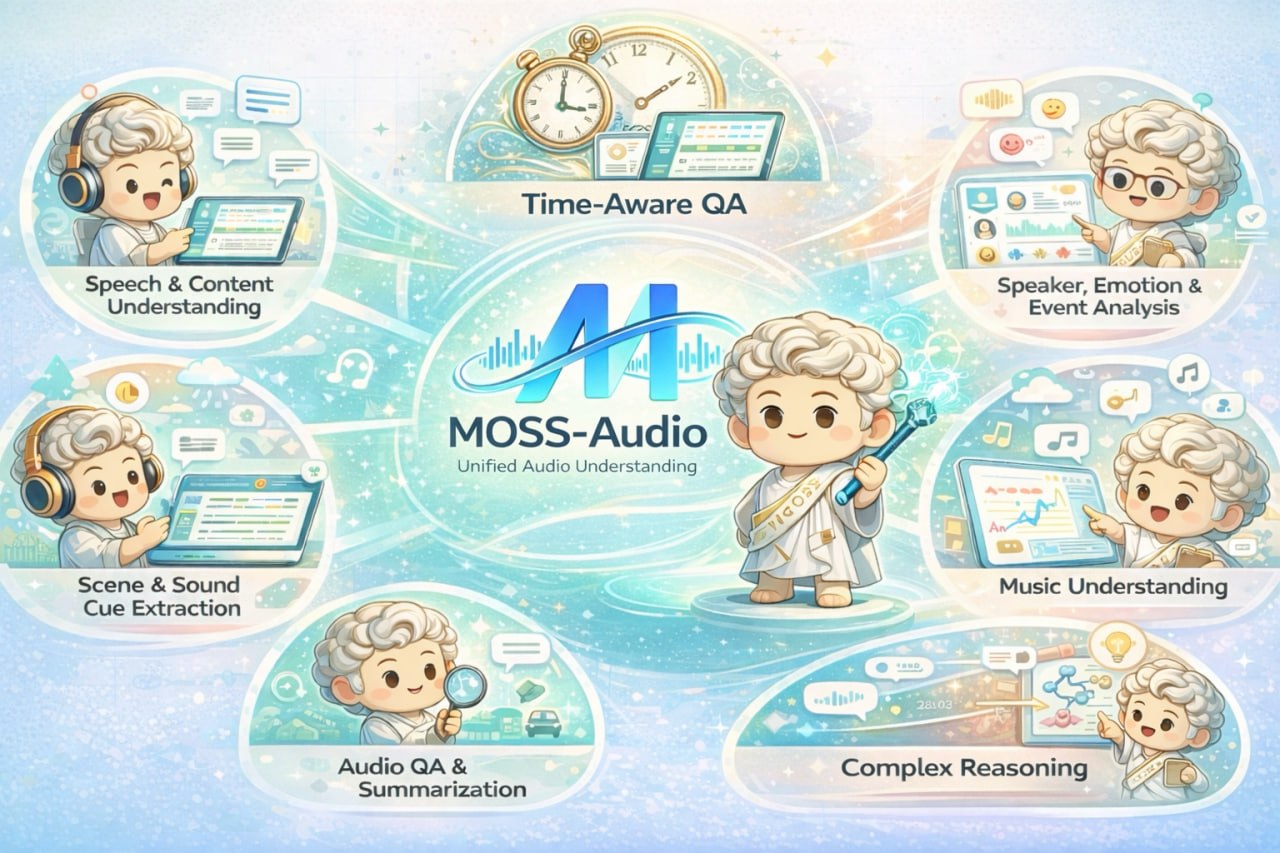
Открытая модель понимания аудио. Понимает речь, музыку, звуки окружения, отвечает на вопросы об аудио и умеет рассуждать по шагам (chain-of-thought). Четыре варианта: 4B и 8B, Instruct и Thinking
• транскрипция речи с таймштами слов и предложений
• анализ говорящего: пол, возраст, акцент, эмоции
• описание сцены по фоновым звукам
• музыка: стиль, инструменты, эмоциональное развитие
• время-ориентированные вопросы - что произошло когда
• свой аудиоэнкодер 12.5 Гц + Qwen3 в качестве языковой базы
• DeepStack - фиче-инъекция от ранних слоев энкодера в LM
• тайм-маркеры вшиты в претрейн - модель учит хронологию
Гитхаб
HF
#alm
MAX
Кратко (AI)
Представлена открытая модель MOSS-Audio, способная анализировать речь, музыку и звуки окружения. Модель поддерживает пошаговые рассуждения и доступна в версиях 4B и 8B, используя архитектуру на базе Qwen3 и специализированный аудиоэнкодер.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖