#Нейропрожарка
Название: Что если бы Томми Шелби сыграл Джейсон Стэтхем
Авторы:
Иван Спиридонов
Дмитрий Иванов
Идея
Реализовали экспериментальный эдит по «Острым козырькам»: заменили Киллиана Мёрфи на Джейсона Стэтхема.
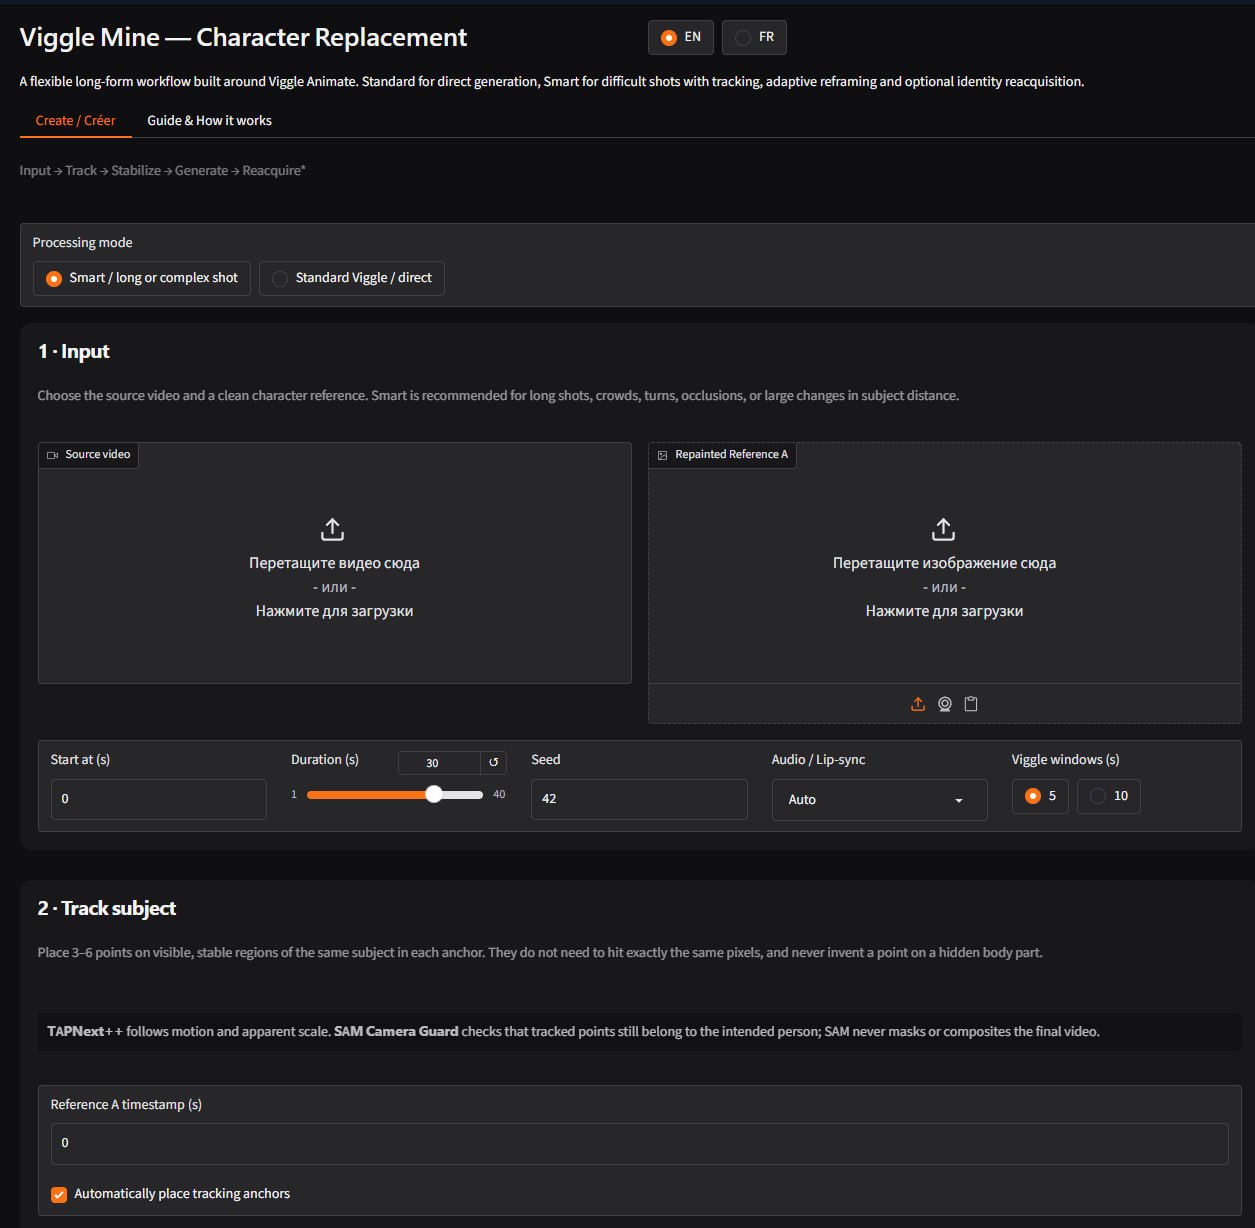
Суть в том, что сначала Стэтхема хотели взять на роль Мерфи и мы решили посмотреть как бы он выглядел в ней. Взяли популярные сцены разной сложности. Для выполнения разработали собственный воркфлоу на Wan Animate и протестировали Minimax H3.
Версия в хорошем качестве
Производство
1. Монтаж и отбор
Смонтировали сцены из сериала — короткие, динамичные, с блюром и тёмным светом. Осознанно взяли несколько заведомо очень сложных шотов.
Спойлер: если бы не своевременный выход Minimax H3, мы бы их удалили
2. Референсы
Можно просто закинуть фото Стэтхема, так проще. Но лучше делать замену прямо на референсном кадре из сцены — тогда animate понимает, как персонаж должен выглядеть в этом свете и гриме. С этим справился только
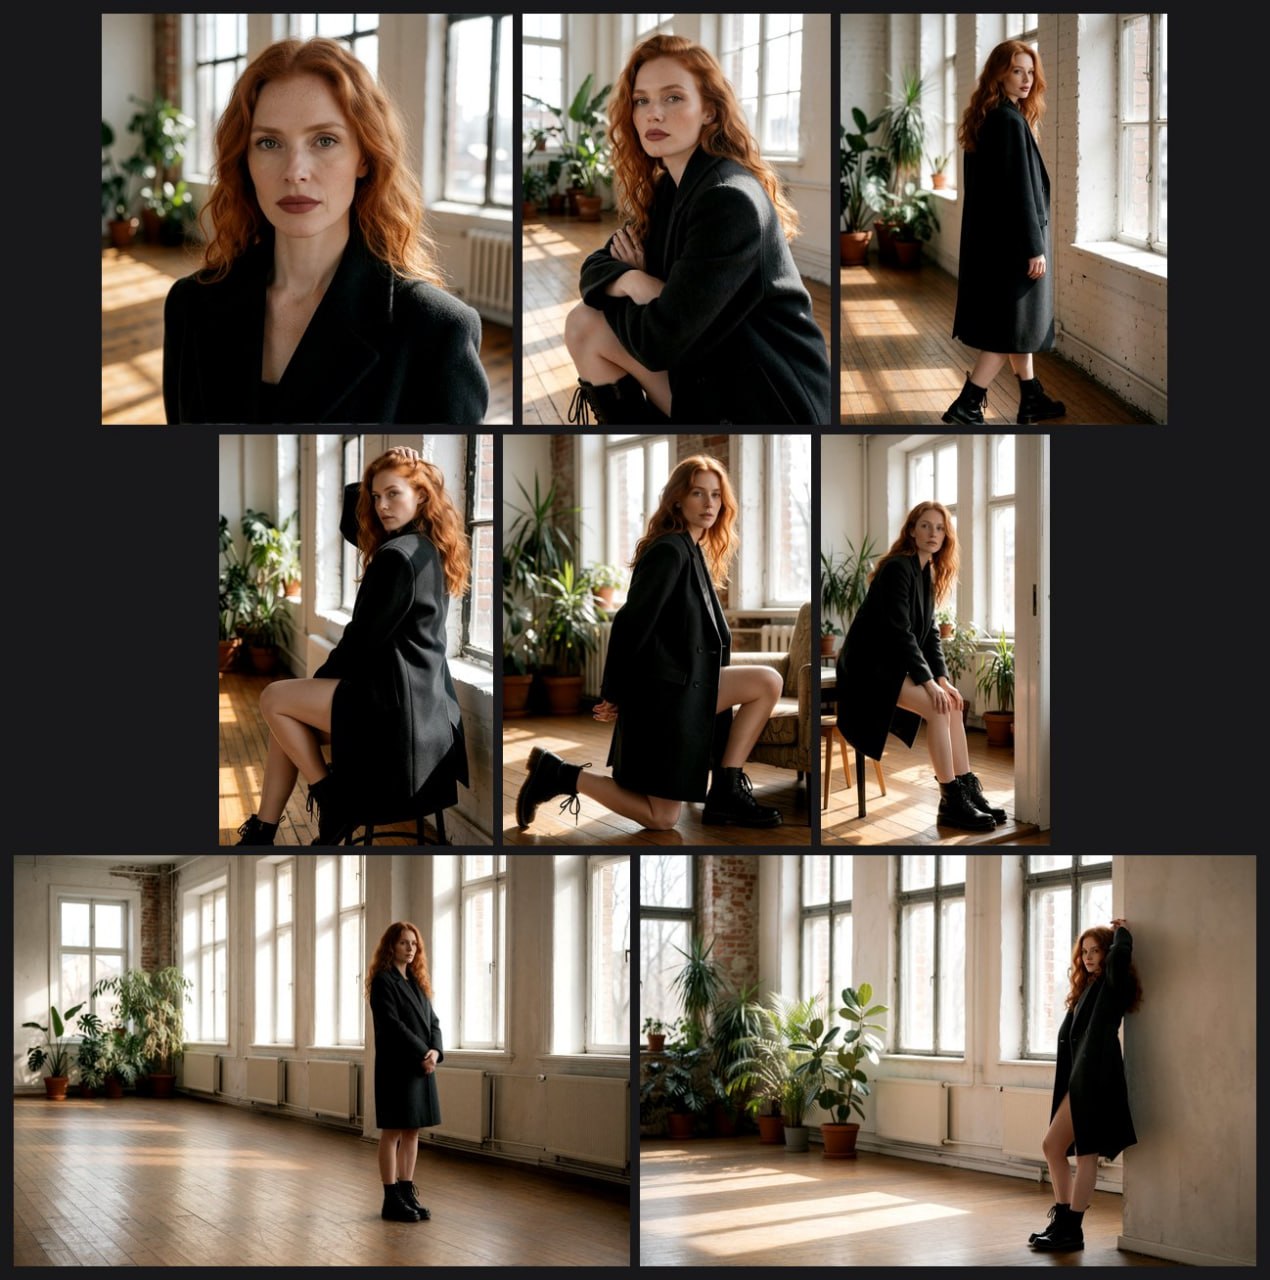
GPT Image 2. Для боковых ракурсов собирали character sheet с разными углами головы и эмоциями (для Minimax)
3. Базовый пайплайн — Wan 2.2 Animate V1 (локально, ComfyUI)
— Маска: в основном автоматом через
SAM3; кадры посложнее размечали в Premiere, самые жёсткие — ротоскоп в
After Effects.
— Кроп кадра по маске, чтобы отдать генерации максимальное разрешение.
— Препроцессоры анализируют позу и мимику. Иногда отдельно записывали себя на видео и переносили эмоции со своего лица — с оригинала мимика часто читается плохо.
— Генерация и анкроп обратно в исходное видео.
— Опционально — цветокор лица под кадр.
Нюансы
4. Где Wan Animate не вывозит
— Перекрытия лица: нет контекста, объекты перед лицом ломают генерацию.
— Микродвижения лица теряются, а именно они дают естественность.
— Иногда уплывает схожесть - лечится генерацией конкретных ключевых рефов.
— Динамика с моушн-блюром и плохим светом: неверно определяются движения и состояние глаз.
— Изменения на лице (кровь, брызги) не анимируются вообще. Текстовый энкодер староват, модель под такое не обучена. FLF-кадры не помогли.
Из-за этого пришлось бы выбросить несколько сцен.
5. Minimax H3 (локальная версия)
Прогнали проблемные шоты через него - и они перестали быть проблемными.
—
Кровь. Точно перенёс кровь с исходного видео на заменённое лицо. Референсы: лицо + свап одного из первых кадров для контроля эстетики.
—
Динамичная сцена в баре. Нужно было объяснить модели, кого именно свапать из толпы. Сделали маску ротоскопом в AE и подали на вход: исходное видео с белой маской на лице + кроп лица (чтобы модель видела поворот и эмоции) + реф лица.
—
Мимика. Движения губ и глаз читаются заметно лучше на многих шотах, Wan Animate это просто не считывал.
—
Углы головы. Как omni-модель ест character sheet целиком. На одном рефе глаза оставались «от Киллиана Мёрфи», на character sheet — уже нет.
— Цензуры на суицидальные и жестокие сцены, оружие и авторские права нет.
6. Сравнение с сервисами
Kling 3.0 Omni Edit: в сцене с выстрелом ловим NSFW; в сцене с кровью из носа результат чище, но сама кровь выглядит крипово.
Ни один другой сервис эти шоты бы не пропустил — пистолеты, актёры, жестокость, кровь.
7. Минусы Minimax H3
— Шаг в 17 кадров против 4 у Wan. Собрали небольшой блюпринт в ComfyUI, который дописывает кадры в конец, чтобы выход точно совпадал с исходником по таймингам, — иначе модель догенерирует и растянет контент.
— Нет маскинга. С маскингом нередактируемая часть видео не меняется по качеству и цвету, нет сдвигов по таймингам и объектам, плюс открывается композитинг. Очень ждём нативную поддержку у omni-моделей.
— Отсюда же общее ухудшение качества всего кадра даже на прогоне в 1080p.
Время выполнения: 2 недели
Затраты: 0р. Все выполнялось локально в нашем случае.
Железо: 5070ti/4080 16gb + 64gb озу
@cgevent