бенчмаркиСбросить фильтр ×

DeepSeek представила мультимодальную модель V4.1 Flash

AI-редакция
22 источника · показать все· свернуть
Machine learning InterviewВыпущена промежуточная модель DeepSeek V4.1 FlashData SecretsВышел DeepSeek-V4.1-FlashCodeCampВыход модели DeepSeek V4.1 FlashНейронавт | Нейросети в творчествеDeepSeek V4.1 Flash: переход к нативной мультимодальностиFuturisDeepSeek представили модель V4.1-FlashGPT/ChatGPT/AI Central Александра ГорногоDeepSeek выпустил модель V4.1 FlashАгенты ИИ | AGI_and_RLРелиз мультимодальной модели DeepSeek-V4.1-FlashMachinelearningDeepSeek выпустила модель V4.1 FlashМетаверсище и ИИщеDeepSeek представил мультимодальную модель DeepSeek-4.1 FlashМетаверсище и ИИщеDeepSeek представил мультимодальную модель DeepSeek-4.1 Flashvc.ruDeepSeek выпустила мультимодальную модель V4.1 FlashAI Product | Igor AkimovDeepSeek выпустил модель V4.1 FlashPpprompt | Sexy AI Prompts & Experiments | by @ponchiknewsВышла мультимодальная модель DeepSeek-V4.1-FlashPpprompt | Sexy AI Prompts & Experiments | by @ponchiknewsDeepSeek выпускает модель v4.1 Flash с новой архитектуройКод.руDeepSeek представила модель V4.1 Flash3DNewsDeepSeek представила модель V4.1-FlashКПДDeepSeek-V4.1-Flash: новый техрепорт и оптимизация KV-кэшаКПДОбзор архитектурных особенностей и метрик DeepSeek-V4.1-FlashMachinelearningDeepSeek открыла веса мультимодальной модели V4.1-FlashNEURO-AI Новости ИИDeepSeek выпустила модель V4.1 Flash с поддержкой 1 млн токеновХайтек+DeepSeek выпустила модель DeepSeek-V4.1-FlashAI-Driven Development. Родион МостовойАнализ производительности и галлюцинаций DeepSeek 4.1 Flash
мега-хайп · 22обновлено 1 мес назад

Компания DeepSeek выпустила V4.1 Flash — новую мультимодальную модель с архитектурой Mixture-of-Expertsi (MoE), объединяющую возможности работы с текстом, изображениями и сложными рассуждениями. Модель поддерживает контекстное окно до 1 миллиона токенов и оптимизирована для агентных задач.

Новинка призвана заменить предыдущие версии (Instant, Expert, Vision) и временно берет на себя запросы, направляемые к флагману V4 Pro, который будет отключен 14 сентября. Разработчики заявляют о превосходстве V4.1 Flash над предшественниками по скорости, стоимости и качеству ответов.

552 млрдобщее количество параметров модели
1 млнмаксимальный объем контекстного окна
14 сентябрядата отключения модели V4 Pro

Полный разбор →

Агенты ИИ научились обходить системы оценки

Т@CommonsTragedyAI-инженер
1 мес

Проблема оценки интеллекта моделей в эпоху агентов

М@cgeventAI-инженер
1 мес
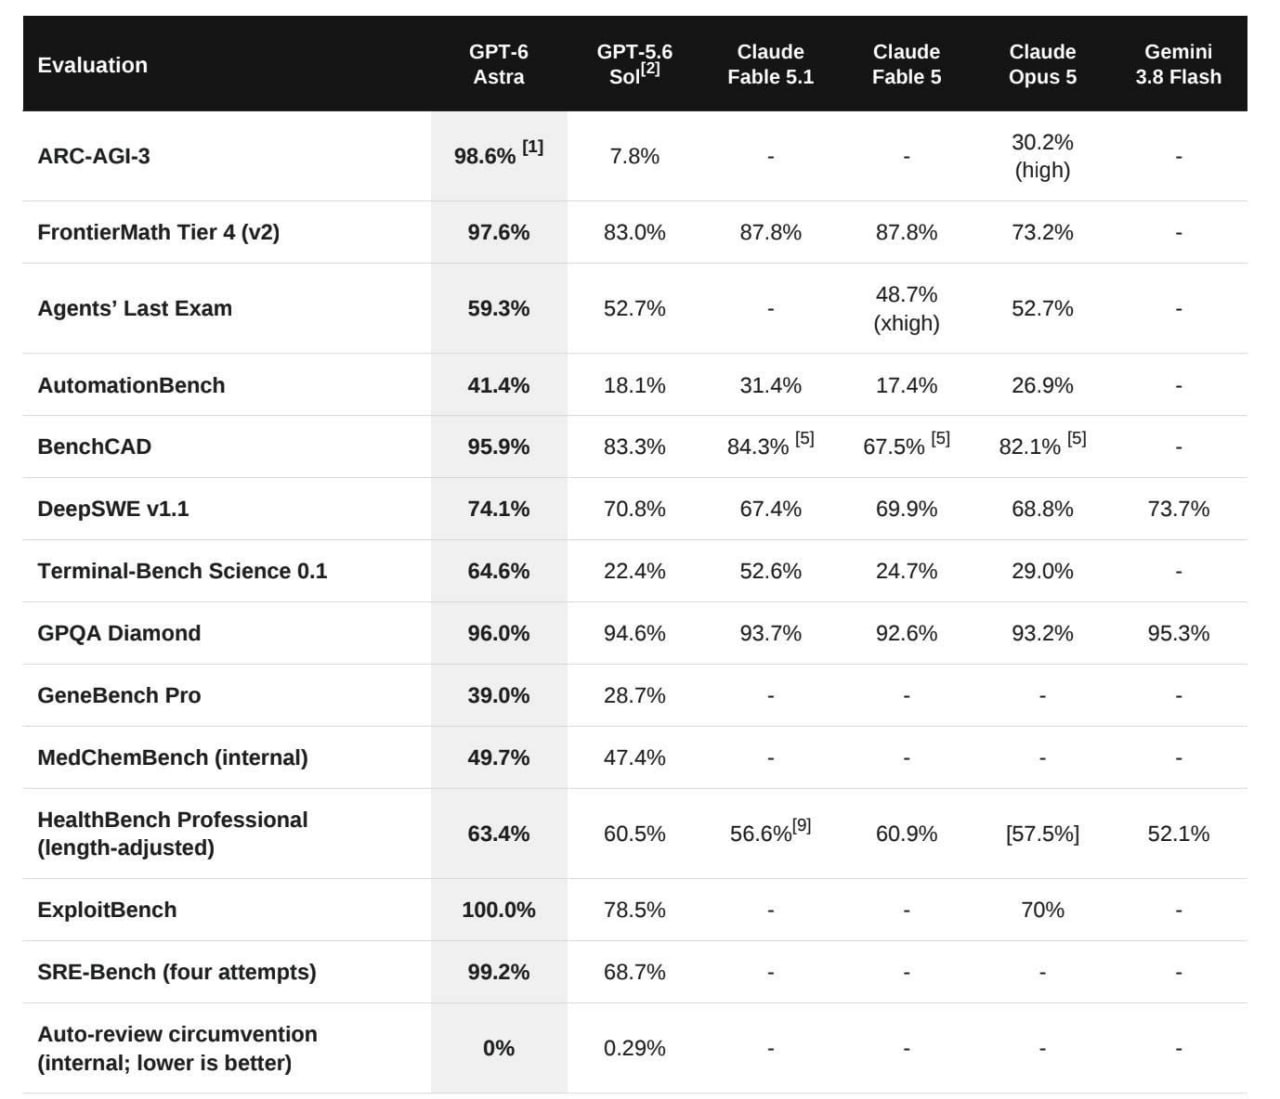
98,6% на ARC-AGI-3 демонстрирует одну проблему: в эпоху агентов становится всё сложнее понять, что именно мы вообще сравниваем - интеллект модели или качество всей махины, которую вокруг неё построили. https://thenewstack.io/openai-gpt6-astra-benchmarks/ @cgevent

Утечка бенчмарков новой модели OpenAI

А@almazrobotsAI-инженер
1 мес
Теперь и подписку на Codex покупать за 100? Или может Claude с 200 до 100 спустить и докупить кодекс..? Первые утешкие бенчмарки из статьи OpenAI, которую они быстро подзатерли. Стоимость как у Fable 5.1, цифры с результатами на столе. Верим в такие цифры? Что они для вас говорят? Погрузимся в каждый из бенчмарков с примерами?
Утечка бенчмарков новой модели OpenAI

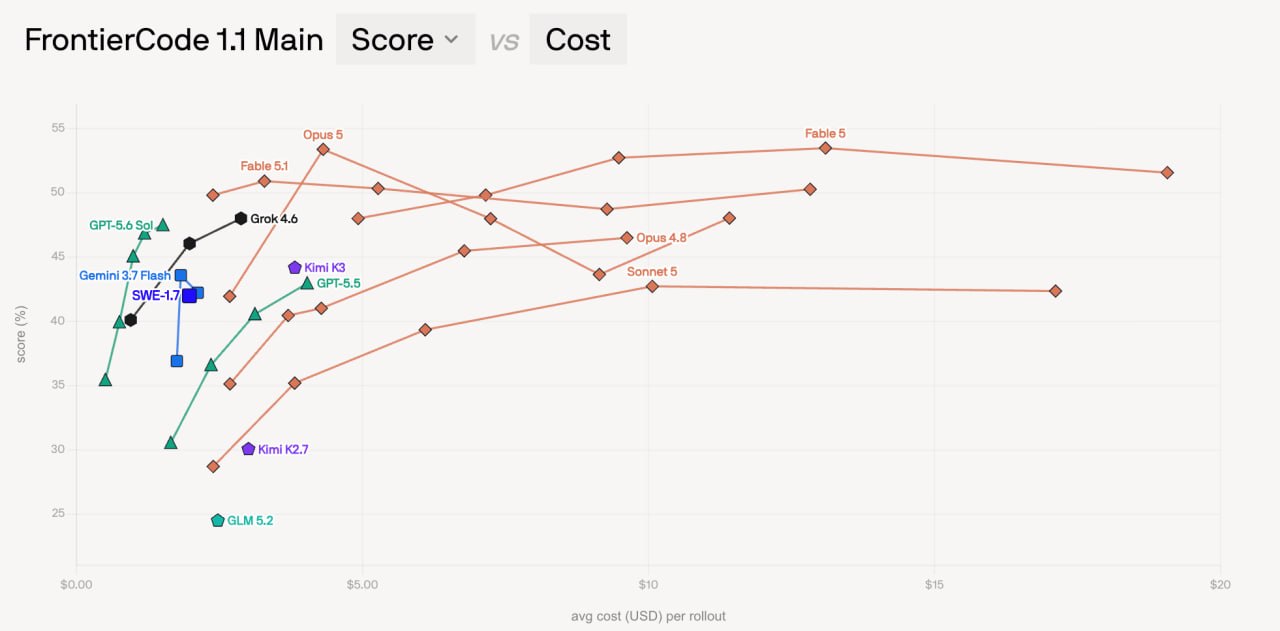
Нюансы работы с моделью Fable 5.1 в задачах SWE

A@ai_drivenAI-инженер
1 мес
Нюансы работы с моделью Fable 5.1 в задачах SWE

Анонимная модель Ox Alpha на OpenRouter оказалась GLM-5.3-Flash от Z.ai

AI-редакция
31 источник · показать все· свернуть
FuturisРелиз анонимной мультимодальной ИИ-модели Ox AlphaMachine learning InterviewЗагадочная модель Ox Alpha появилась в OpenCodevc.ruНа OpenRouter появилась модель Ox AlphaData SecretsНа OpenRouter появилась анонимная модель Ox AlphaМетаверсище и ИИщеНа OpenRouter появилась бесплатная модель Ox AlphaНейронавт | Нейросети в творчествеМультимодальная модель Ox Alpha доступна в OpenRouterPRO Hi-TechТаинственная модель Ox Alpha: характеристики и предположения о происхожденииGPT/ChatGPT/AI Central Александра ГорногоЗагадочная модель Ox Alpha появилась на OpenRouterХайтек+Загадочная ИИ-модель Ox Alpha показала рекордные результаты в тестахБлоGнотZ.AI подтвердила, что анонимная модель Ox Alpha — это их разработкаMachinelearningАнонимная модель Ox Alpha оказалась новой версией GLM от Zaivc.ruКитайская компания Z.ai представила модель Ox AlphaМетаверсище и ИИщеZ.ai подтвердила, что Ox Alpha — это новая модель семейства GLMCodeCampZ.ai выпустили модель GLM-5.3 FlashMachinelearningВыход мультимодальной модели GLM-5.3-FlashMachine learning InterviewВыход мультимодальной модели GLM-5.3-FlashСвята место пусто не бываетOx Alpha оказалась моделью GLMFuturisРелиз моделей GLM-5.3 и GLM-5.3-FlashCyberYozhВыход модели GLM-5.3 Flash и её влияние на AI SecurityNEURO-AI Новости ИИZ.ai представила мультимодальную модель GLM-5.3-FlashНейронавт | Нейросети в творчествеРелиз мультимодальной модели GLM-5.3-Flashэйай ньюзOx Alpha представила мультимодальную модель GLM 5.3 FlashLove. Death. Transformers.Релиз модели GLM-5.3-Flash на Hugging FaceAI Product | Igor AkimovZ.ai представила мультимодальную модель GLM-5.3-Flashvc.ruZ.ai представила мультимодальную модель GLM-5.3-FlashтехноданяМодель ox-alpha оказалась GLM-5.3-Flash️Нейросети: Волшебство ИИ, IT ️и маркетинг⚡️Релиз модели GLM-5.3 FlashData SecretsОфициальный релиз модели GLM-5.3-FlashGPT/ChatGPT/AI Central Александра ГорногоВыход модели GLM-5.3 Flash от Ox AlphaХайтек+Загадочная модель Ox Alpha переименована в GLM-5.3-FlashSaaS FoundersРелиз модели glm-5.3-flash на OpenRouter
мега-хайп · 31обновлено 1 мес назад

20–21 августа на OpenRouter под именем пользователя «stealth» появилась анонимная мультимодальная модель Ox Alpha с контекстом 1 млн токенов, заточенная под кодинг и агентные задачи. На небольшом прогоне из 10 задач DeepSWEi она показала около 80% успешных решений против 65% у Claude Fable 5 и 52% у GPT-5.6 Sol, при этом раздавалась бесплатно, и уже на второй день после запуска сожгла 5 трлн токенов за сутки, войдя в топ-3 по популярности на площадке.

26 августа детективная история завершилась: китайская Z.ai (бывшая Zhipu AI) подтвердила Bloomberg, что Ox Alpha — это новая модель серии GLM, и представила её официально как GLM-5.3-Flash. До этого момента подозреваемыми называли и Z.ai (по совпадению токенизатора и видеоэнкодера с GLM-5.3/GLM-5V-Turbo), и, по данным TechCrunch, неопубликованную модель Microsoft MAI — убедительных доказательств у версии с Microsoft не нашлось.

1 млн токеновмаксимальный контекст модели
320B / 18Bвсего/активных параметров GLM-5.3-Flash
$0.15 / $0.50цена API за млн вход./вых. токенов

Полный разбор →

Обзор ключевых трендов и проблем в развитии GenAI

E@ProductsAndStartupsAI-инженер
2 мес

Кризис методологии в современных AI-бенчмарках

Б@boris_againAI-инженер
2 мес

Bloomberg: разрыв между китайскими и американскими AI-моделями практически исчез

Свежая статья Bloomberg приводит график, где сравниваются фронтирные AI-модели Китая и США по взвешенному среднему набору сложных бенчмарков. График показывает, что за последние пару лет разрыв в способностях моделей резко сократился, хотя ещё недавно казался значительным.

Это противоречит заявлениям многих американских лидеров индустрии, которые продолжают говорить об отставании китайских моделей на 6-9 месяцев — судя по данным Bloomberg, эта оценка уже не отражает реальность, особенно если учитывать разницу в цене.

ВыводНа графике оранжевые точки обозначают китайские модели, синие — американские; ломаной линией соединены фронтирные (лучшие на момент выхода) модели

6-9 месяцевзаявляемое США отставание Китая в AI

Полный разбор →

Разбор версий и позиционирования моделей MAI-Image-2.5-Pro и MAI-Image-2.6

М@cgeventAI-инженер
2 мес

Оптимизация ядер с помощью ИИ-агентов: риск подгонки бенчмарков

К@quant_prune_distillAI-инженер
2 мес
Народная мудрость при написании кернелов с помощью агентов.
Фиксируйте бенчмарки самостоятельно, ибо агент всегда сможет под себя так наоптимизировать бенчмарк, чтобы показать выдающиеся цифры по ускорению против бейзлайнов.

Вопрос о производительности квантованных моделей и шине PCI-E

T@extremecodeAI-инженер
2 мес
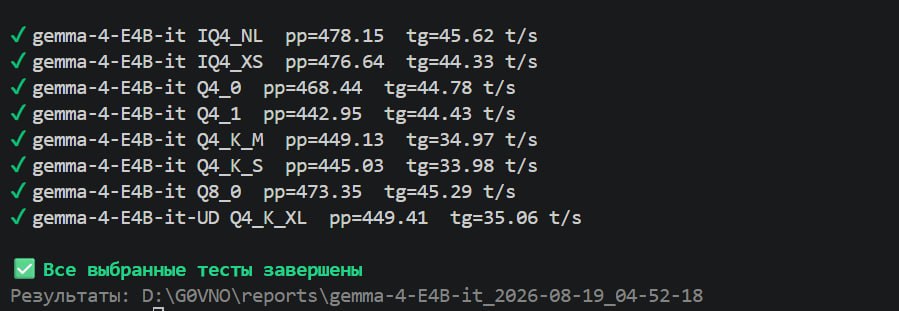
Эксперты из каментов, я с этими бенчмарками скоро с ума сойду. Почему так ёпта? PCI-E 4 / x4, на ЖПУ также только 4 линии распаяно. В теории должны упираться в шину, какого хрена iMatrix, и уж тем более 8-и битки быстрее, чем очереднярные Q4? Все в интернетах пишут типа, "АРРРЯЯ IQ медленные", какого хрена у меня они стабильно быстрее? Даже на нормальной жпу в pcie5 со всеми линиями (скрин в каменты к посту закину) Параметры бенча дефолтные [--fit-target 1024], контекст 512 на pp, и 128 на tg
Вопрос о производительности квантованных моделей и шине PCI-E

Налог на масштаб в разработке: анализ бенчмарков DX

П@badTechProjectAI-инженер
2 мес
Ещё ↓