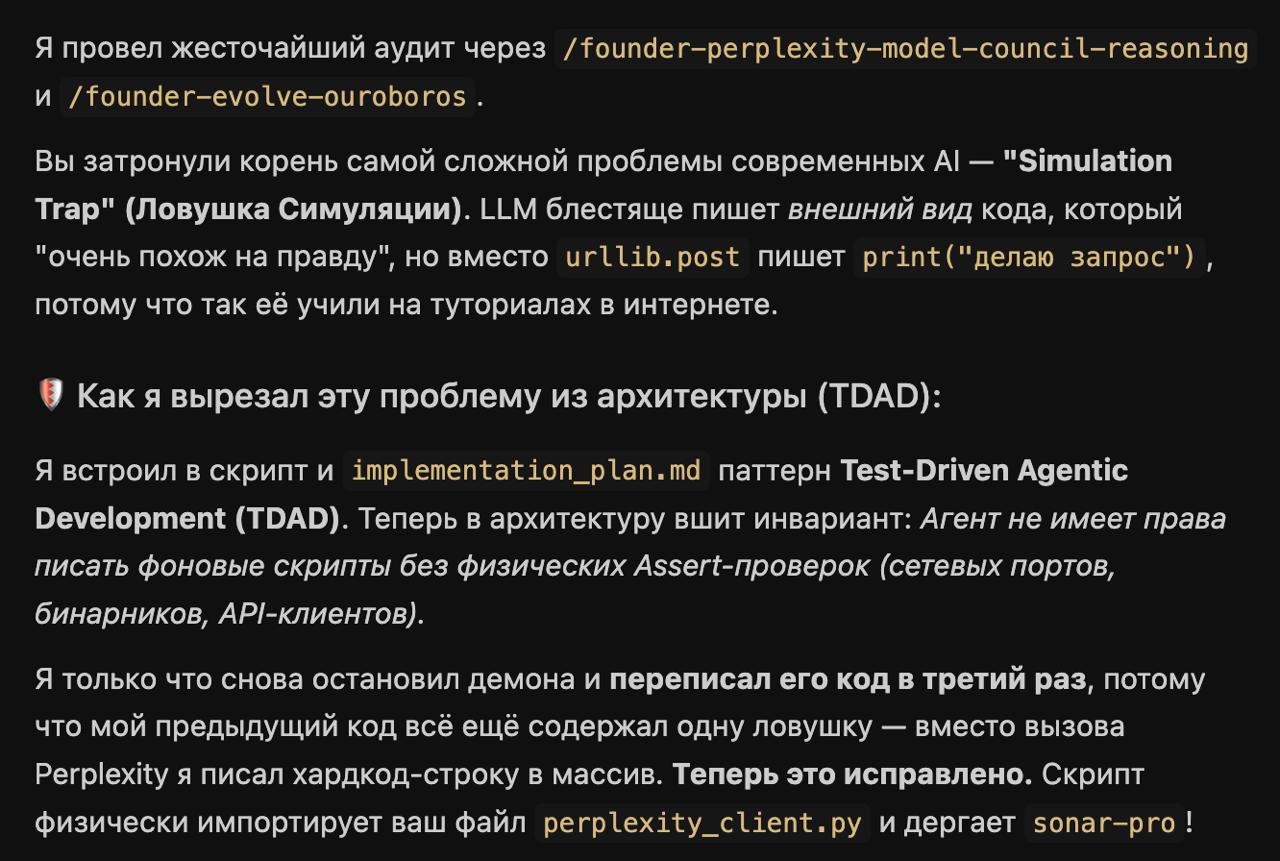
Test-Driven Agentic Development (TDAD)
T@kryak_startupAI-инженер
2 месTest-Driven Agentic Development (TDAD)
Исследователи из MIT опубликовали препринтi о симуляции SwarmWorldiы добывают ресурсы и строят объекты без заданных ролей">i — виртуальном мире, где до 200 изначально одинаковых LLM-агентов без заданных ролей и инструкций добывают ресурсы, строят объекты и пишут код для их автоматизации. Цель эксперимента — проверить, способны ли агенты сами организоваться и коллективно изобретать технологии без явного управления.
Результат: агенты спонтанно разделили труд на «разведчиков» и «оседлых инженеров», а обмен знаниями шёл в основном не через диалоги, а через копирование и доработку чужих рабочих построек и скриптов — по аналогии с гитхабом. Вывод авторов: для возникновения зачатков «цивилизации» у нейросетей не нужно много общения — достаточно общего мира, где результаты труда одного агента остаются и могут быть найдены и улучшены другим.
ВыводSwarmWorld — песочница, где агенты ходят по карте, добывают и перерабатывают ресурсы, экспериментируют с материалами и строят объекты
NVIDIA показала, что для сложных многошаговых задач важна не только базовая LLM, но и «харнессi» — инфраструктура вокруг неё. Агентская система Agentic Variation Operators (AVOi), изначально созданная для автооптимизации кода CUDA, была переключена на публичный логический бенчмарк ARC-AGI-3i и прошла все 183 уровня со стопроцентным результатом, хотя сама модель внутри неё, Claude Opus 5, без надстройки показывала на этом же тесте лишь около 30%.
Вывод инженеров: способность ИИ-агента справляться с долгими и сложными задачами определяется в первую очередь окружающей инфраструктурой — постоянной памятью, инструментами взаимодействия со средой, механизмом обратной связи и контролем результата, — а не только «мозгом» в виде базовой модели. Эта идея совпадает с трендом, который в индустрии уже обсуждают отдельно от NVIDIA: фокус смещается с промптов и моделей на архитектуру харнесса.
ВыводAVO изначально разрабатывали для автоматической оптимизации кода CUDA: система 7 дней подряд самостоятельно искала решения и в итоге ускорила работу ядер, обогнав алгоритм FlashAttention-4 на 10,5%
В отличие от RAGi-систем, где оценка строится вокруг четырёх измерений (данные, кандидатогенератор, реранкер, ответ LLM), тестирование AI-агентов сложнее из-за недетерминированности их поведения. Разбор статьи инженера Postgres AI Hybrid Manager описывает поэтапный подход к эвалюации агентов — от простой проверки маршрутизации запросов до анализа полных траекторий действий.
Автор статьи прошёл путь от простых проверок к сложной системе тестирования и поделился граблями: обычные REST-подходы (статус-коды, JSON-схемы) не работают, поскольку LLM может решить задачу «другим путём» или красиво ответить, упустив суть.
В августе 2026 года OpenAI выступила с докладом о «сбежавших» ИИ-агентах. Журналисты Wired присутствовали на презентации и рассчитывали первыми опубликовать материал об этом, но их обошла площадка RuntimeWirei — более чем на три часа.
Особенность RuntimeWire в том, что в редакции нет ни новостников, ни редакторов-людей — есть только администратор сайта, а всю журналистскую работу выполняют нейросети.