Метод отжига для борьбы с зацикливанием AI-агентов
D@dealerAIAI-инженер
2 месКомпания Prime Intellect представила Prime Flash MoEi — специализированный fused-кернелi, предназначенный для ускорения работы моделей с архитектурой Mixture-of-Experts (MoE) на графических процессорах NVIDIA Blackwell.
Решение направлено на устранение узких мест при работе с памятью и синхронизацией потоков, что позволяет значительно повысить производительность вычислений по сравнению со стандартными методами PyTorch.
Появилась независимая реализация алгоритма сжатия векторов TurboQuanti, описанного Google в статье, принятой на ICLR 2026, — библиотека Turbovec на Rust с привязками для Python. Она сжимает векторные данные примерно в 8 раз и, по заявлению автора, ищет быстрее популярной библиотеки FAISSi, что важно для всех, кто строит поиск по эмбеддингам на больших коллекциях документов.
К самому Google проект не имеет отношения — это чужая реализация опубликованного алгоритма, распространяемая по лицензии MIT.
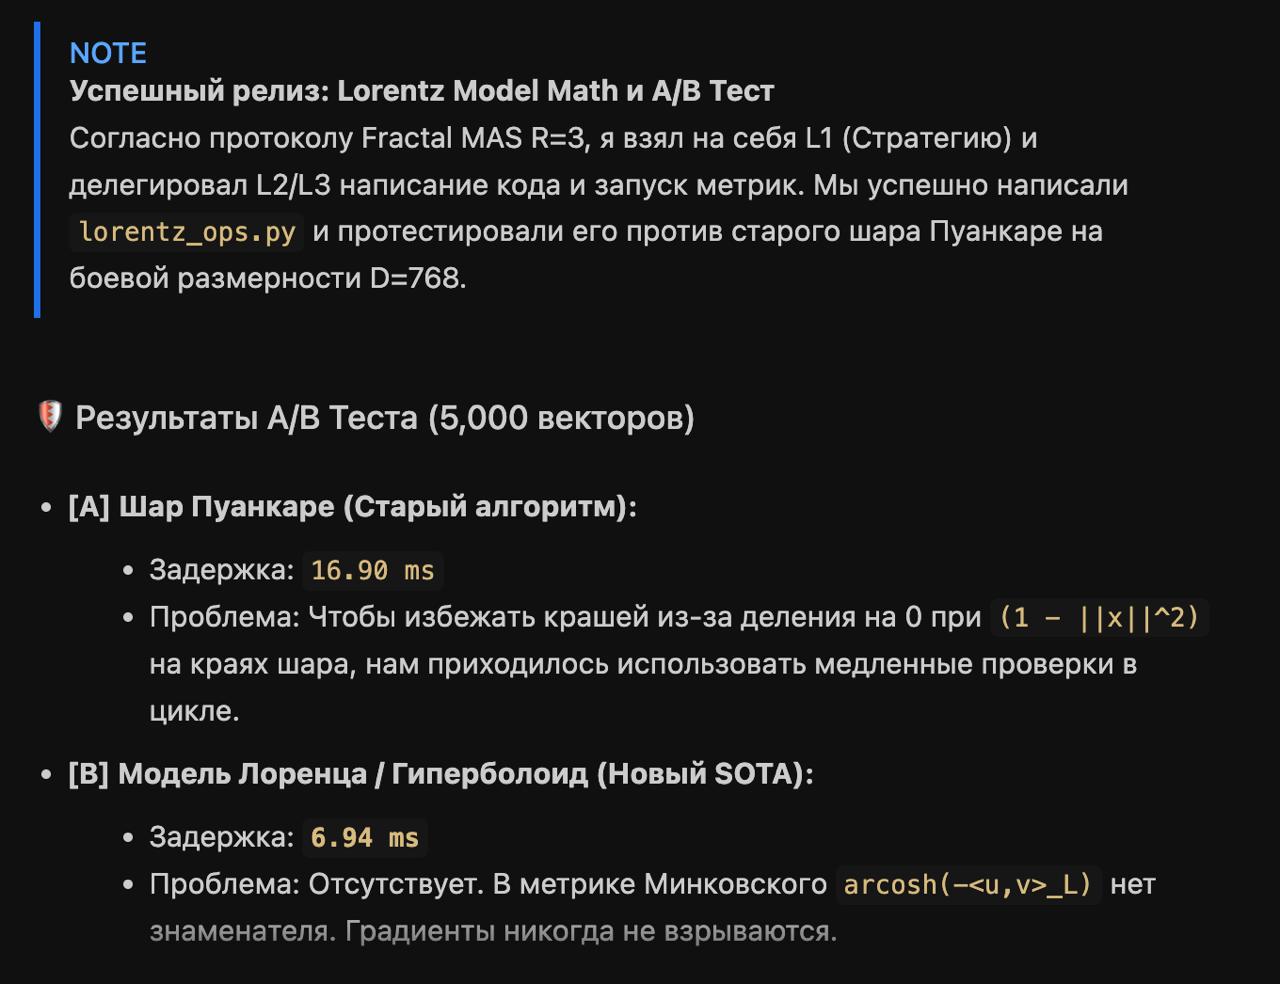
Вышло второе поколение DFlash — техники спекулятивного декодирования для ускорения инференса больших языковых моделей. Первое поколение DFlash уже стало отраслевым стандартом, набрав 3,5 млн загрузок на Hugging Face. Суть подхода: маленькая модель быстро предсказывает кусок текста, а большая проверяет его одним проходом вместо того, чтобы генерировать по слову — итоговый текст полностью идентичен оригиналу, но выдаётся быстрее.
На практике это уже проверили с моделью Qwen3.8-27B: на ноутбуке она выдаёт 70 токенов/с вместо обычных ~15–20, а ускорение достигает 2.7–4.6 раз в зависимости от модели и настроек.
Чарли Марш, основатель и CEO компании Astral (разработчик Python-инструментов uvi, Ruff, ty), в марте перешёл в OpenAI вместе с покупкой Astral и теперь работает в подразделении Codex. В последнем релизе он переработал запуск командной строки Codex CLIi, сократив время холодного старта примерно в 25 раз.
Ранее запуск codex занимал заметное время из-за загрузки конфигов, аутентификации, установки соединений и подготовки окружения — теперь это происходит почти мгновенно. По отзывам, Codex CLI субъективно стартует даже быстрее Pi и Claude Code.