Китайцы выкатили свой ИИ-телефон - и пока это лучшее, что есть на этой поляне
Вот уже года два-три - как только все осознали, что ИИ с нами всерьёз и надолго - все обсуждают, каким будет новый ИИ-телефон. Чем он будет отличаться от Айфона или обычного Андроида? Будет ли вообще отличаться? Это вообще будет телефон, или что-то другое? Много вопросов.
Пока все ответы были невнятные. OpenAI сначала
захотела сделать какую-то безэкранную хренотень, а потом от них же
ходили слухи про тотально агентный телефон вообще без приложений. Amazon
делал ставку на ИИ-дамфон, который будет дополнять обычный смартфон. Про эйай пины, рэббиты и прочие разные ИИ-кисточки для пупка и агентные дилдаки я вообще молчу 😈
Положа руку на сердце, пока все попытки выглядели не особенно убедительно. И вот в игру вступают китайцы:
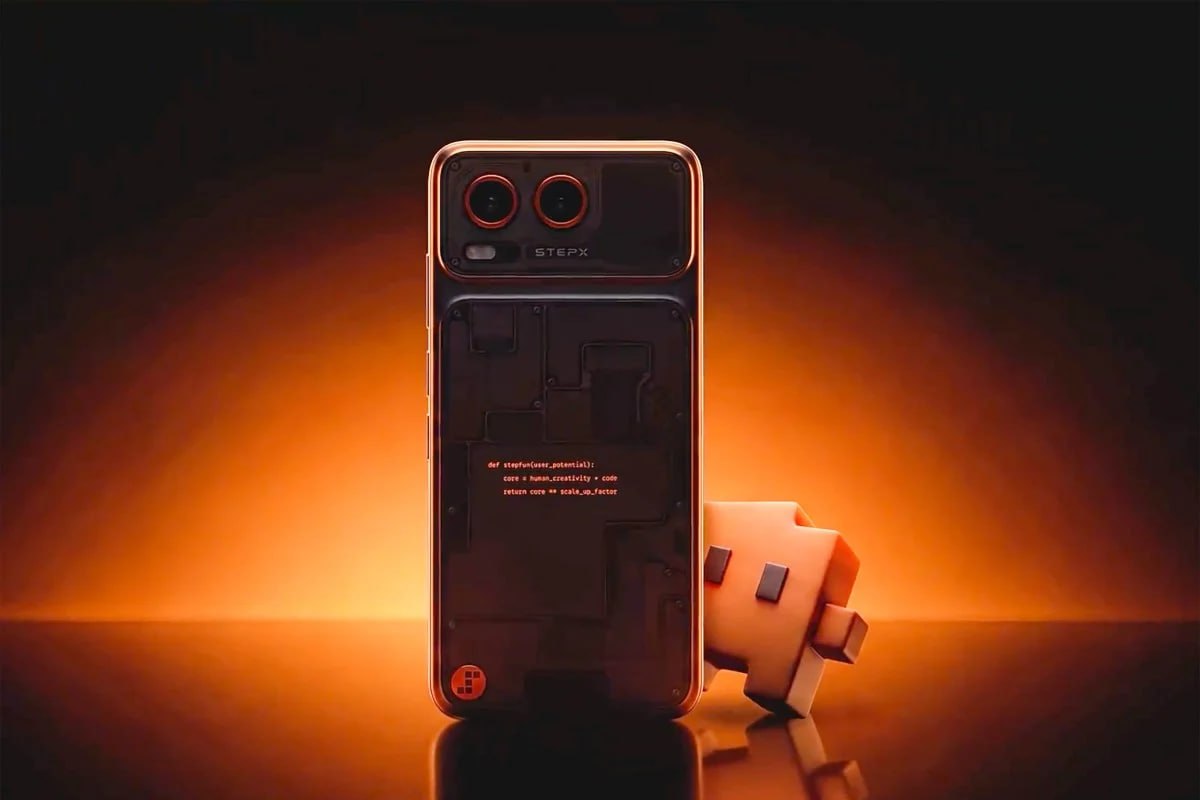
Их телефон
называется StepXNeo. Его делает стартап StepFun. Компания запущена в 2023 году, основатель - бывший вице-президент Microsoft. Вообще, чуваки делают собственные LLM, которые уже активно работают в железе Oppo, Geely и т.д. То есть, это не хайпожорная пустышка, у них есть реальный софтовый и эйай-стек. Но теперь они решили собрать готовое устройство.
StepXNeo - это полноценный смартфон. У него есть экран, звонки, 5G, две камеры и всё остальное, что обычно бывает у телефонов. Приложения тоже физически на месте, тапать пальчиком по иконкам никто не запрещает. Но есть минимум два больших отличия:
Во-первых, ОС. Она у них своя, называется "Step AOS". Это некий гибрид из кусков Android, Linux и RTOS, специально собранный под агентные сценарии. RTOS = операционная система реального времени, то бишь ОС с фокусом на время выполнения операции (для агентов это важно, иначе они иногда будут уходить в раздумья на минуты, и пользоваться будет нереально).
То есть, у StepX агентность вшита прямо в фундамент системы, а не прикручена где-то сбоку отдельным приложением.
Во-вторых, хотя приложения физически есть, и можно нажимать кнопки - точка входа задумана другая. И над этим тоже поработали основательно. Вместо домашнего экрана тут разговор с агентом Amoo. А с ключевыми китайскими сервисами - Alipay, Meituan, Didi, JD, Trip и т.д. - StepFun либо вошёл в прямое партнёрство, либо планирует это сделать. Они сами отдают агенту Amoo свои внутренние функции через MCP. То есть, агент будет общаться с ними на своём родном языке, а не симулировать кожаный палец.
Для остальных приложений (где нет прямого партнёрства) работает визуальная модель Step Edge на 4 млрд параметров. Вот она уже смотрит на экран и тыкает кнопки, да. Но обещают, что этот момент тоже проработали и будет работать лучше, чем в костылях - ну, поживём-увидим.
Ценник пока не называли, но инсайдеры и эксперты дают навскидку порядка $1000, это премиальный сегмент. То есть, чуваки явно целятся не во "второй телефон" или нишевую ИИ-игрушку, а в полноценную замену главного гаджета.
Пока сложно сказать, насколько такой формат будет востребован (прецедентов не было, прогнозы не на чем строить). Но из всех попыток сделать ИИ-телефон - эта, пожалуй, самая полноценная.
Алексей текст менять запрет. Миска рис получать на Xiaomi. Для кошкожена выпускать ещё 3 пост про великий устройства Китай
Дизраптор