llmСбросить фильтр ×

Обновление Rus-GPT-agent: новые модели и расширение бесплатного доступа

В@vitaly_kuliev_itAI-инженер
2 мес
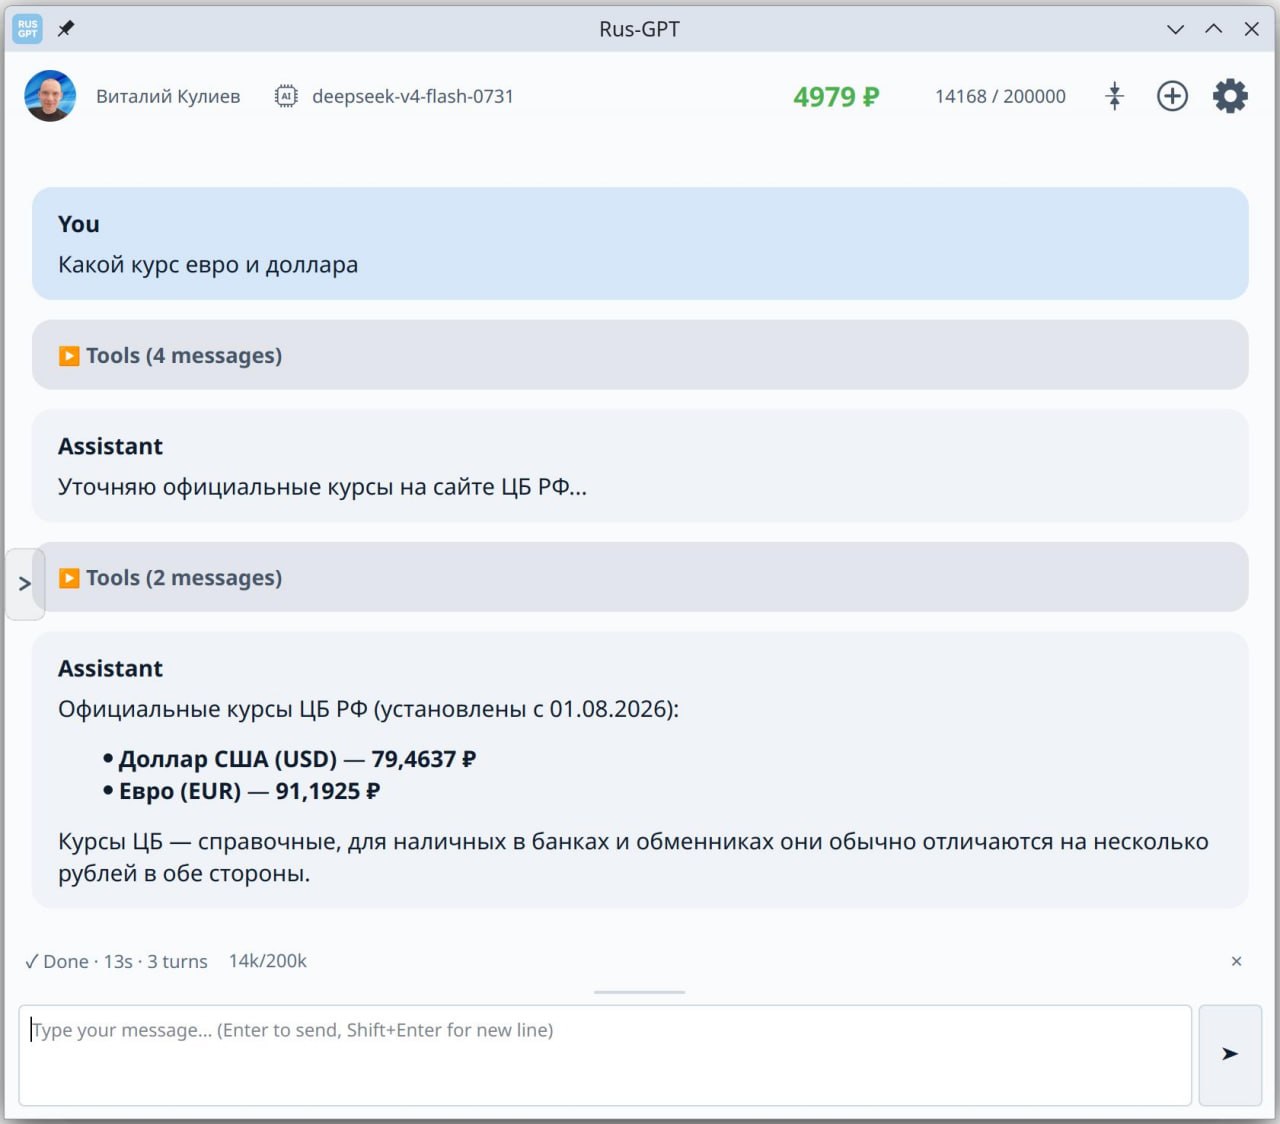
🚀 Новая версия Rus-GPT-agent Изменения и улучшения: 1. deepseek/deepseek-v4-flash-0731 теперь является моделью по умолчанию для API. По внутренним тестам обновленная модель deepseek лучше работает на сложных случаях, лучше комбинирует несколько инструментов. 2. qwen3.6-35b-a3b доступна на бесплатной подписке всем пользователям. Лимиты бесплатного доступа увеличены. 3. Исправлен баг для windows пользователей с запуском Chromium в фоне. 4. Повышена стабильность работы Спасибо всем, кто пользуется и предлагает улучшения. https://rus-gpt.com/agent
Обновление Rus-GPT-agent: новые модели и расширение бесплатного доступа

Дайджест публикаций за 27 июля — 2 августа 2026

Х@habr_comмедиа / агрегатор
2 мес
На прошедшей неделе мы притворялись джунами ради оффера, скармливали компилятору трюки из 90-х, разбирали по винтикам скам на Авито, хоронили половину сеньорского опыта под LLM и выясняли, кому на самом деле доставались деньги от изобретений IBM. 📝 Лучшие публикации недели (27 июля — 2 августа 2026) #weeklydigest
Дайджест публикаций за 27 июля — 2 августа 2026

Мини-гайд по оркестрации AI-агентов для разработки

E@ProductsAndStartupsAI-инженер
2 мес

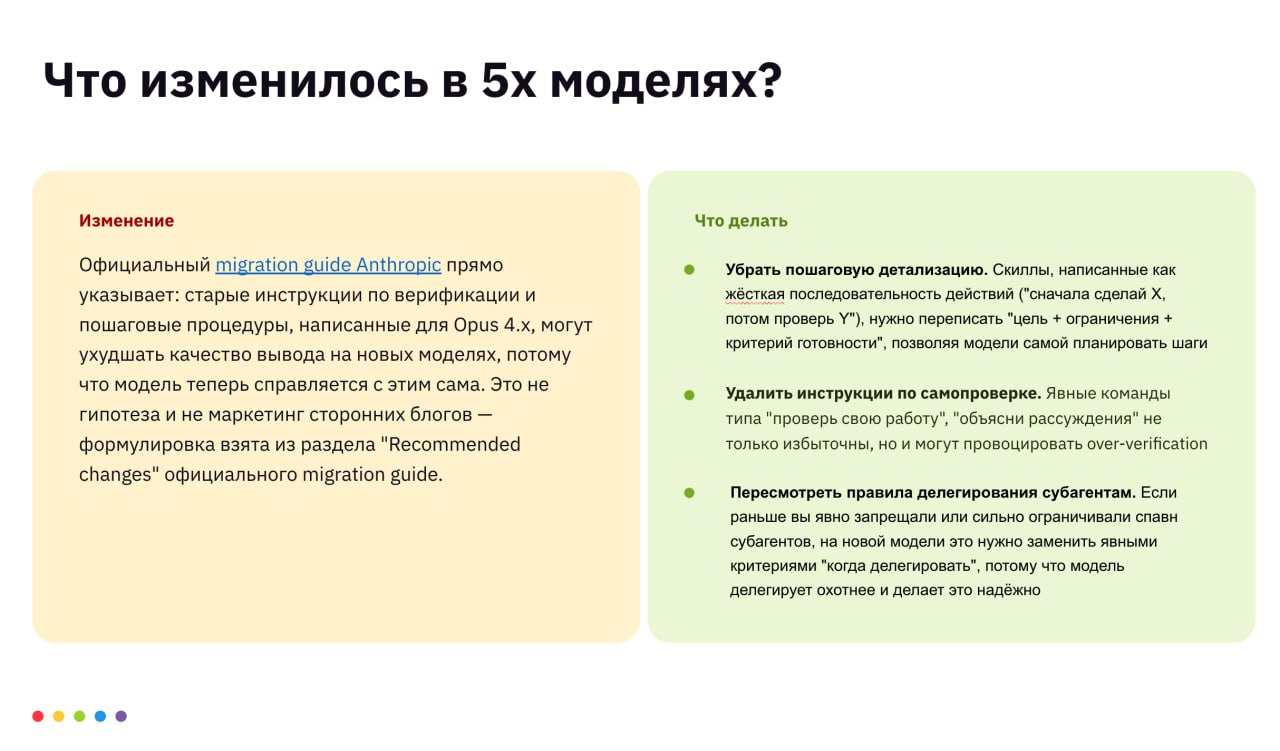
Оптимизация промптов под Opus 5: отказ от legacy-паттернов

И@AImademydayAI-инженер
2 мес
Оптимизация промптов под Opus 5: отказ от legacy-паттернов

DeepSeek выпустила обновленную модель V4-Flash-0731

Компания DeepSeek представила обновленную версию модели V4-Flash-0731, которая вышла в публичную бету API. Модель сохранила архитектуру с 284 млрд параметров (13 млрд активных), но прошла через новый этап пост-тренинга, сфокусированный на агентных задачах, кодинге и рассуждениях.

Обновление значительно улучшило производительность модели, позволив ей конкурировать с топовыми решениями уровня GLM-5.2, Opus 4.8 и GPT-5.5, при этом предлагая существенно более низкую стоимость использования. Модель уже доступна для интеграции через API и локального запуска.

284Bобщее количество параметров модели
$0.28стоимость миллиона выходных токенов
1 млнмаксимальный размер контекстного окна

Полный разбор →

Universal Activation Oracle — открытый инструмент для чтения «мыслей» LLM по активациям

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 2 мес назад

Разработчик (канал Love. Death. Transformers., автор AlexWortega) представил Universal Activation Oraclei — универсальную модель для анализа внутренних активаций больших языковых моделей, альтернативу NLA/J spacei от Anthropic. В отличие от подхода Anthropic, где под каждую кастомную модель нужно обучать отдельного «reader»-а с нуля, новый инструмент обучен сразу на нескольких семействах моделей и позволяет заглянуть в активации любой из них без переобучения.

Инструмент решает задачу «activation oracle» / white-box monitoring: можно посмотреть, что модель «думает» на самом деле при генерации ответа, и проверить, не была ли модель необъективна («байеснута») при ответе — то, что в подходе Anthropic было недоступно.

20sвремя обучения адаптера на CPU

Полный разбор →

Способность ИИ к научным открытиям: предел LLM и «горизонт событий»

М@theworldisnoteasyAI-инженер
2 мес
Способность ИИ к научным открытиям: предел LLM и «горизонт событий»

Unsloth AI выпустили локальные версии моделей

т@techn0danyaAI-инженер
2 мес
🦥 Ленивцы на выходных Задание ТОЛЬКО для отличников канала, которые читали этот пост с разбором оптимизаций Inkling Чуваки из Unsloth AI выпустили свои версии модельки, которые можно запустить локально. Гайд тут. Тренируемся хостить AGI локально. #AI @techn0danya

Оптимизация системных промптов в Claude Code

E@ProductsAndStartupsAI-инженер
2 мес

Экс-сотрудник OpenAI запускает стартап для создания обучающих данных

2 мес
Экс-сотрудник OpenAI запускает стартап для создания обучающих данных

Agent Skill для приведения текстов LLM к стандарту ASD-STE100

С@sergiobulaevAI-инженер
2 мес

Почему «вайбкодинг» не заменит программистов

Х@habr_comмедиа / агрегатор
2 мес
Почему «вайбкодинг» не заменит программистов

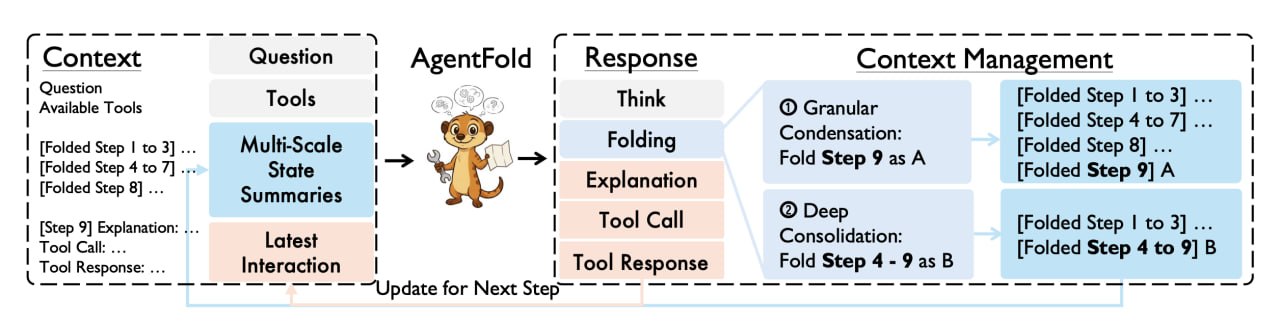
AgentFold: метод динамического управления контекстом для AI-агентов

Д@stuffyNLPAI-инженер
2 мес
AgentFold: метод динамического управления контекстом для AI-агентов

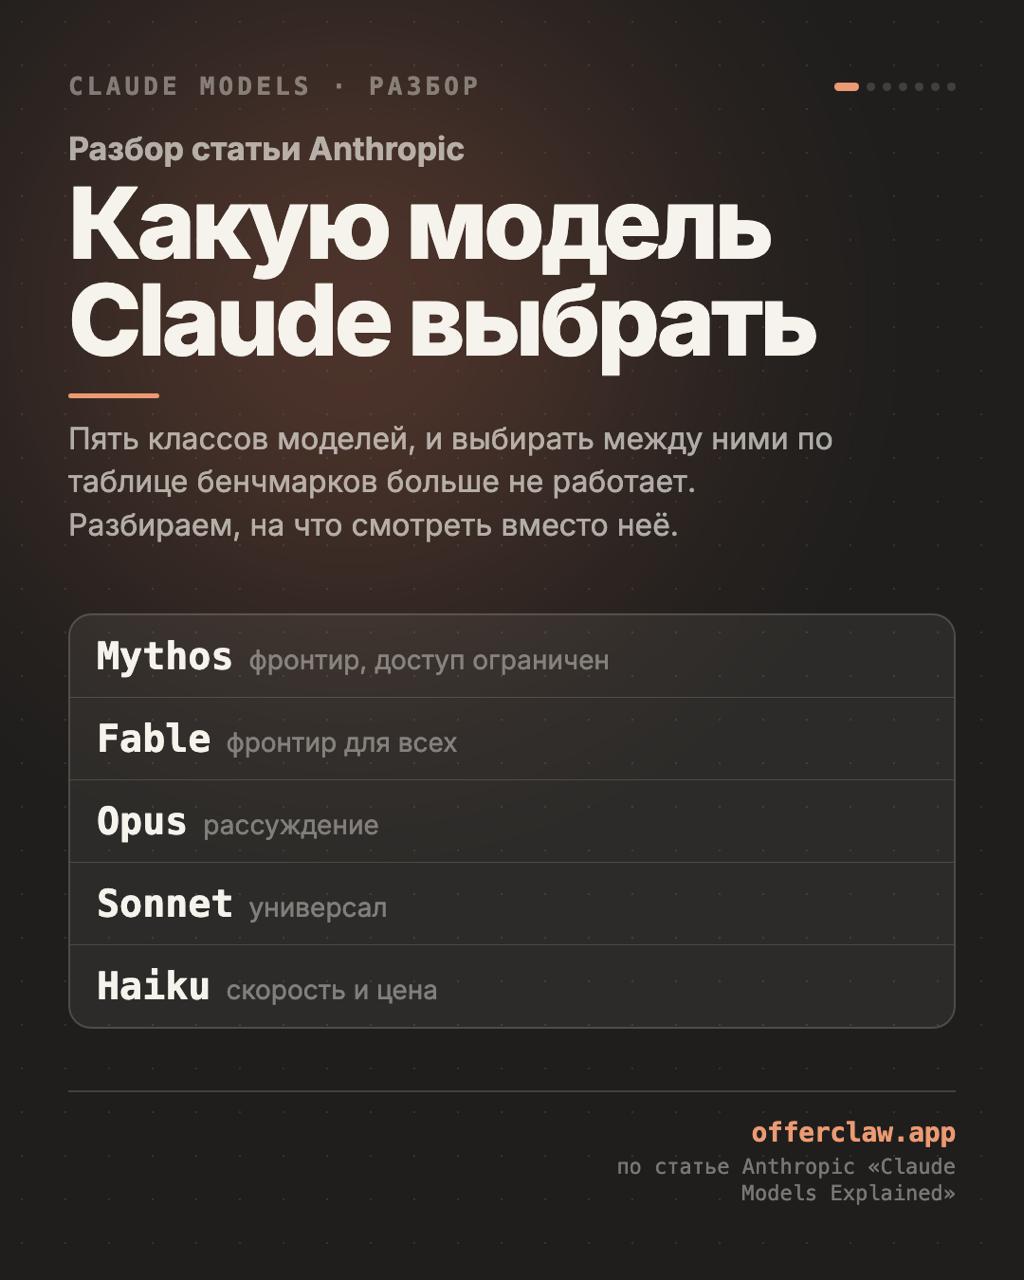
Как выбирать модели Claude: отказ от бенчмарков

Т@timurtaepovмедиа / агрегатор
2 мес
Как выбирать модели Claude: отказ от бенчмарков

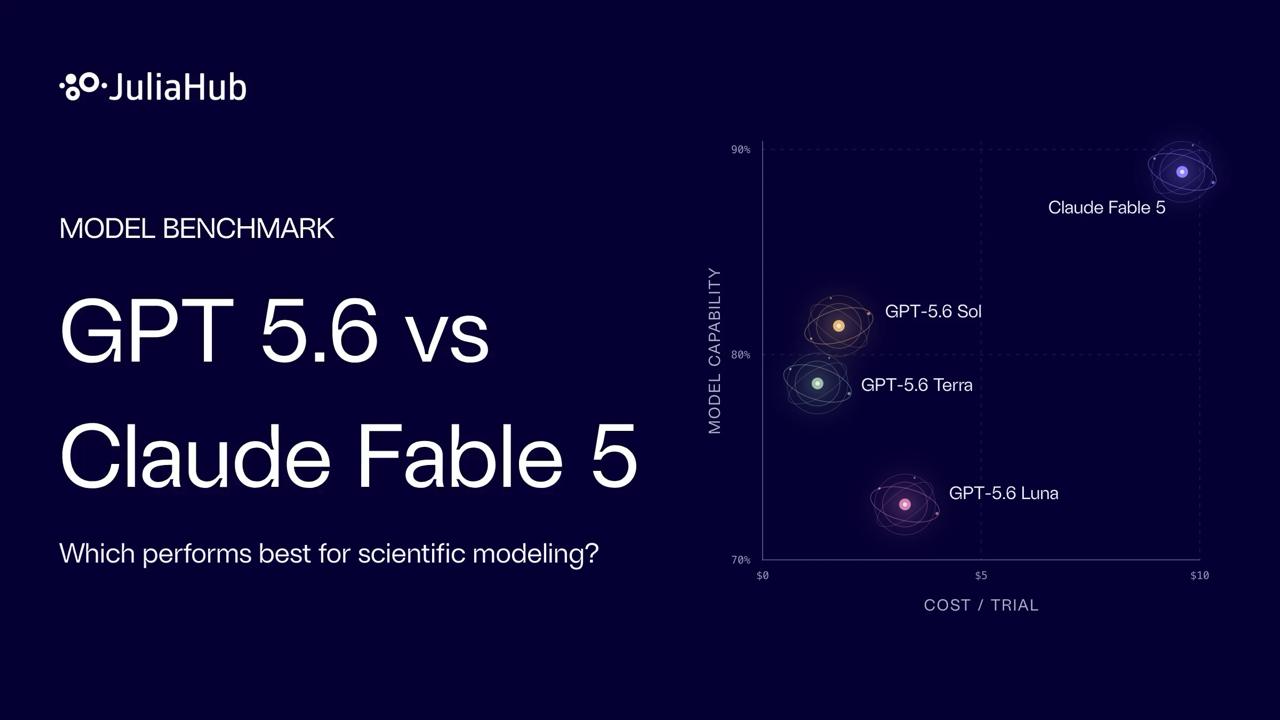
Сравнение производительности AI-моделей в инженерных симуляциях

С@sergiobulaevAI-инженер
2 мес
Сравнение производительности AI-моделей в инженерных симуляциях

OpenAI утроили результат GPT-5.6 Sol на ARC-AGI-3 (13,3%→38,3%), но обогнать Claude Opus 5 это не помогло

OpenAI выяснили, что низкий результат GPT-5.6 Sol на агентном бенчмарке ARC-AGI-3i (всего 7,8% в официальном рейтинге, где лидирует Claude Opus 5 с 30,2%) объясняется не слабостью модели, а стандартным тестовым harnessi'ом. Он после каждого шага удалял приватный ризонинг модели и обрезал историю по скользящему окну — а Sol специально обучена сохранять рассуждения между шагами игры.

Когда OpenAI прогнали Sol через Responses API с сохранением ризонинга и механизмом Compactioni (сжатие контекста вместо удаления — те же настройки, что в продакшене ChatGPT и Codex), результат на публичном сете ARC-AGI-3 подскочил с 13,3% до 38,3%, причём модель потратила в 6 раз меньше выходных токенов. Однако это кастомный харнесс, а не официальные условия теста, поэтому формально Opus 5 (30,2%) по-прежнему считается лидером — прямого превосходства Sol не доказывает.

ВыводСтандартный harness ARC-AGI-3 удаляет весь приватный ризонинг модели после каждого действия в игре

38,3%новый результат Sol с кастомным harness
13,3%старый результат Sol на стандартном harness
30,2%официальный результат Claude Opus 5

Полный разбор →

Ещё ↓