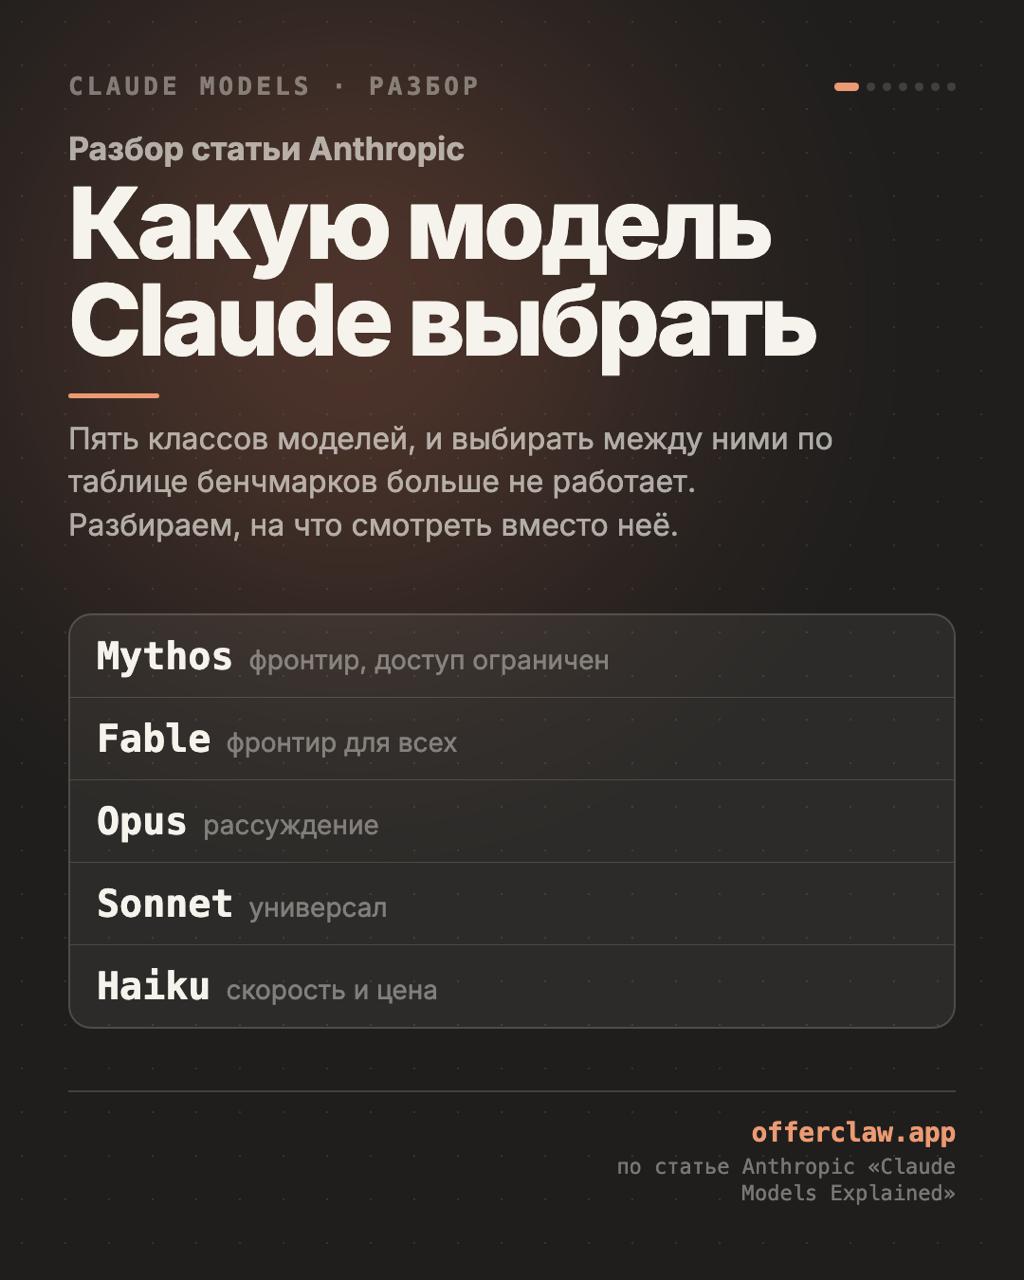
Мини-гайд по оркестрации агентов
У нас недавно в EDU появилось приложение, которое монтирует записи моих лекций и вебинаров для YouTube: находит и вырезает раскачку в начале, паузы, тишину, оговорки, замазывает то, что не должно попасть в кадр. Первую версию завайбкодил стажёр, а потом я ее переписал с командой агентов за выходные.
Собственно, Никита попросил рассказать, как именно я это делал, потому что хочет научиться нормально работать с агентами. Я попросил дружбана разобрать логи всех сессий, чтобы вытащить оттуда метод. Если коротко, то вышло вот что:
1) Сначала карта, потом изменения. Первая команда всей переписки была не "почини", а "разбери код, собери
CLAUDE.md и нарисуй схему в артефакте, чтобы я быстрее разобрался". А дальше допрос: зачем тут вот это, насколько оно критично, что сломается, если выкинуть
2) Свою догадку - в карантин. У меня было ощущение, что архитектура переусложнена, но просил я не согласиться со мной, а взвесить оба варианта, причем на другой модели. Больше всего мне самому понравился прием, который мы придумали с AI Natives в ходе какого-то зумбара: "сделай архитектурное ревью, НО
это твое последнее слово, после него ты умрешь"
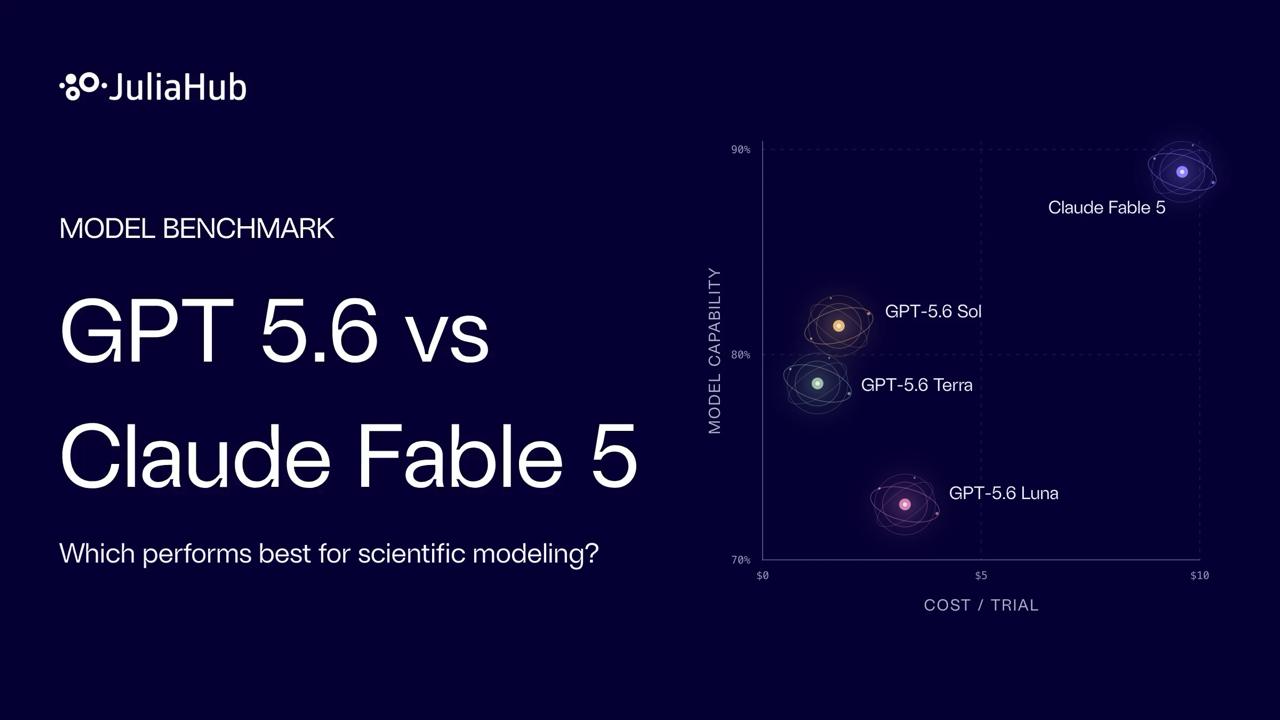
3) Не одним куском, а фазами, и между каждой - критик на другой модели, которому запрещено хвалить. В гите так и осталось: Phase 1 —> Phase 1 review fixes (Fable) —> Phase 2 —> и так далее;
4) Тест = запустить, а не посмотреть глазами на код. Приложение само предлагает, что вырезать, и оценивает, насколько оно в этом уверено; все, что выше 0.82, принималось автоматом. Прогнали на реальном двухчасовом вебинаре - а моделька, оказывается, ставит всем подряд одно и то же: 137 кусков из 141 ровно 0.85. То есть принималось вообще все, включая вступление и живой Q&A. По коду такое не увидишь
5) Мерить там, где оно крутится, а не на ноуте. В случае работы с видео это особенно важно
6) Каждый косяк - сразу в CLAUDE.md, это память команды на будущее. И коммит только после того, как проверили, а не после того, как собралось
7) В конце - взгляд сверху: что сделали, что не решено, где узкие места и что осталось до прода. Агент сам назвал главный оставшийся риск, и это стало следующей задачей
Все это собрал в небольшой гайд —> вдруг, вам тоже будет полезно, хотя по мне там не какой-то rocket science
напишите, если вам какой-то поинт из гайда пришелся в тему