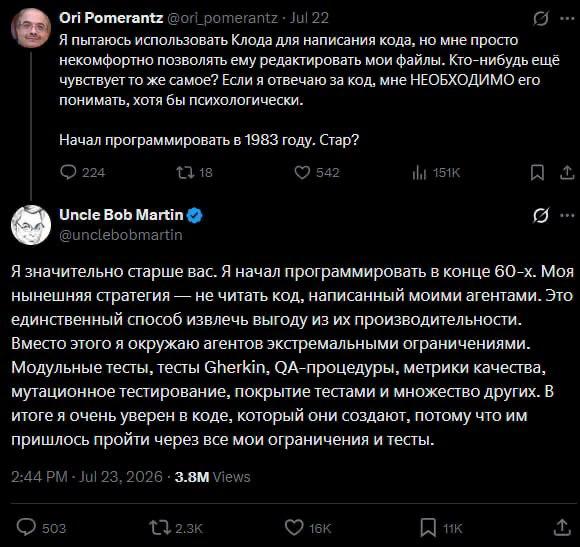
На скрине Uncle Bob Martin (Роберт Сесил Мартин) — известный американский инженер, автор и один из главных популяризаторов принципов чистой разработки ПО, который стоял у истоков Agile
Роберт Мартин (Дядя Бобi), автор культовых книг «Чистый код» и «Чистая архитектура», заявил в своём Твиттере, что официально перестал вчитываться в исходники, которые для него пишут ИИ-агентыi. Вместо этого он выстроил жёсткую систему автоматических проверок: алгоритм генерирует код, тесты и метрики прогоняют его через фильтры, и если все проверки «зелёные» — работа считается сделанной.
Заявление вызвало бурю в комментариях: пользователи резонно спросили, как гуру идеальной архитектуры может доверять нейросетям, которые регулярно галлюцинируют и лепят костыли. Мартин ответил максимально цинично, но точно: «Люди делают то же самое».
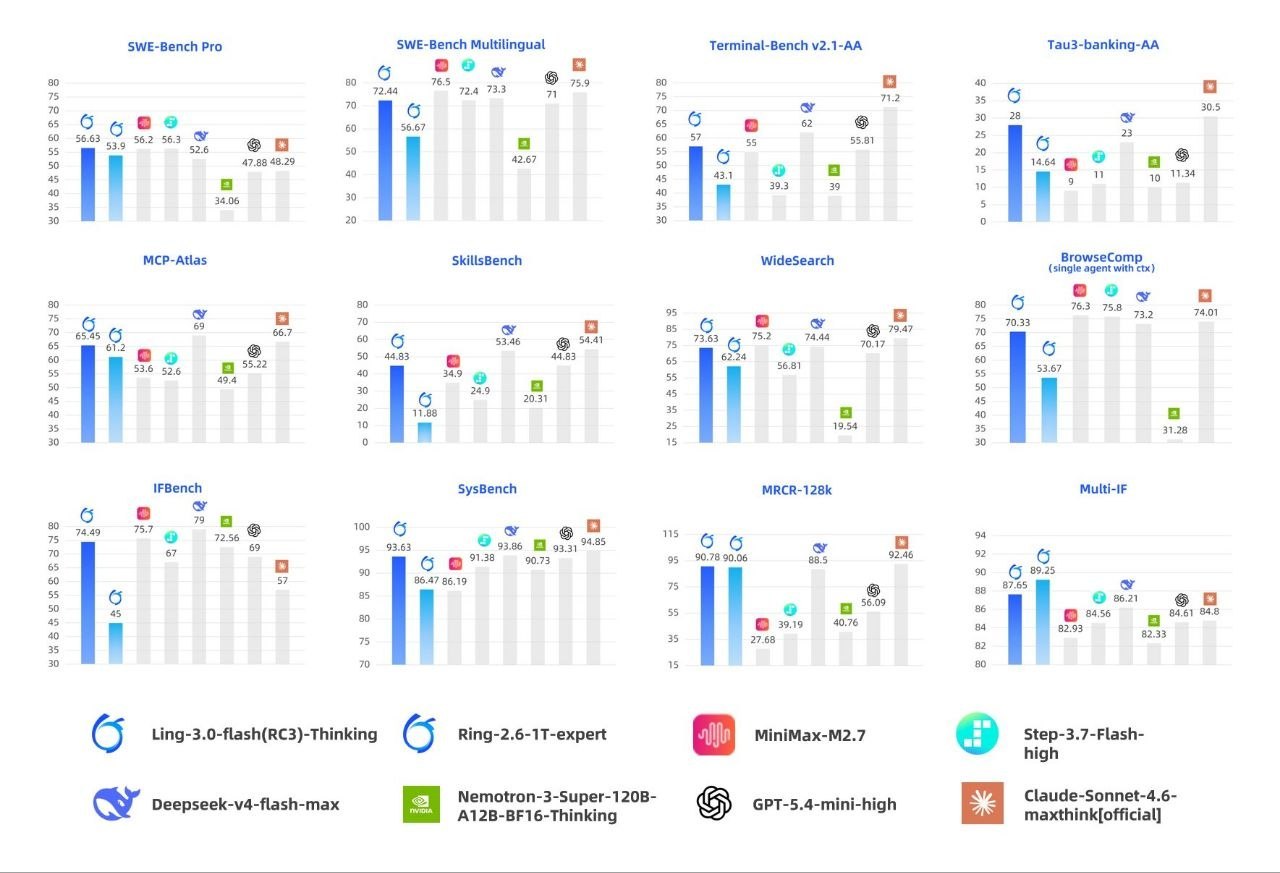
Ling-3.0-flash
Агентная #MoE-модель от InclusionAI. программирование, поиск, исследования, работа с инструментами
• 124B параметров, 5,1B активных на токен
• контекст до 256 тыс. токенов, расширение до 1 млн
• API совместим с OpenAI
• по отзывам сопоставима с моделями на 1 трлн параметров
бесплатный доступ на OpenRouter до 3 августа 2026
на Kilo - ограниченное время
Спасибо @Endorpheen
#coding #agent
Почти с самого начала этого канала (пост 102 и далее, 2021 год) я пишу о том, что программировать слишком сложно и я с этим внутренне не согласен. Количество усилий на порядки больше получаемого результата. Условно, придумать и описать туду-приложение — 30 минут. Запилить, чтобы оно вот прям у тебя на телефоне появилось — дни, недели, месяцы.
Я все списывал на accidental complexity, которую привносят наши инструменты, и на их несовершенство. И мечтал о лучших инструментах.
Штош, мой идеал достигнут, но другим путем. Программировать теперь ровно настолько сложно, насколько и должно быть. Починили, проверяй.
🔥 Бесплатный курс по нейросетям от Андрея Карпати: от backprop до GPTNeural Networks: Zero to Hero — бесплатный курс с видео и Jupyter-ноутбуками, где нейросети изучаются через реализацию руками.
Что внутри:
• backprop с нуля через micrograd
• bigram и MLP-модели на PyTorch
• разбор активаций, градиентов и BatchNorm
• ручной backprop без loss.backward()
• переход к WaveNet-подобной архитектуре
• сборка GPT по шагам
• основы BPE-токенизации
Хороший вариант, чтобы понять, как нейросети работают изнутри, а не запоминать формулы.
Проект open-source, лицензия MIT.
🔗 https://github.com/karpathy/nn-zero-to-hero
Я так долго смеялся с этого комментария, а ведь группа была из одних олимпиадников.
Но да, на первом курсе проходить Дерево Фенвика, Фибоначчивы кучи и AVL деревья было очень не просто.
🦄 Опубликовал платформу для гайдов и первую статьюhttps://golang.guide/
Надеюсь, вам понравится, я очень старался ☀️
Там всего один единственный гайд — первая часть серии статей про Планировщик. Даже если вы читали оригинальную статью, или смотрели ролик, всё равно советую перечитать — тут полный ремастер и режисёрская версия с интерактивом 👍
Остальные статьи уже в работе. Буду выпускать их по мере сил.
Советую читать с десктопа — там пока больше фич, чем на мобилке.
Если заметите какие-то баги или проблемы — пишите, поправлю.
Джек Дорси, сооснователь Twitter и глава компании Block, представил Buzz — платформу для совместной работы людей и ИИ-агентов, объединяющую функции Slack и GitHub. Агенты в Buzz не боты под чужими правами, а полноправные члены команды: у каждого своя учётная запись, ключ и права доступа, они пишут код, проверяют его и создают пул-реквесты, а люди наблюдают и контролируют процесс.
Проект децентрализован и опенсорсен, построен на протоколе Nostr, без центральных серверов, которые можно заблокировать или подвергнуть санкциям. Развернуть Buzz можно на собственных серверах, чтобы сохранить корпоративные секреты, а вычислительные мощности и токены участников чата можно объединять в общий кластер для запуска нейросетей.
У клодексора тем временем уже больше 2 000 установок! Надеюсь, смог сделать действительно полезную штуку. Огромное спасибо комьюнити за ваши PR и issues! Всё забрал и сегодня выпустил обновление v3.1. И сжёг лимиты на всех подписках 🌚
Теперь у меня уже по четыре подписки на Claude Code и Codex.
Разработчик выпустил приложение для macOS под названием Language Model Builderi, которое позволяет любому человеку с нуля пройти весь путь создания языковой модели — от теории до работающего нейропомощника. Инструмент бесплатный и сочетает интерактивный учебник с практическим тренингом собственной GPT-модели на своих данных.
Значимость — в доступности: раньше обучение LLMi требовало глубоких знаний ML, а теперь базовый процесс можно освоить за пару часов на обычном ноутбуке, получив на выходе рабочую модель уровня GPT-2-smalli, с которой можно общаться.