FDE-Gym оценивает способность AI-агентов создавать продукты
E@ProductsAndStartupsAI-инженер
4 ч
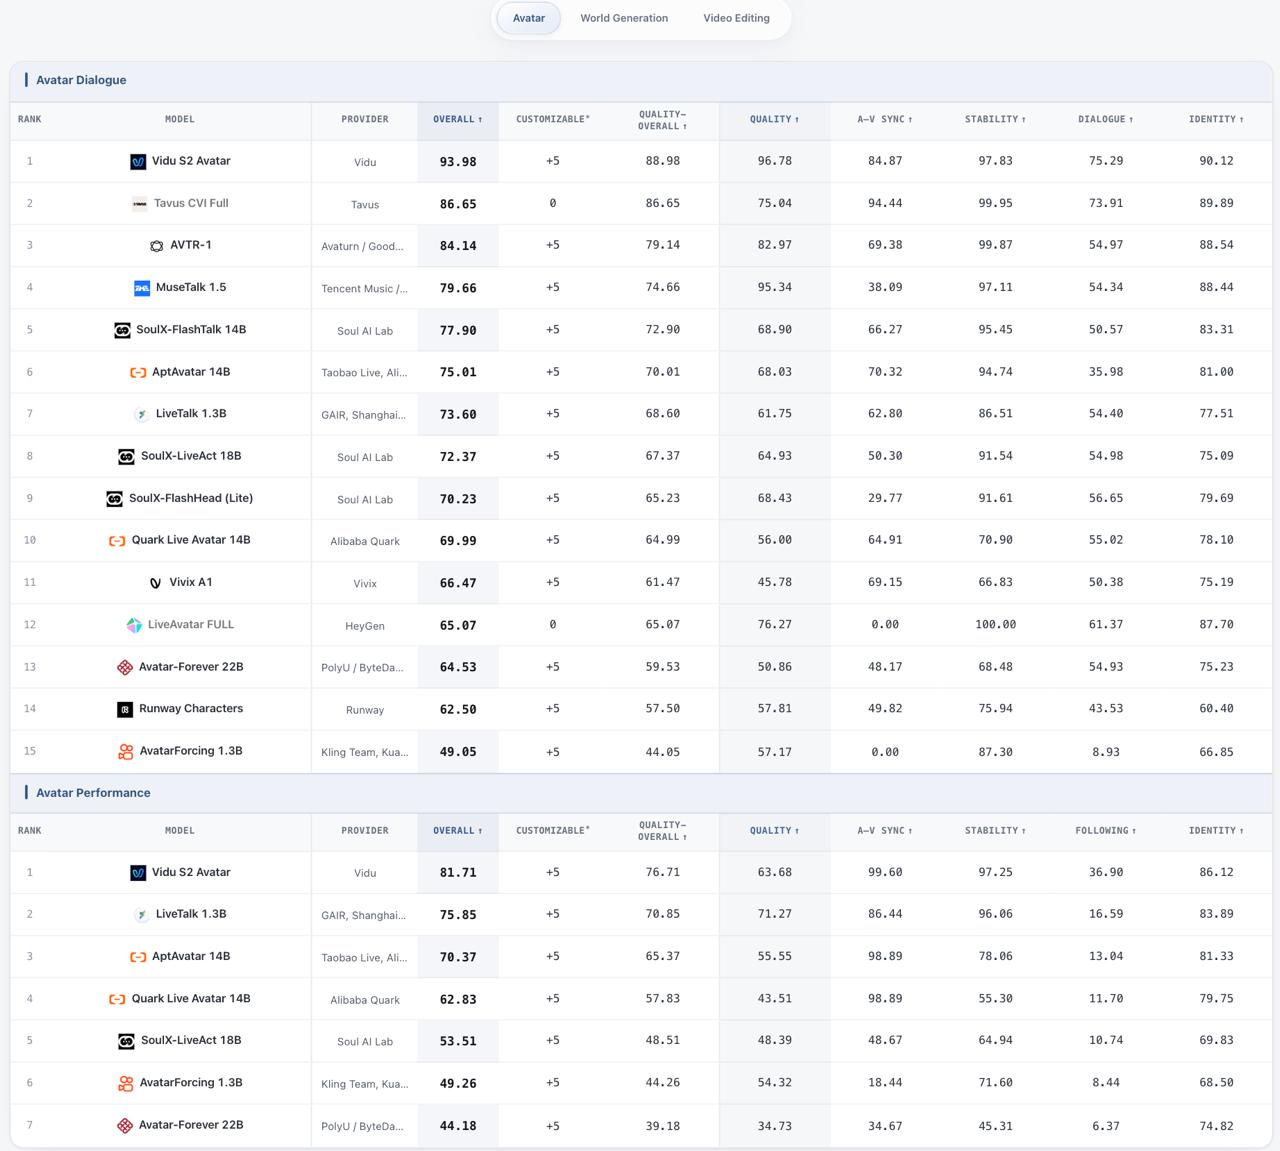
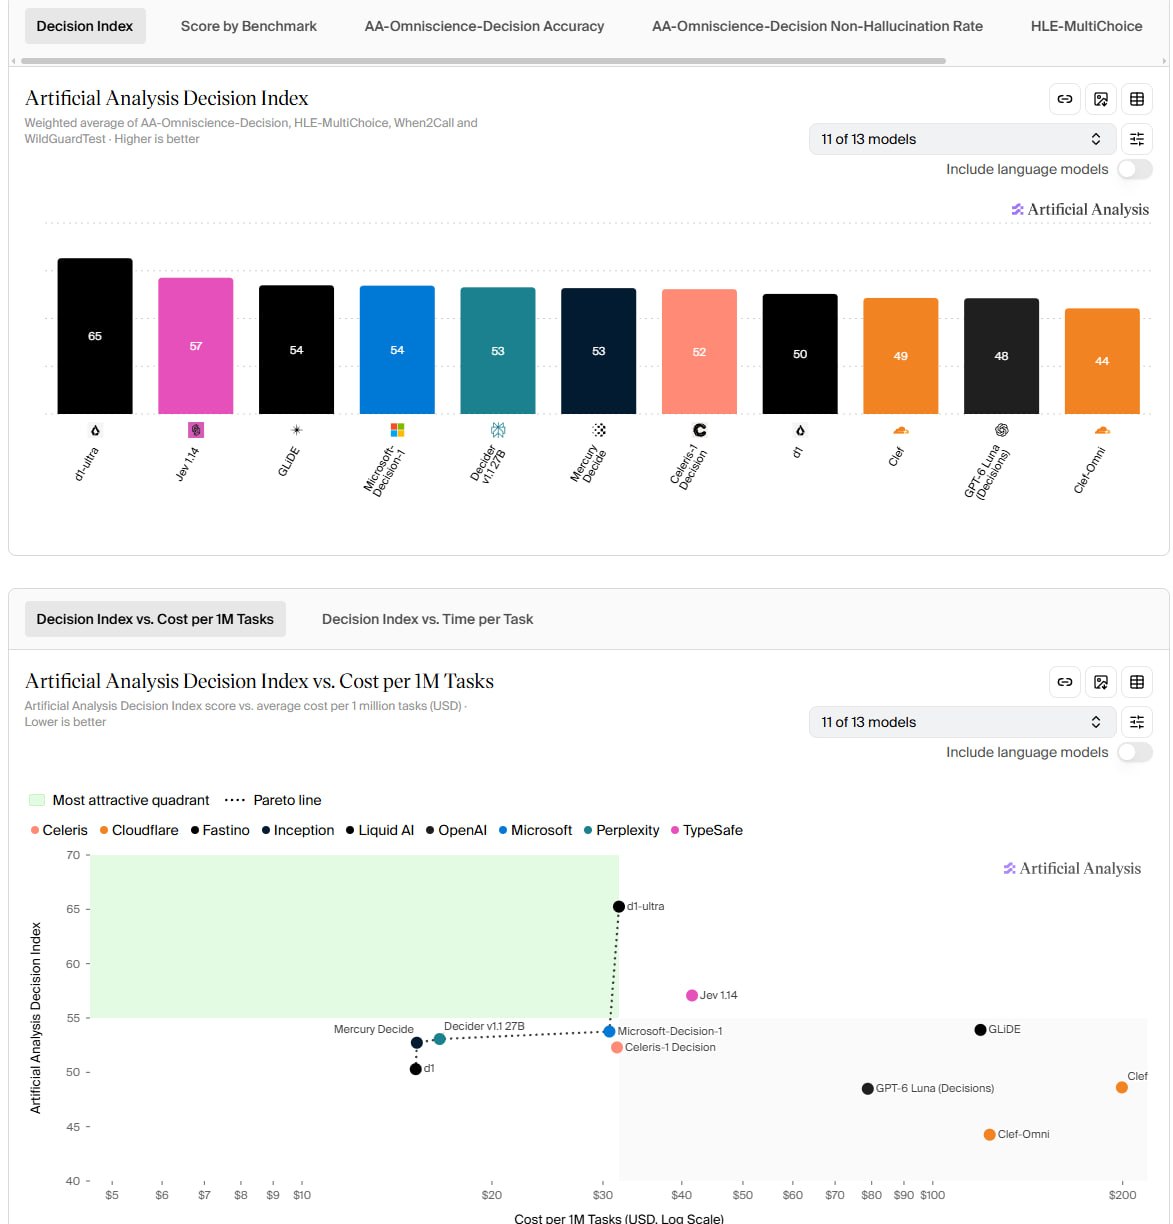
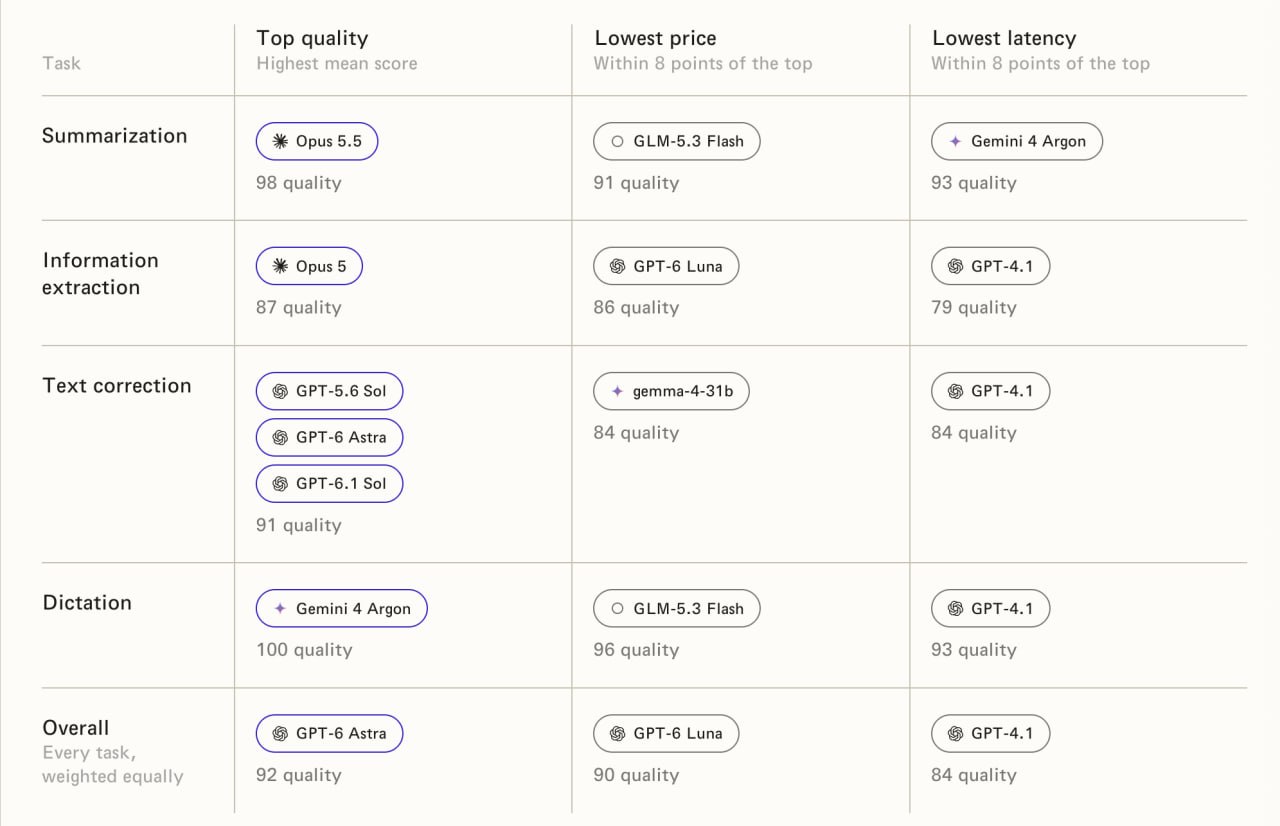
Дима Антипов, автор канала @anti_notes, провёл собственное исследование новой волны «decision models» (Jev-style моделейi) и опубликовал результаты в статье на Хабре. Эти модели предназначены не для генерации текста, а для быстрого принятия небольших «решений» внутри AI-пайплайнов, и если они смогут работать с качеством, близким к 100%, за доли секунды и за копейки — это может изменить архитектуру и процессы разработки значительной части софта.
Сергей Марков, автор канала «Сергей Марков: машинное обучение, искусство и шитпостинг», назвал идею decision-моделей «настолько простой и элегантной», что удивился, как долго индустрия к ней шла, и подтвердил результаты бенчмарка собственным прогоном моделей той же ночью.
ВыводБенчмарк включал 12 моделей, протестированных на 5000 русскоязычных примерах в пяти категориях; формат — вопрос-ответ без глубокой доменной специфики, с золотой разметкой, сделанной людьми
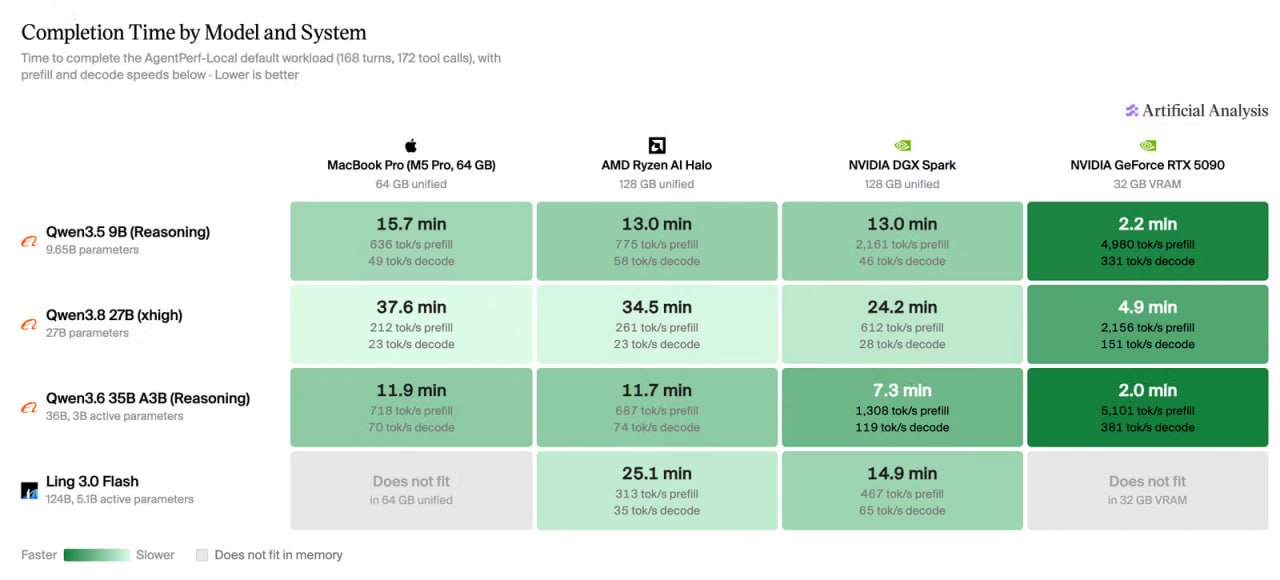
Команда, работавшая над проектом год, представила WebPageBenchi — локальную тестовую среду для оценки ИИ-агентов, выполняющих повседневные задачи на сайтах (покупки, бронирование билетов и отелей, заказ справок) на русском языке. Ключевая идея: вместо реальных сайтов, где интерфейсы меняются, антибот блокирует прогоны, а заказы с оплатой становятся настоящими, используются шесть мок-версий популярных сервисов, где каждое действие агента фиксируется в лог и проверяется автоматически, а не со слов самого агента.
Бенчмарк важен, потому что впервые показывает объективный разрыв между тем, что агенты сообщают о своей работе, и тем, что они реально сделали — а разрыв оказался значительным.