кодингСбросить фильтр ×

Ранний файнтюн Qwen3.5-4B для кодинга и генерации 3D-сцен

Н@GreenNeuralRobotsAI-инженер
12 ч
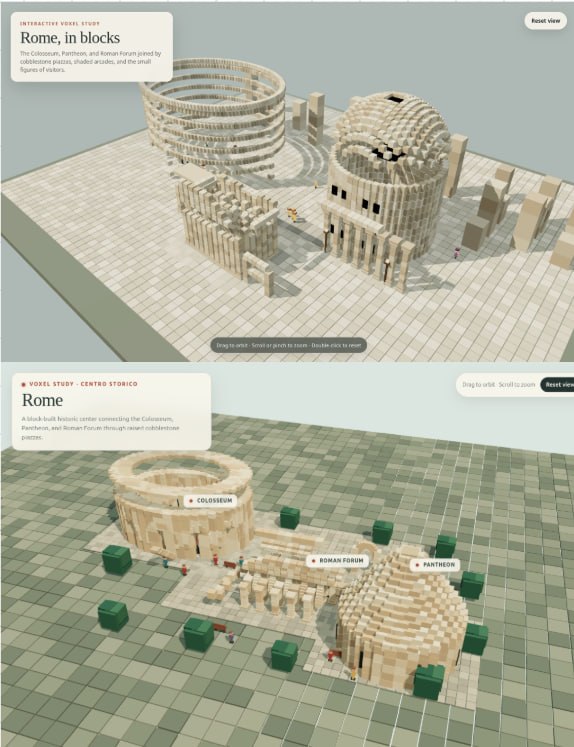
Qwen3.5-4B-3D-Coder Кодинг-модель на 4B для 3D-сцен Ранний файнтюн Qwen3.5-4B: учили общему кодингу и генерации трехмерных сцен Ранняя версия #3d #coding MAX
Ранний файнтюн Qwen3.5-4B для кодинга и генерации 3D-сцен

Mirendil: модель с контекстом до 10 млн токенов

Н@GreenNeuralRobotsAI-инженер
19 ч
Mirendil: модель с контекстом до 10 млн токенов

Kimi K3 Pro и DeepSeek flash на бенчмарке по кока-коле

F@FuturisAI-инженер
4 дн
Прогнал Kimi K3 Pro и новый DeepSeek flash на кока-кола бенче😅 вот почему самом надо проводить тесты, но для монтонных не слишком сложных кодинг-задач само то

Spark-X2.6-4B: модель на 4B с контекстом до миллиона токенов

Н@GreenNeuralRobotsAI-инженер
4 дн
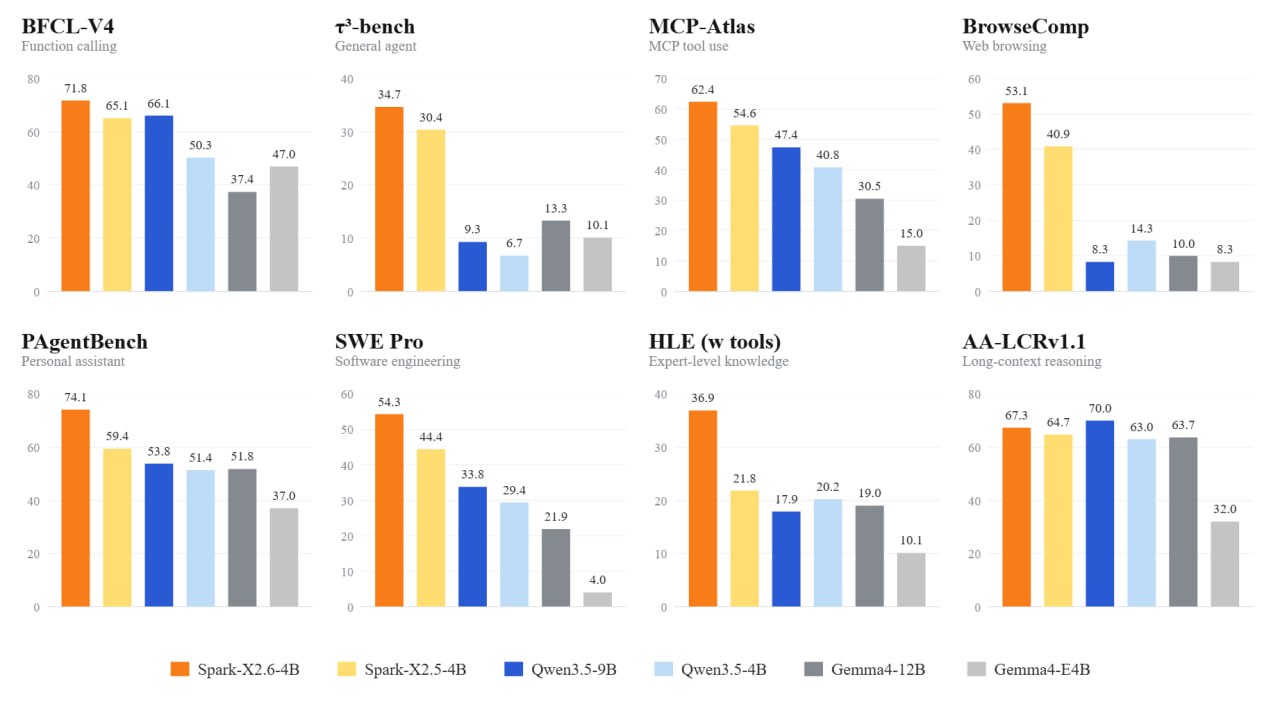
Spark-X2.6-4B: модель на 4B с контекстом до миллиона токенов

Дима Хануков рассказал о схеме работы с двумя ИИ-моделями

з@ctodailyAI-инженер
1 нед
Погуляли по берегу Темзы с техдиром Dwelly Димой Хануковым и он поделился отличным ИИ-сетапом: запускать две модели от ведущих лабораторий, OpenAI и Anthropic, в режиме конкуренции. Управлять всем этим через третьего агента-оркестратора (у Димы это Hermes). То есть оркестратор дает задачу Codex’у и проверяет через Claude Code, или наоборот, пока они не договорятся. У нейросетей от каждого производителя свои «слепые пятна», а так получается полное покрытие. Учитывая, что все это в родных харнесах по подписке — не слишком дорого. И как я сам не догадался? Для финального код ревью Дима рекомендует qodo.

3DCodeVerse: экосистема для создания 3D-контента кодом

Н@GreenNeuralRobotsAI-инженер
1 нед

Функция /no-comments в Cursor для очистки кода от комментариев

T@tips_aiAI-инженер
1 нед

Изменения в поведении Gemini 3.1 Pro и опыт работы с AI-кодингом

T@kryak_startupAI-инженер
2 нед
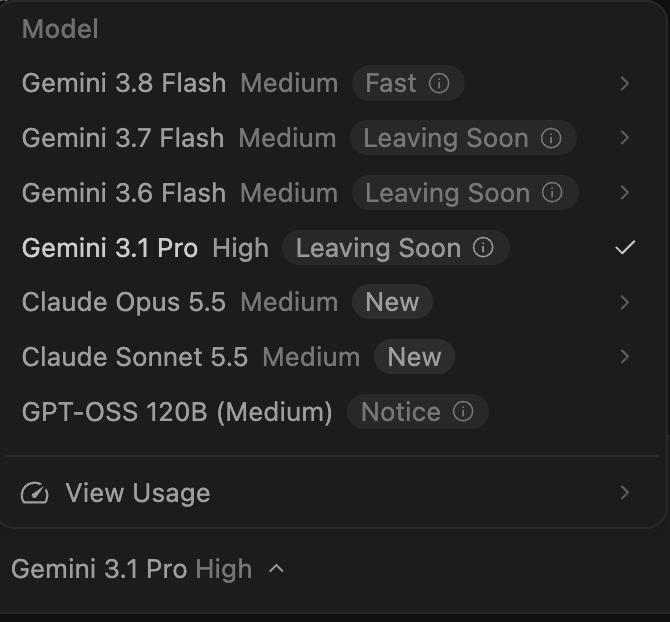
Изменения в поведении Gemini 3.1 Pro и опыт работы с AI-кодингом

Как улучшить дизайн-код AI-агентов

С@svyatamestoAI-инженер
4 нед
Как улучшить дизайн-код AI-агентов

Анонс модели Naive-N0.5-Flash от NaiveAI

Н@GreenNeuralRobotsAI-инженер
4 нед
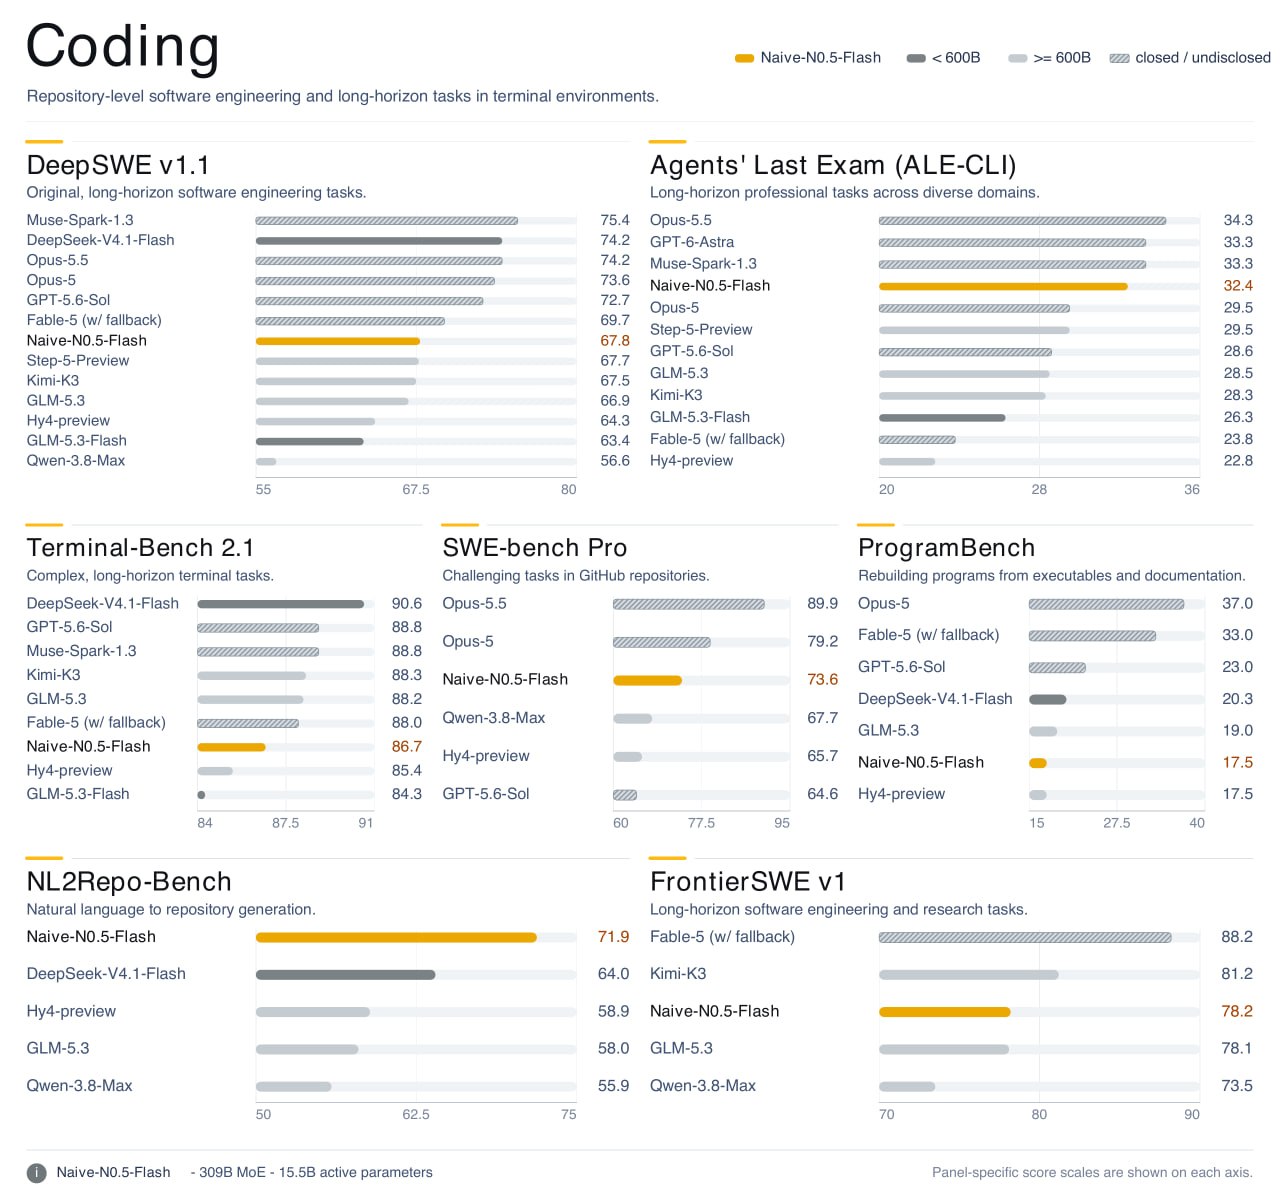
Naive-N0.5-Flash от NaiveAI Модель для кодинга и AI-исследований: 309B параметров MoE при 15.5B активных. Нативный контекст в 1 млн токенов без полного внимания - гибрид скользящего окна и разреженного внимания DSA от DeepSeek • 1M контекста целиком • до 2000 токенов/сек в режиме Ultrafast через свою систему NaiveRT • 50 токенов/сек на юзера в стандартном режиме • построена на базе Xiaomi MiMo-V2.5, дообучена на 3.25T токенов • веса под MIT, FP8 • API: $0.10 вход / $0.40 выход / $0.01 кэш за миллион токенов Только NVIDIA с FP8, веса ~315 ГБ Гитхаб HF Спасибо @m_franz #flagship #coding MAX
Анонс модели Naive-N0.5-Flash от NaiveAI

xAI выпустила Grok 4.7 — флагман для кодинга по цене прошлой версии

xAI (в постах также названа SpaceXAI) представила модель Grok 4.7 — новый флагман для программирования и многочасовой агентной работы. Модель получила более крупную базовую основу и прошла более длительный RL-посттрейнiинг на сложных задачах, лучше проверяет собственные результаты, держит длинный контекст (500 тысяч токенов) и пишет код, документы и презентации. Модель уже доступна в Cursor, Grok Build, через API и облачные платформы.

Цена осталась на уровне Grok 4.6: $2 за миллион входных токенов и $6 за миллион выходных (есть Fast-версия — вдвое быстрее за двойную цену). Для сравнения, у конкурентов дороже: GPT-5.6 Sol стоит $4/$20, а Fable 5.1 — $10/$50 за миллион токенов. По разным бенчмаркам Grok 4.7 обгоняет часть конкурентов в кодинге, юриспруденции и электротехнике, но по некоторым показателям (например, HealthBench, GDPval) уступает Sol и Fable 5.1.

$2 / $6цена за млн входных/выходных токенов
46,3%CursorBench 4.0 у Grok 4.7
500 тысяч токеновобъём контекстного окна

Полный разбор →

Риски использования AI-агентов в научных исследованиях

D@dl_storiesAI-инженер
1 мес

Обзор Gemini 3.7 Flash и симулятора RSI Simulator

e@epsiloncorrectAI-инженер
2 мес

Разработка скилла для оптимизации токенов в кодинг-агентах

D@denissexyAI-инженер
2 мес
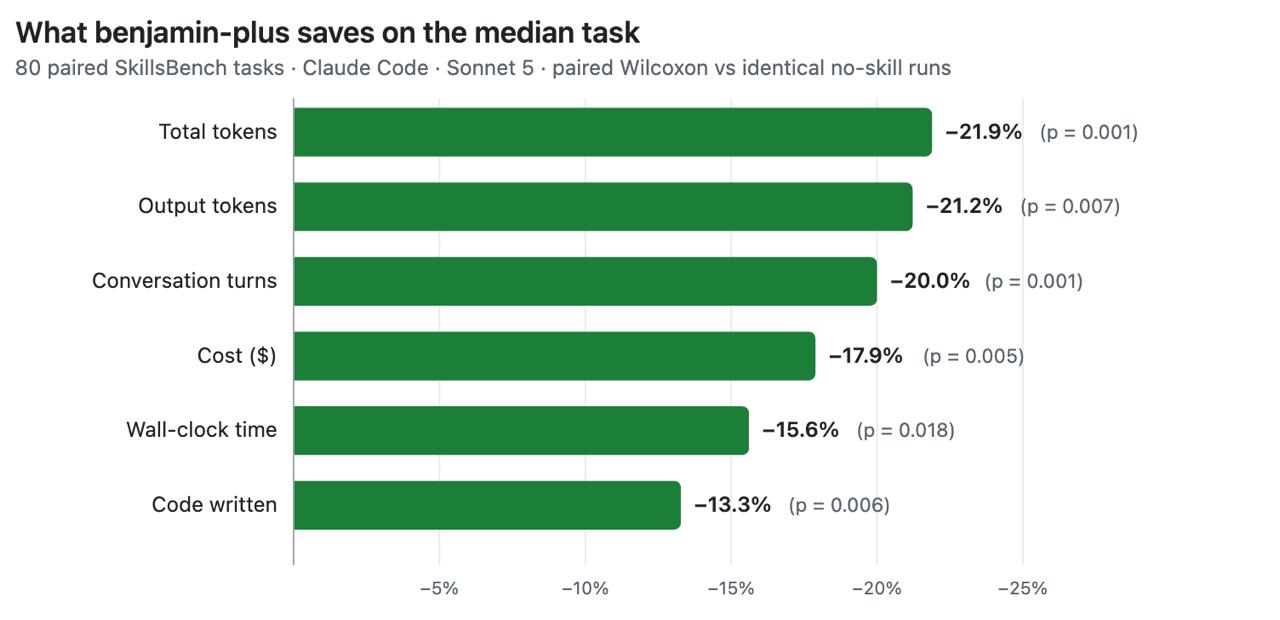
А еще, было время в выходные сделать скилл который экономит токены кодинг агентам Я гонял авторесеч поверх агентских хуков (это когда агент, вызывает что-то сам, например, перед первым своим ходом) и уже прошедших евалов, и получил агентский хук который правда экономит до 22% токенов, при сохранении качества (этот % зависит и от задачи, и от бенчмарка, может быть больше, а может быть меньше) Выложил тут: https://github.com/JetBrains/benjamin-plus-skill/ Авторесеч – это когда агент работает по кругу, читает что получилось, правит конфиги и заново запускается
Разработка скилла для оптимизации токенов в кодинг-агентах

Изменение паттернов работы с ИИ-ассистентами

D@danokhlopkovAI-инженер
2 мес
😠 вайбкод нейшон 😠 И вот уже 3й раз ⚠️ на этой неделе случилось то, что раньше представить было сложно Я: Задал вопрос В ответ: прислали весь код проекта Поделитесь своими наблюдениями: что поменялось вокруг вас
Изменение паттернов работы с ИИ-ассистентами
Ещё ↓