Spark-X2.6-4B: модель на 4B с контекстом до миллиона токенов
Н@GreenNeuralRobotsAI-инженер
4 днSpark-X2.6-4B — модель на 4B параметров с тремя режимами рассуждения, длинным контекстом, поддержкой инструментов и квантованными версиями.
Компактная модель может выполнять задачи с инструментами и длинными файлами без обращения к облаку.
- Модель рассчитана на локальный запуск и имеет варианты квантования под разное железо.
- Контекст до миллиона токенов позволяет обрабатывать длинные документы, но требует много памяти.
- Для запуска указаны SGLang, vLLM и совместимый с OpenAI API.
Spark-X2.6-4B
Небольшая модель для запуска устройстве, 4B параметров. Архитектуру оставили от версии 2.5, весь прирост дала дообучка
• Три режима размышления: без рассуждений, короткий и длинный
• Контекст до миллиона токенов
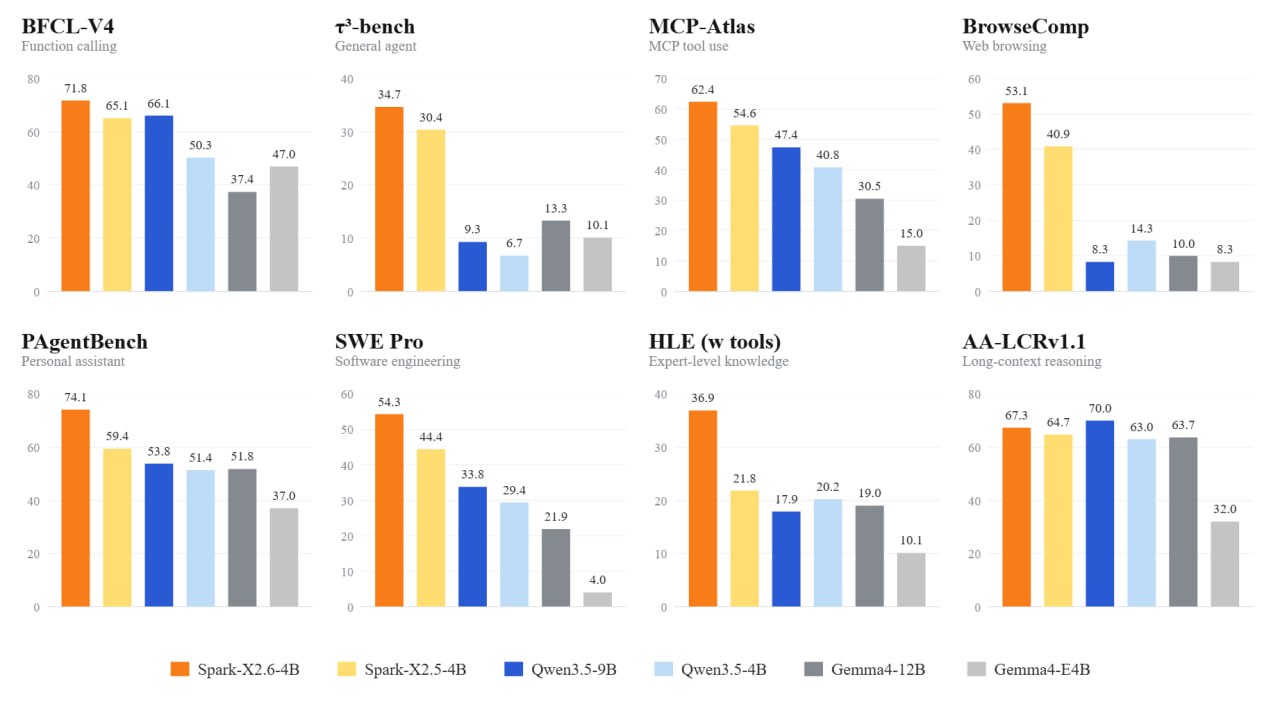
• Кодинг, работа с инструментами и многошаговые задачи тянут лучше, чем ждешь от такого размера
• По бенчмаркам местами догоняет модели на 9 млрд
• Кванты под разное железо: FP8, INT8, INT4 на 2 млрд, GGUF для llama.cpp
• Есть базовая версия без посттренировки
• Скорость на уровне Qwen3.5-4B и Gemma-E4B
• Поднимается через SGLang или vLLM, API совместим с OpenAI
• Миллион токенов контекста съест память, длину можно урезать
Практический смысл в том, что агентские сценарии с инструментами и длинными файлами теперь влезают в 4 гигабайта весов без облака
huggingface.co/collections/XHToken/spark-x26
huggingface.co/XHToken/Spark-X2.6-4B
huggingface.co/XHToken/Spark-X2.6-4B-GGUF
#coding #mobile
MAX
Кратко (AI)
XHToken представила Spark-X2.6-4B — модель на 4B параметров с тремя режимами рассуждения и контекстом до миллиона токенов. Пост сообщает о поддержке инструментов, квантованных версиях и запуске через SGLang или vLLM; при этом длинный контекст требует много памяти.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖