Mirendil: модель с контекстом до 10 млн токенов
Н@GreenNeuralRobotsAI-инженер
17 чMirendil заявляет контекст до 10 млн токенов и 100% точности на поиске одиночного фрагмента в RULER; доступа пока нет.
Модель может обрабатывать огромные объёмы кода за один раз, но её качество на сложных вопросах заметно ниже.
- Контекст до 10 миллионов токенов позволяет работать с большими репозиториями целиком.
- В тесте RULER поиск одиночного фрагмента достигает 100% на заявленной длине.
- На многошаговых вопросах результат снижается до 45%, а доступ к модели пока не открыт.
Fern
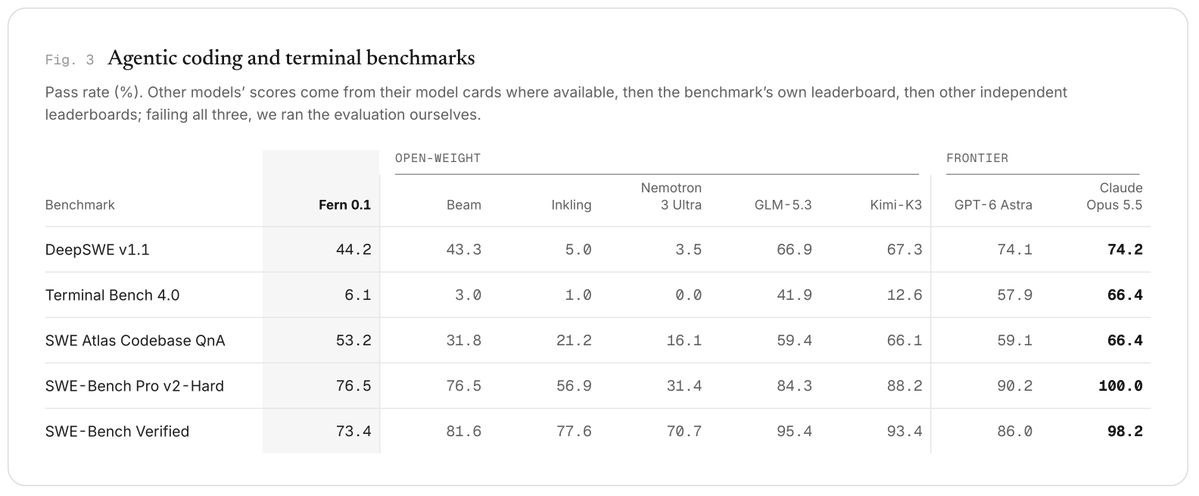
Первая модель Mirendil обученная с нуля. Контекст до 10 миллионов токенов, это примерно 23 МБ кода или полмиллиона строк
• Работа по большим репозиториям целиком
• Кодинг-агент: запускает команды, читает вывод, гоняет до зеленых тестов
• Разбор длинных логов и стектрейсов, поиск места, где сломалось обучение
• Чтение трасс агента от начала до конца с объяснением, что произошло
• Проверка претрейн-данных на дубликаты и загрязнение бенчмарками
• Заточка под исследовательский код: циклы обучения, пайплайны данных, замеры
• 0,1-0,5 трлн параметров
• На RULER поиск одиночного фрагмента 100% даже на 10 млн токенов
• Многошаговые вопросы на такой длине проседают до 45%
• Доступа пока нет, в разработке две модели крупнее
Цена длинного контекста - качество ответа
Спасибо @Endorpheen
#longcontext #coding
MAX
Кратко (AI)
В посте представлена первая модель Mirendil, обученная с нуля, с контекстом до 10 миллионов токенов и упором на исследовательский код и работу с большими репозиториями. На RULER заявлен результат 100% для поиска одиночного фрагмента на такой длине, тогда как многошаговые вопросы дают 45%; доступа к модели пока нет.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖