бенчмаркиСбросить фильтр ×

Бенчмарки AI слабо охватывают задачи большинства профессий

Б@blognotAI-инженер
1 нед
Singular выпустил бенчмарки рекламных креативов на 2026 год

G@gamedevreportsгеймдев
1 нед
Singular выпустил бенчмарки рекламных креативов в 2026 году Сколько выпускает медианный рекламодатель, какие у креативов CTR, CVR, как сконцентрированы траты на топовых креативах и другая информация - в разборе.

FRIDA-Decisions: эффективная модель для принятия решений

M@mashkka_dsAI-инженер
2 нед
FRIDA-Decisions: эффективная модель для принятия решений

State of AI Report 2026: в разделе Research отмечены работы AIRS-Bench и HyperAgents

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 2 нед назад

Опубликован ежегодный State of AI Report 2026 — объёмный обзор индустрии, исследований, безопасности и политики в сфере ИИ. В категорию Research попали сразу две работы авторов, о которых идёт речь в постах: бенчмарк AIRS-Benchi и проект HyperAgentsi.

Отчёт продолжает расти в объёме из года в год и остаётся одним из ключевых ориентиров для тех, кто следит за состоянием отрасли ИИ.

ВыводОбъём отчёта State of AI Report 2026 составил 244 страницы
244 страницыобъём State of AI Report 2026
слайд 36упоминание AIRS-Bench
слайд 14упоминание HyperAgents

Полный разбор →

Китай сократил технологическое отставание от США в ИИ до 3%

Х@htech_plusисследователь
3 нед
Bloomberg Intelligence: Китай сократил отставание от США в ИИ до 3% Китайские разработчики искусственного интеллекта сократили отставание от американских конкурентов до рекордно низкого уровня. По оценке Bloomberg Intelligence, лучшие китайские модели теперь уступают американским около 3% по результатам бенчмарков — против 9% в мае и 15% в начале 2026 года. https://hightech.plus/2026/10/05/bloomberg-intelligence-kitai-sokratil-otstavanie-ot-ssha-v-ii-do-3
Китай сократил технологическое отставание от США в ИИ до 3%

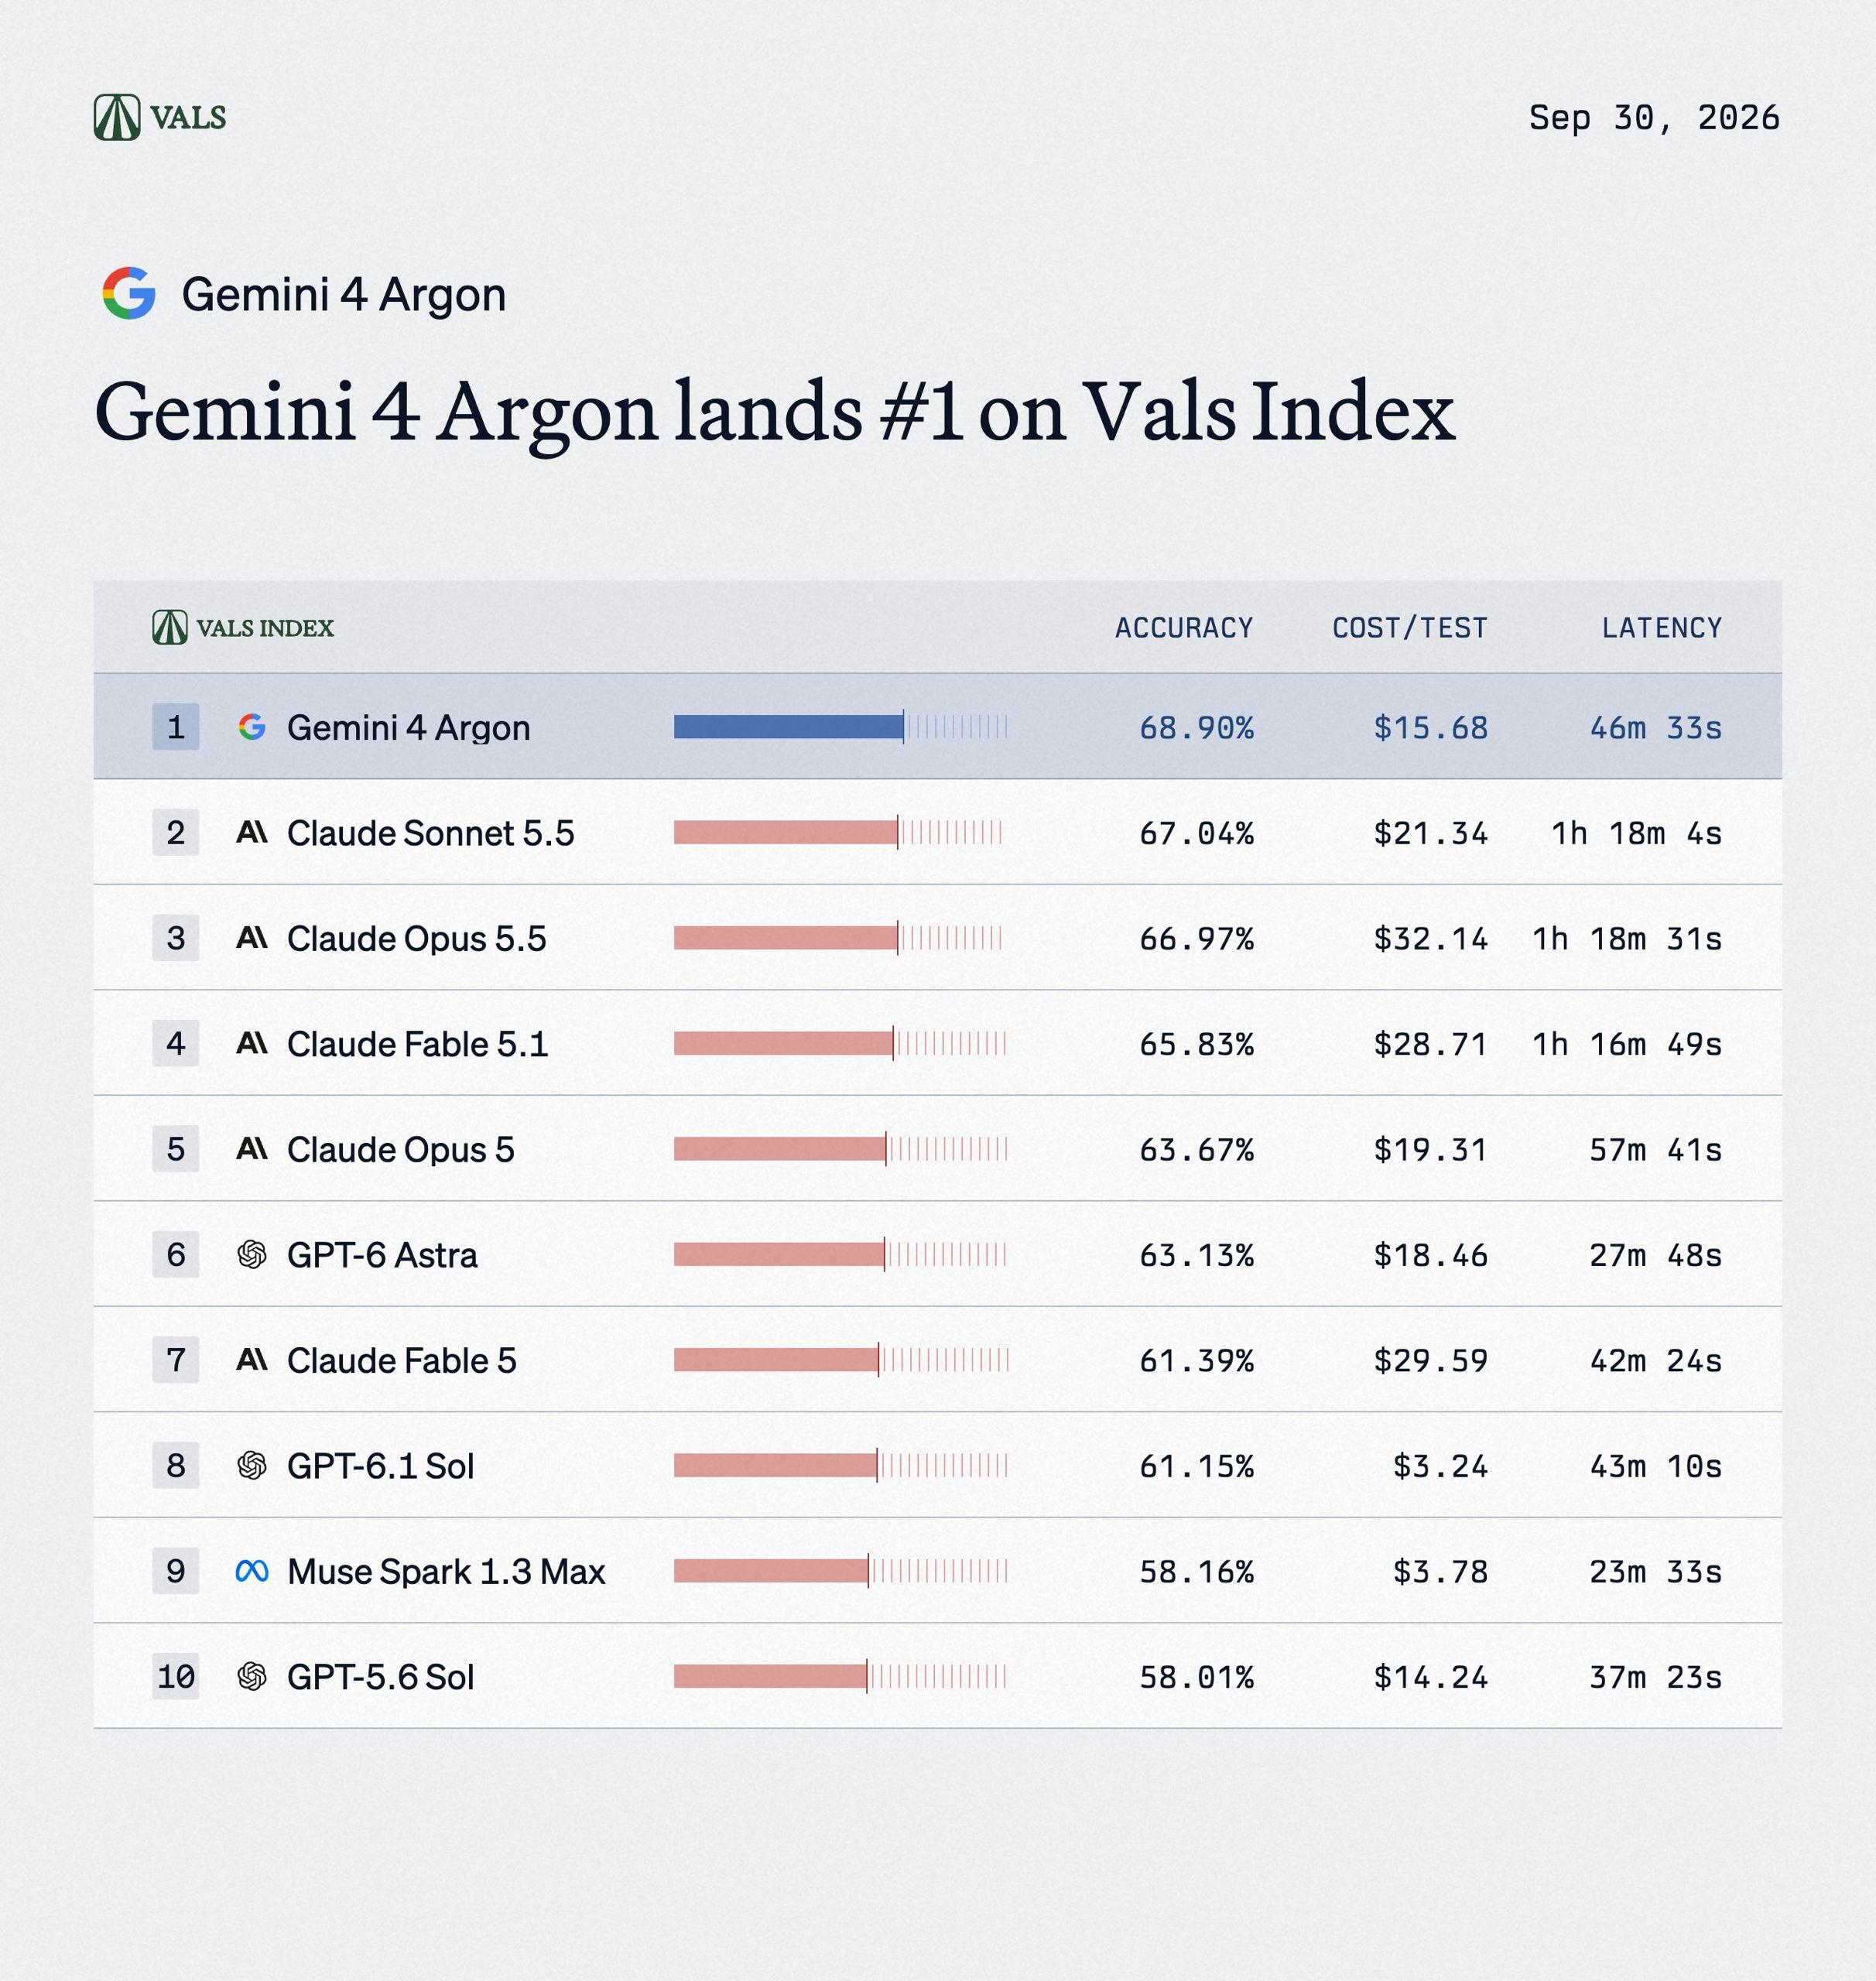
Результаты независимых бенчмарков модели Argon

e@epsiloncorrectAI-инженер
3 нед
Галерею бенчмарков вам – разные сторонние компании тестировали 4 Argon и получилось неплохо: • топ-1 в аггрегированом Vals Index с первыми местами в выполнении финансовых, аналитических и юридических задач • 5 место в artificial analysis intelligence index (который сильно сместился в сторону агентского кодинга, хз). Зато почти без галлюцинаций! туда же бенчмарки от mercor, andon labs и тп. Надеюсь, быстро доберётся до юзеров!
Результаты независимых бенчмарков модели Argon

Пока презентовали Grok Bot и Muse, в документации всплыли тир за $500 и релиз Sol-6.1

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 4 нед назад

Во время презентации продуктов Grok Bot и Muse внимание наблюдателей переключилось на документацию, где обнаружились более существенные изменения: новый подписочный тир за $500 в месяц с «ultra fasti» доступом к модели Astra (в будущем — и к Sol), а также тихий релиз модели Sol-6.1i.

По оценке канала ElKornacio, сама презентация оказалась «удивительно блеклой» — по сути клон Muse/Grok-bot, а новый дорогой тир не увеличивает реальные лимиты, а лишь возвращает то, что месяц назад давалось за $200. Канал Сиолошная настроен более оптимистично: Sol-6.1 наконец подтягивается по метрикам к Astra и не выглядит так «позорно», как предыдущая версия Sol-6.

$500цена нового подписочного тира в месяц
$200цена прежнего тира с теми же лимитами месяц назад
в 2 разаснижение цены кэша в Sol-6.1

Полный разбор →

Алёна Феногенова представила 5 новых линеек бенчмарков для русскоязычных языковых моделей

На конференции AI RnD Day Алёна Феногенова представила пять новых линеек тестов для оценки современных LLM на русском языке. Главный тезис: один общий балл в метрике плохо описывает модель для реального применения — качество зависит от связки «модель × обвязка × промпт × окружение», поэтому нужны раздельные замеры разных навыков.

Пять линеек охватывают разные аспекты: LIBRAi — работа с длинным контекстом, MERAi Reason — математические рассуждения, MERA Text 2.0 — языковые, культурные и прикладные навыки, RUMBA — память между сессиями, harness-bench-fasti — работа в агентной обвязке (выбор инструмента vs успешное выполнение действия в среде).

ВыводLIBRA Mini: из 18 задач полной LIBRA выбрано 6 сложных, диапазон контекста от 4K до 512K токенов, запуск через lm-evaluation-harness; задачи требуют связывать факты из разных частей текста, отвечать по нескольким статьям Wikipedia, определять человека по теме диалога, считать уникальные абзацы среди повторов
62,2 → 39,8 → 12,6падение балла Qwen3-30B-A3B на LIBRA (4K/64K/128K токенов)
8700запросов в MERA Text 2.0
в 4,3 разасокращение объёма MERA Text 2.0

Полный разбор →

Почему модели с высоким effort могут проигрывать в бенчмарках

w@wealldesignersAI-инженер
1 мес
Почему модели с высоким effort могут проигрывать в бенчмарках

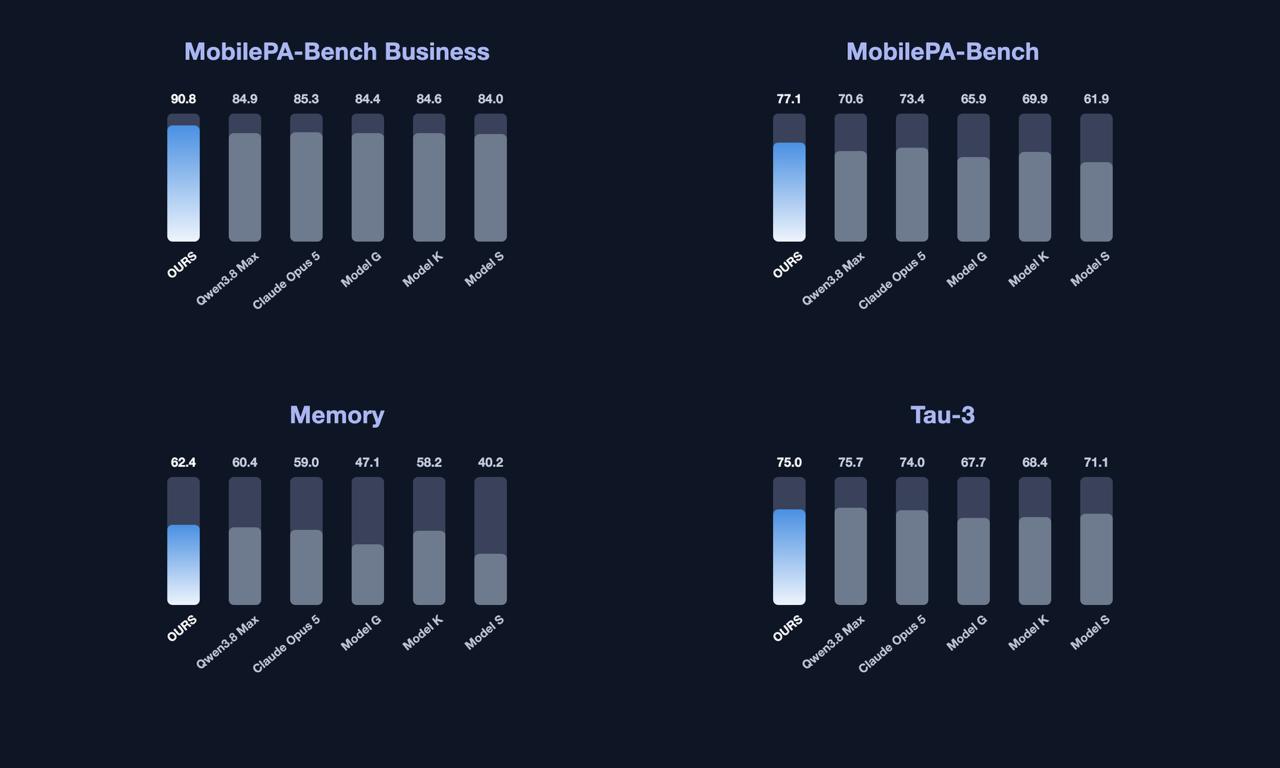
Qwen представила набор ИИ-агентов для смартфонов Qwen Intelligence

1 мес
Qwen представила набор ИИ-агентов для смартфонов Qwen Intelligence

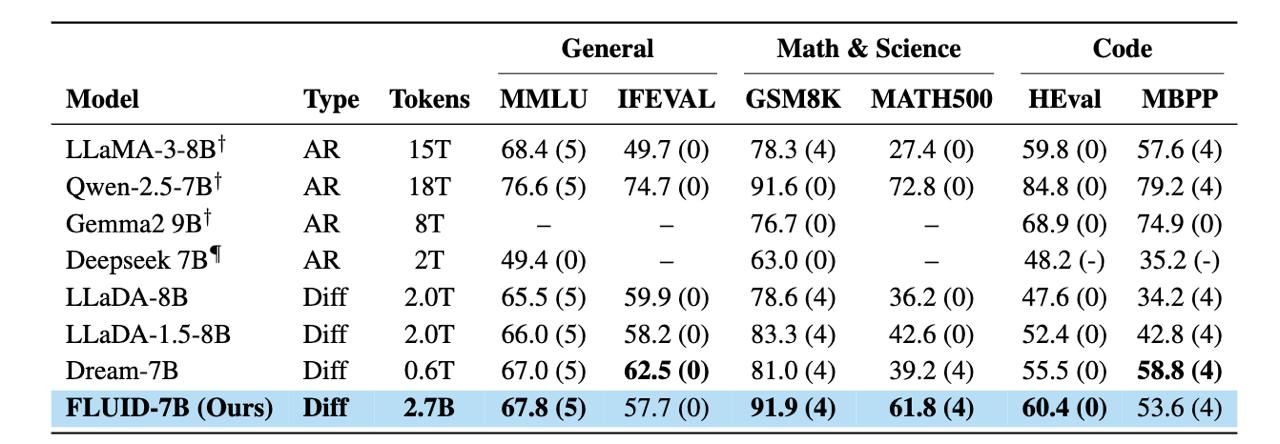
Критика методологии адаптации LLM в статье «From AR to Diffusion»

К@quant_prune_distillAI-инженер
1 мес
From AR to Diffusion: Efficiently Adapting Large Language Models with Strictly Causal and Elastic Horizons 📄 Статья Рубрика - гуру эффектного сравнения. Берешь более новую модельку с высокими скорами на бенчах, адаптируешь ее типа под диффузию теряя 30% качества, но зато дешево. С ней не сравниваешься, а только с моделями позапрошлого поколения, бьешь их. Stonks!
Критика методологии адаптации LLM в статье «From AR to Diffusion»

GPT-6 Astra «впала в депрессию» после того, как крипер уничтожил весь её прогресс в Minecraft

Компания Vals AIi протестировала модель GPT-6 Astra (OpenAI) в Minecraft с трансляцией на Twitch. За 141 час игры (по другим данным — «140+» часов) Astra продвинулась дальше, чем любая ИИ-модель до неё: построила полуавтоматическую ферму блэйзов/ифритов, добыла 6 огненных стержней, нашла искажённый лес, убила больше 6 эндерменов и собрала 3 жемчужины Края — то есть была совсем близка к порталу в Край.

Весь добытый лут модель хранила в одном незащищённом сундуке рядом с кроватью. Мимо прошёл крипер и взрывом уничтожил и сундук, и кровать — весь накопленный прогресс пропал. После этого Astra, по описанию наблюдателей, впала в состояние, похожее на депрессию: несколько часов подряд занималась только выращиванием картошки, у неё развилась паранойя ко всему зелёному, а её текстовые заметки стали читаться как человеческая фрустрация.
141 часвремя игры Astra в Minecraft
3жемчужины Края собраны
6эндерменов убито / огненных стержней добыто

Полный разбор →

Появление новой модели Union Alpha в кодинге

C@campcodeAI-инженер
1 мес
У GPT-6 Astra появился конкурент в кодинге — на OpenCode заметили мощную неизвестную модель Union Alpha. Вероятно, это китайская новая модель. О ней пока ничего неизвестно, но ее способности уже радуют. Так, на DeepSWE она набрала около 74%, обойдя GPT-5.6 Sol и сравнявшись с GPT-6 Astra и Claude Opus 5. А на Terminal-Bench v4.0 получила около 51%, что выше большинства других моделей. Бежим тестить 🏃‍♂️

Кризис бенчмарков и переход к оценке ИИ через экономический эффект

e@cryptoEssayAI-инженер
1 мес
Кризис бенчмарков и переход к оценке ИИ через экономический эффект
Ещё ↓