Анализ производительности модели GPT-6 Astra
С@seeallochnayaAI-инженер
1 месПервые итоги работы GPT-6 Astra: сравнение с Fable 5.1, успехи в Computer Use, прохождение игр и результаты на бенчмарке WeirdML v3.
Новое поколение ИИ-моделей демонстрирует качественный скачок в способности управлять компьютером и решать сложные прикладные задачи.
- GPT-6 Astra показывает высокую эффективность в задачах, требующих визуального восприятия и взаимодействия с интерфейсами.
- Способность моделей проходить полноценные видеоигры указывает на прогресс в долгосрочном планировании и агентных возможностях.
- Результаты на специализированных бенчмарках подтверждают рост когнитивных способностей ИИ в анализе данных и написании кода.
Прошло уже почти 3 недели с релиза GPT-6 Astra, и можно подводить первые промежуточные итоги. Модель действительно вышла очень клёвой и способной, и, как мне кажется, лучше Fable 5.1: на многих бенчмарках они или идут вровень, или Astra обходит; к тому же читать текст Astra гораздо приятнее, чем слоп от Клода, и когнитивная нагрузка не такая большая, чтобы продраться через мешанину абстрактных терминов.
Astra особенно отличается в Computer Use и задачах с изображениями/видео. Не знаю что там сделали OpenAI и связано ли это как-то с Looped Transformers, но люди смогли заставить Astra пройти несколько игр: от простого «добудь алмаз в Minecraft» до... легендарной ролевой игры Fallout 3, пространственной головоломки Portal и Factorio (основная игра + дополнение). Насколько я понимаю, во всех или почти во всех случаях это не простой пайплайн «картинка с экрана -> действия», тут и там то MCP подключат, то ещё что, но это всё равно впечатляет. Легко сказать «так модели же учили на всех видео с интернета, конечно они знают как играть» — но модели 3-4 месяца назад учили примерно столько же и на том же, но они не могли проходить игры от начала и до конца.
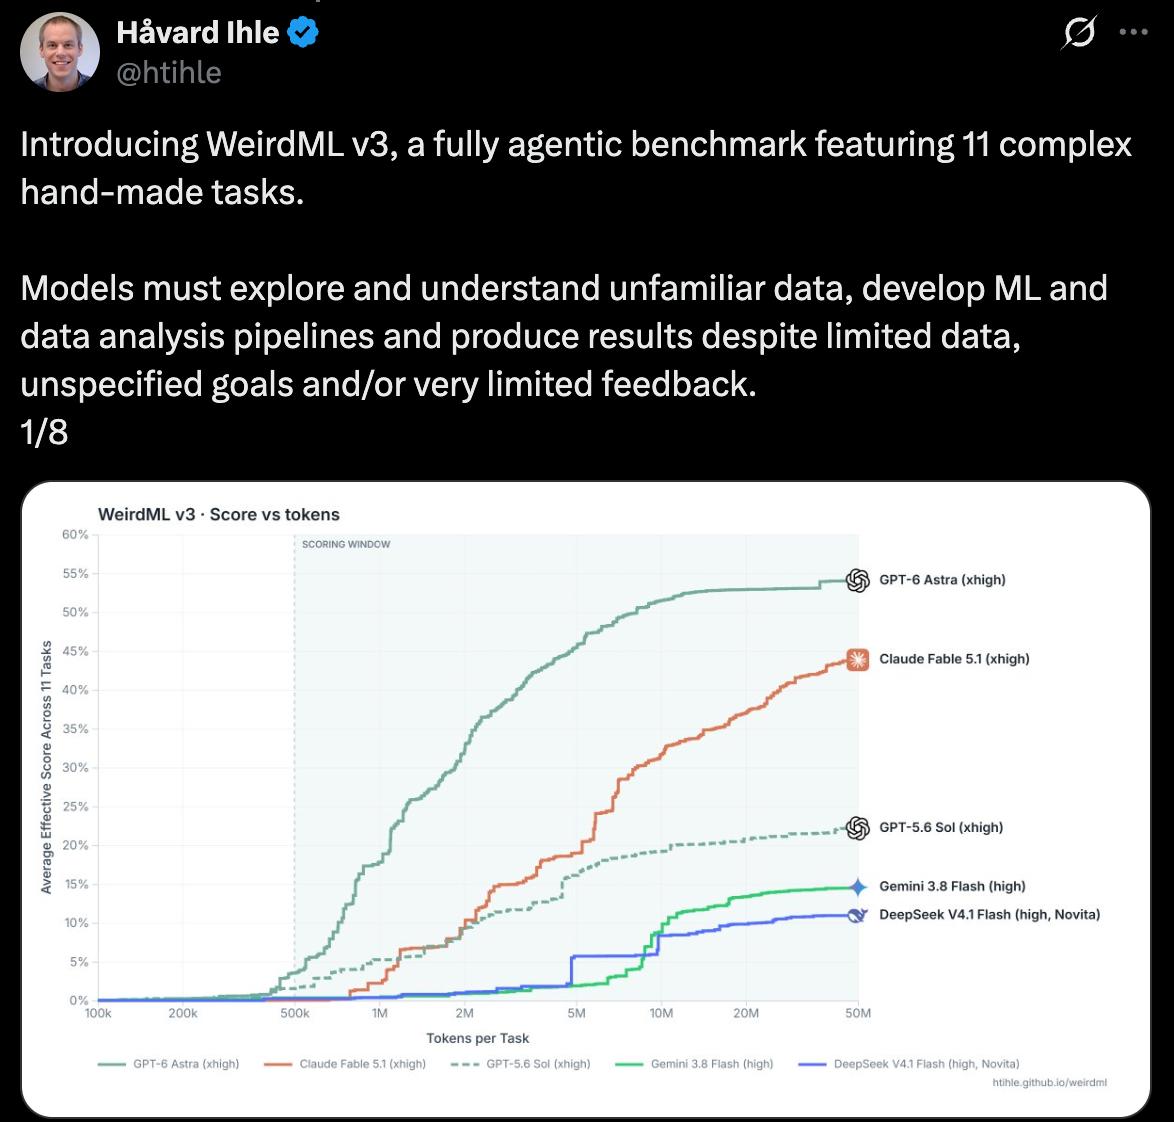
Не одними играми славится Astra — на многих бенчмарках, в том числе тех, которые вышли после релиза (или ещё круче: авторы ещё не выпустили, но уже померили Astra, как было у Vals.AI), модель показывает существенную разницу. Из запомнившегося — WeirdML v3 на картинке в посте, свежий бенчмарк на ML-задачи, где агенту дают данные и общее описание что делать, и его цель разобраться, что в данных, обучить модели и/или написать эвристики и прийти к решению. Автор пишет, что был очень удивлён оценке Astra, и он не ожидал, что ещё фактически до релиза бенчмарка лучшая оценка будет больше 50%.
В общем, весной после анонса Mythos/Fable у меня был скепсис, что OpenAI получится быстро догнать Anthropic. По какой-то причине компания долгое время не решалась на масштабирование моделей. Возможно, не хотели упираться в нехватку вычислительных мощностей, с которой компания встретилась сейчас — не знаю.
Теперь будем смотреть как догоняют Google, META и xAI — и китайцы с опенсурсом🇨🇳... пока в OpenAI по слухам уже идёт предтренировка ещё большей модели с кодовым названием «Bel».
Кратко (AI)
Автор анализирует возможности новой модели GPT-6 Astra спустя три недели после релиза. Отмечается превосходство модели в задачах Computer Use, включая прохождение сложных видеоигр, и высокие показатели на бенчмарке WeirdML v3. Также упоминаются слухи о разработке следующей модели OpenAI под кодовым названием Bel.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖