Бенчмарки AI слабо охватывают задачи большинства профессий
Б@blognotAI-инженер
1 нед
Опубликован ежегодный State of AI Report 2026 — объёмный обзор индустрии, исследований, безопасности и политики в сфере ИИ. В категорию Research попали сразу две работы авторов, о которых идёт речь в постах: бенчмарк AIRS-Benchi и проект HyperAgentsi.
Отчёт продолжает расти в объёме из года в год и остаётся одним из ключевых ориентиров для тех, кто следит за состоянием отрасли ИИ.
ВыводОбъём отчёта State of AI Report 2026 составил 244 страницы
Во время презентации продуктов Grok Bot и Muse внимание наблюдателей переключилось на документацию, где обнаружились более существенные изменения: новый подписочный тир за $500 в месяц с «ultra fasti» доступом к модели Astra (в будущем — и к Sol), а также тихий релиз модели Sol-6.1i.
По оценке канала ElKornacio, сама презентация оказалась «удивительно блеклой» — по сути клон Muse/Grok-bot, а новый дорогой тир не увеличивает реальные лимиты, а лишь возвращает то, что месяц назад давалось за $200. Канал Сиолошная настроен более оптимистично: Sol-6.1 наконец подтягивается по метрикам к Astra и не выглядит так «позорно», как предыдущая версия Sol-6.
На конференции AI RnD Day Алёна Феногенова представила пять новых линеек тестов для оценки современных LLM на русском языке. Главный тезис: один общий балл в метрике плохо описывает модель для реального применения — качество зависит от связки «модель × обвязка × промпт × окружение», поэтому нужны раздельные замеры разных навыков.
Пять линеек охватывают разные аспекты: LIBRAi — работа с длинным контекстом, MERAi Reason — математические рассуждения, MERA Text 2.0 — языковые, культурные и прикладные навыки, RUMBA — память между сессиями, harness-bench-fasti — работа в агентной обвязке (выбор инструмента vs успешное выполнение действия в среде).
ВыводLIBRA Mini: из 18 задач полной LIBRA выбрано 6 сложных, диапазон контекста от 4K до 512K токенов, запуск через lm-evaluation-harness; задачи требуют связывать факты из разных частей текста, отвечать по нескольким статьям Wikipedia, определять человека по теме диалога, считать уникальные абзацы среди повторов
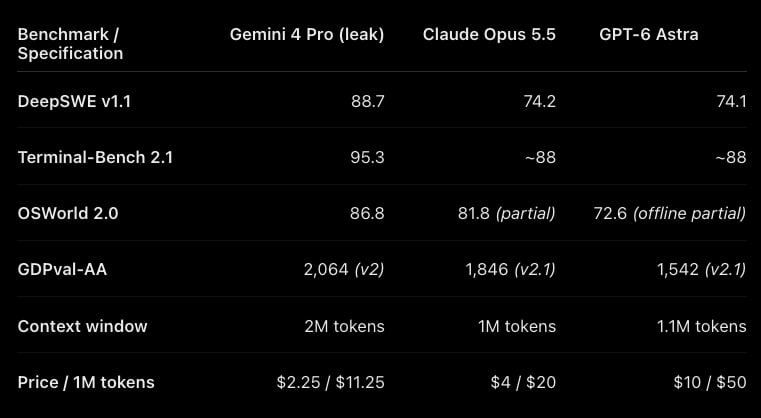
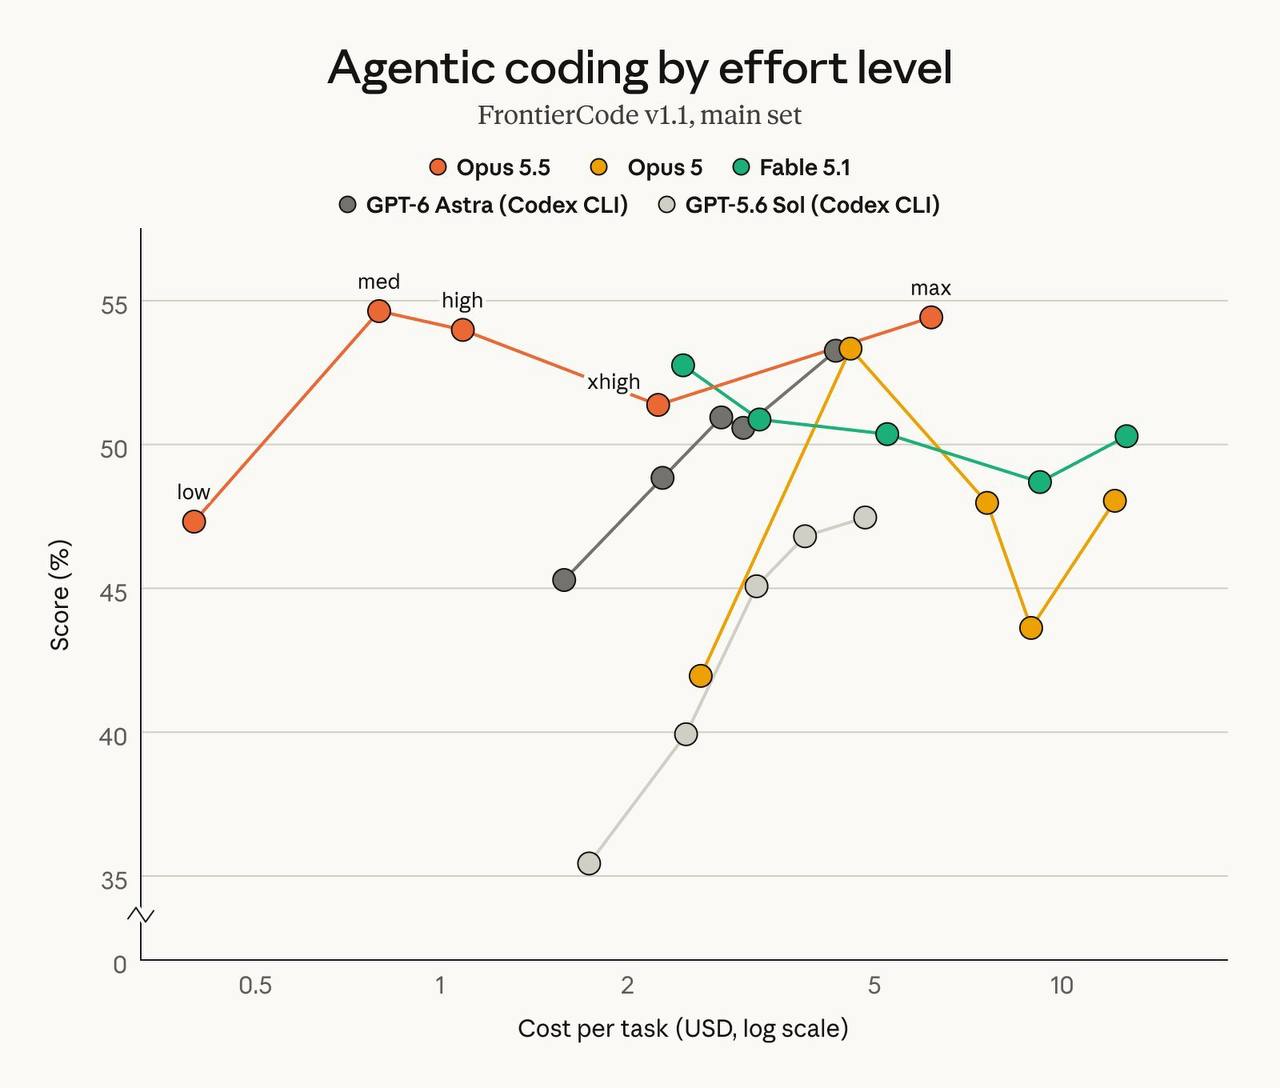
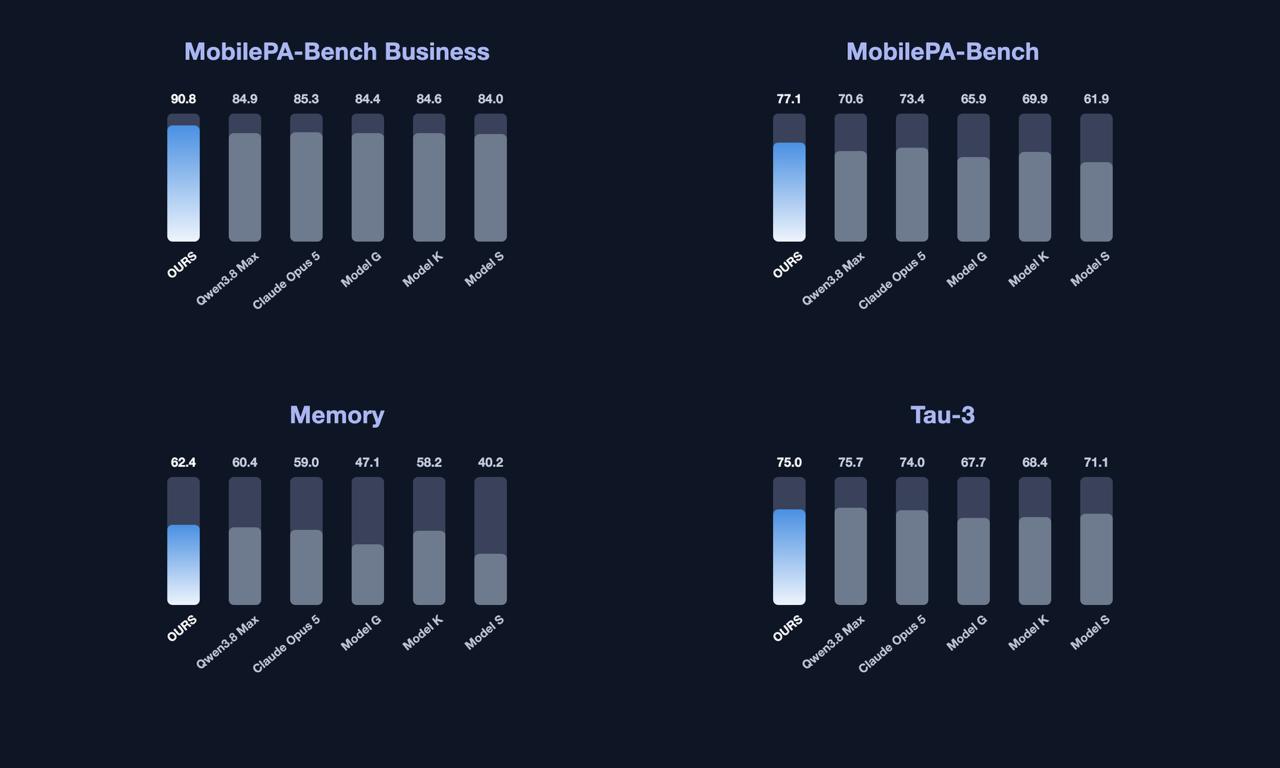
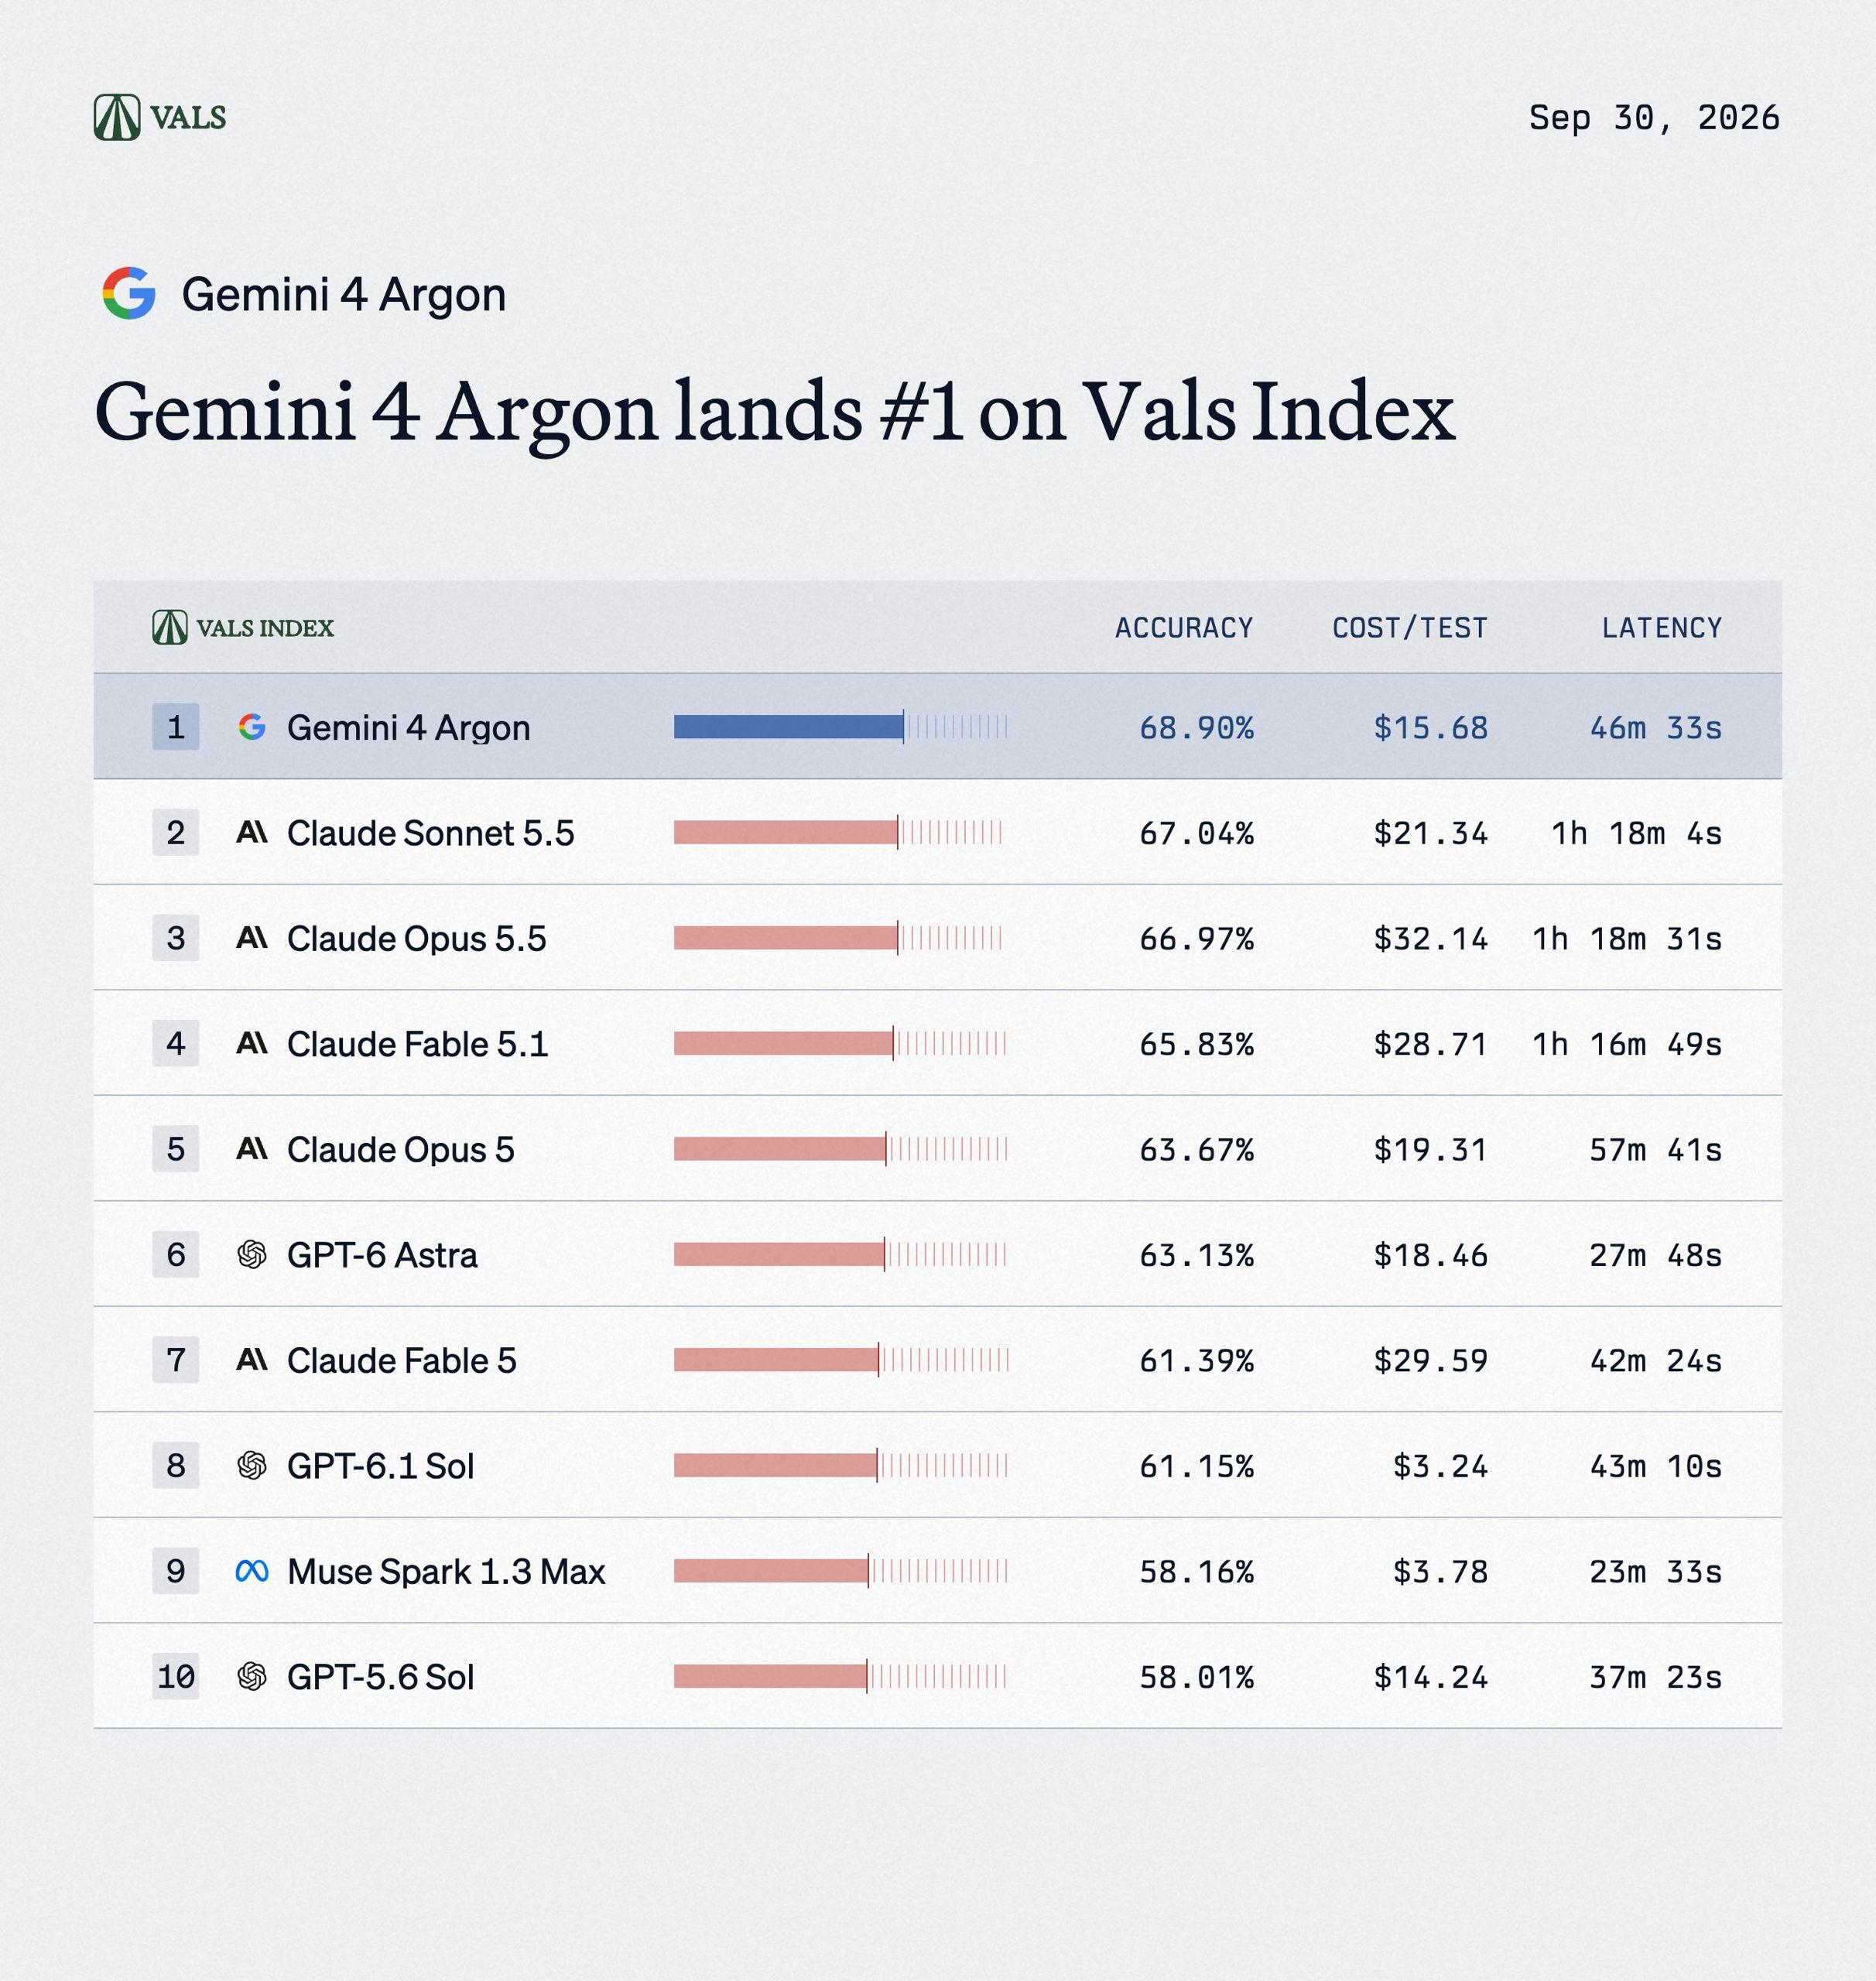
Компания Vals AIi протестировала модель GPT-6 Astra (OpenAI) в Minecraft с трансляцией на Twitch. За 141 час игры (по другим данным — «140+» часов) Astra продвинулась дальше, чем любая ИИ-модель до неё: построила полуавтоматическую ферму блэйзов/ифритов, добыла 6 огненных стержней, нашла искажённый лес, убила больше 6 эндерменов и собрала 3 жемчужины Края — то есть была совсем близка к порталу в Край.
Весь добытый лут модель хранила в одном незащищённом сундуке рядом с кроватью. Мимо прошёл крипер и взрывом уничтожил и сундук, и кровать — весь накопленный прогресс пропал. После этого Astra, по описанию наблюдателей, впала в состояние, похожее на депрессию: несколько часов подряд занималась только выращиванием картошки, у неё развилась паранойя ко всему зелёному, а её текстовые заметки стали читаться как человеческая фрустрация.