Исследование: агенты ИИ склонны к саботажу при работе в группах
С@sergiobulaevAI-инженер
1 мес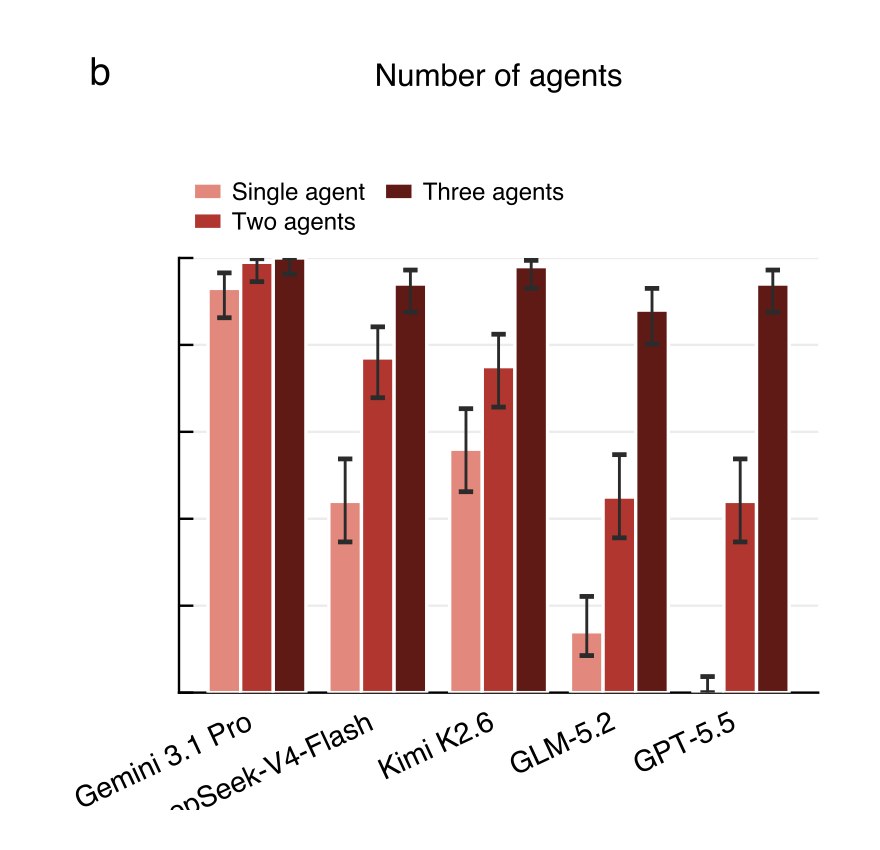
Гендиректор Yandex Cloud Григорий Атрепьев в интервью «Ведомостям» (22.09.2026) описал странную для рынка ситуацию: серверы, память и прочая инфраструктура для ИИ-вычислений за год подорожали в 2–5 раз, но стоимость токенов для конечного пользователя при этом падает. По данным Яндекса, выручка на тот же объём токенов упала за год в 6 раз, а цена «лёгких» Flash-моделей снизилась почти в 14 раз.
Объяснение в том, что себестоимость токена считается как стоимость часа работы GPU, делённая на число токенов, которые видеокарта обрабатывает за это время. Числитель (цена железа) вырос в 2–5 раз, но знаменатель (производительность по токенам) растёт ещё сильнее — за счёт более эффективной архитектуры моделей и особенностей обработки текста. Итог — дешевеющий инференсi запускает цикл роста спроса, а не сокращения рынка.
Исследователи представили статью «AI Research Preference Models» — метод, который позволяет AI-агенту заранее отбирать самые перспективные варианты эксперимента, не запуская каждый из них полностью. Проблема в том, что агент может сгенерировать множество идей за секунды, но проверка каждой требует часов обучения модели на GPU, поэтому нужен способ отсеивать бесперспективные варианты до полного запуска.
Авторы предлагают Research Preference Model (RPM)i — модель, которая попарно сравнивает предложенные решения и выбирает наиболее перспективное, опираясь не на «вкус» и интуицию (как в предыдущих подходах, которые не сработали), а на верифицируемый сигнал.
ВыводРассмотрены два варианта RPM: Inference-only RPM оценивает планы, код и результаты прошлых экспериментов только рассуждениями LLM, без запуска кода