Фазовый переход в использовании памяти: что это значит для AI
D@dealerAIAI-инженер
2 мес
Т-Технологии (Т-Банк) опубликовали на GitHub фреймворк Perseus — систему персонализации, которая объединяет действия пользователя во всех сервисах банковской экосистемы в единую хронологическую последовательность вместо отдельных рекомендательных систем для каждого продукта. Из этой последовательности строится единый эмбеддинг пользователя, который переиспользуется для разных задач — от рекомендаций товаров до оценки дохода по транзакциям.
Главная практическая проблема, которую решает Perseus — холодный стартi: когда пользователь впервые заходит в новый сервис экосистемы (например, магазин), модель может использовать его историю из других продуктов и сразу предлагать релевантные товары, не имея данных внутри самого сервиса.
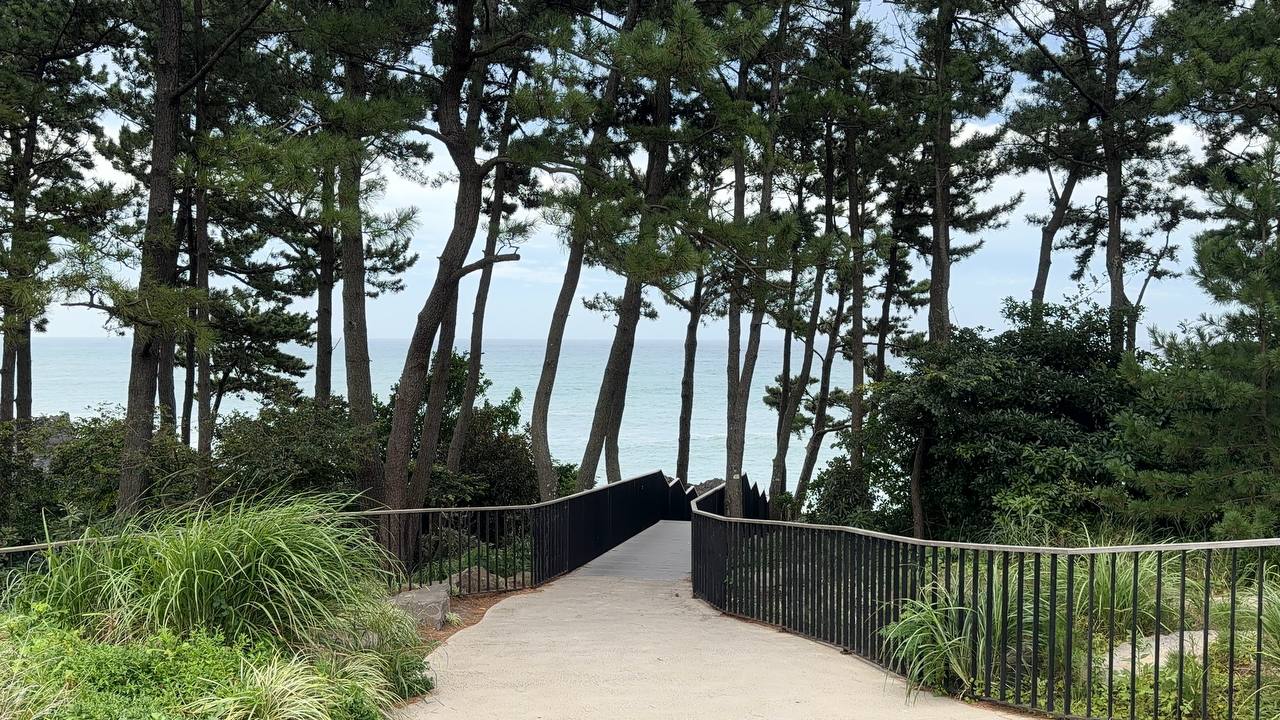
На конференции ICMLi 2026 в Сеуле — одной из крупнейших мировых конференций по машинному обучению — были представлены несколько работ исследователей Yandex Research. Делегация компании присутствовала на постерных сессиях и воркшопах, а в центре Сеула по этому случаю появилась наружная реклама на русском языке от Яндекса.
Главным результатом стала победа статьи GraphPFNi: A Prior-Data Fitted Graph Foundation Model — она получила Best Paper Award на воркшопе Graph Foundation Models: A New Era for Graph Machine Learning. Работы Yandex Research в целом были посвящены ключевым проблемам индустрии ИИ: эффективному использованию вычислительных мощностей, ускорению обучения больших моделей, работе со сложными наборами данных и снижению зависимости от ручной разметки.
Компания Tencent перевела свою модель Hy3 из статуса preview в полноценный релиз. Это мощная MoEi-модель для рассуждений, работы с кодом и агентных задач, которая, по заявлению разработчиков, обгоняет модели в 2–5 раз крупнее себя по ключевым задачам.
Особенность релиза в том, что высокая эффективность достигнута без сложных архитектурных трюков — используется обычный GQAi, без sparse attention и MLA, что, по мнению аналитиков, оставляет запас для дальнейшей оптимизации.
Сбер опубликовал в открытом доступе алгоритм KVAE-Audio, предназначенный для эффективного сжатия аудиоданных с коэффициентом 960x. Разработка оптимизирует процесс обучения диффузионных моделей и обеспечивает более высокое качество генерации звука по сравнению с аналогичными решениями от Sony, Meta и Stability AI. Новый токенизатор решает проблему компактности данных, что позволяет повысить эффективность работы генеративных нейросетей.