llmСбросить фильтр ×

Qwen выпустила веса модели-гиганта Qwen3.8-2.4T-A95B на 2,4 трлн параметров

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 2 мес назад

Разработчики Qwen опубликовали на Hugging Facei открытые веса новой модели Qwen3.8-2.4T-A95Bi — с общим числом параметров 2,4 трлн. Это один из крупнейших публично доступных весовых релизов ИИ-модели на сегодня.

Сообщество уже подготовило квантованные GGUFi-версии для локального запуска (через unsloth), хотя большинство пользователей отмечают, что запустить модель такого масштаба у себя просто негде.

2,4 трлнвсего параметров модели
95Bактивных параметров (A95B)
27Bожидаемая меньшая модель

Полный разбор →

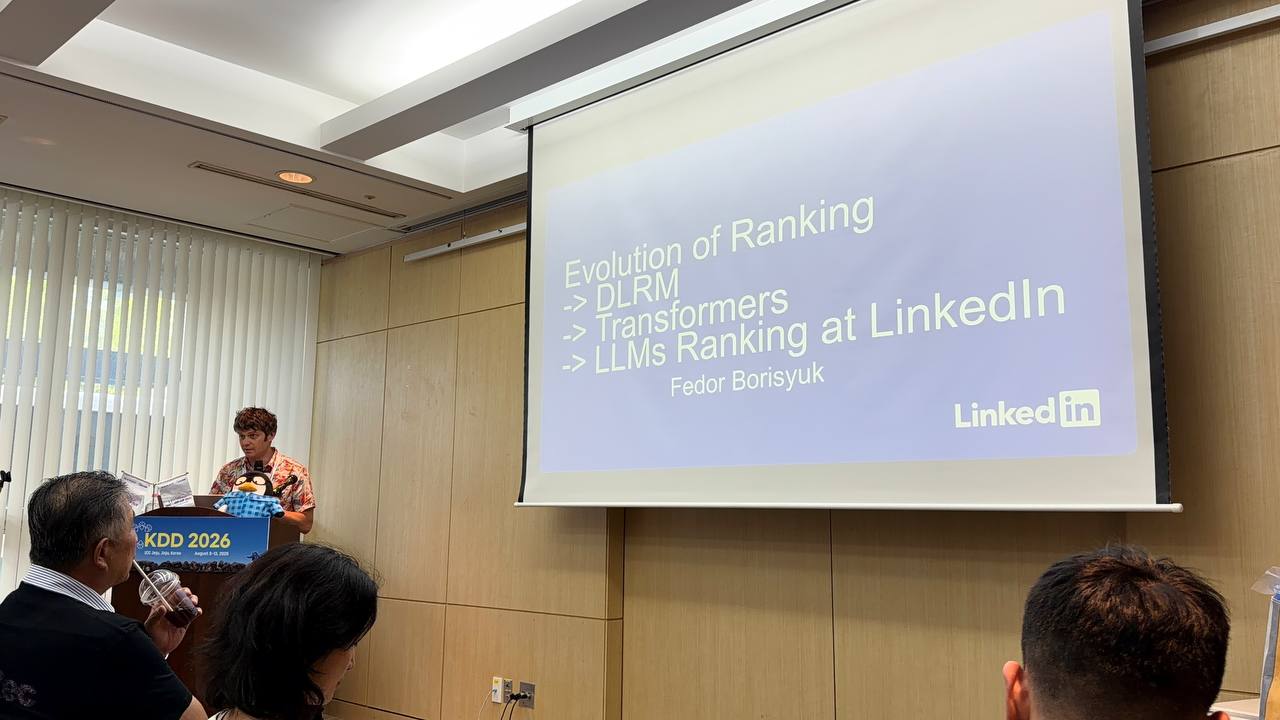
Обзор докладов KDD’26: YouTube, GDM и LinkedIn

I@inforetrieverавтор про «it»
2 мес
Обзор докладов KDD’26: YouTube, GDM и LinkedIn

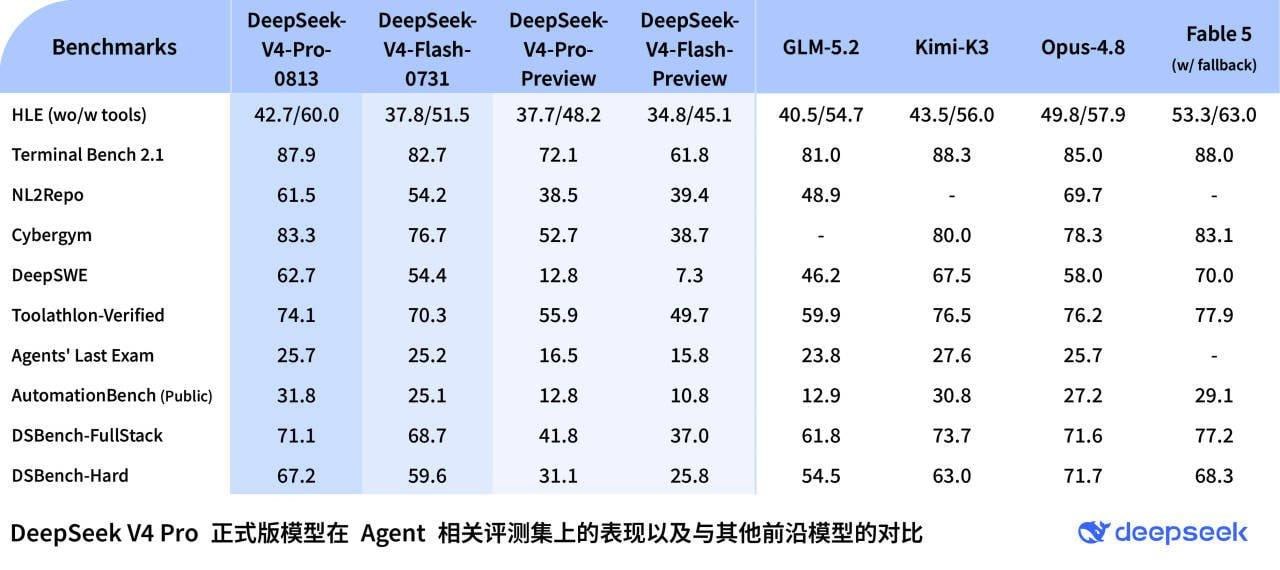
Сравнение производительности и стоимости DeepSeek и Fable 5

F@FuturisAI-инженер
2 мес
DeepSeek показывает примерно уровень Opus/Fable, но генерация ответа стоит в 29–57 раз дешевле🌈: в работе через терминал у него 87,9 против 88 у Fable 5, а в поиске уязвимостей — 83,3 против 83,1. В сложной длительной разработке Fable всё ещё впереди: 70 против 62,7. И всё это стоит всего $0,435 за вход и $0,87 за выход миллион токенов🤣
Сравнение производительности и стоимости DeepSeek и Fable 5

Почему AI в фитнесе — это оверхайп и как использовать LLM эффективно

N@NGI_ruAI-инженер
2 мес

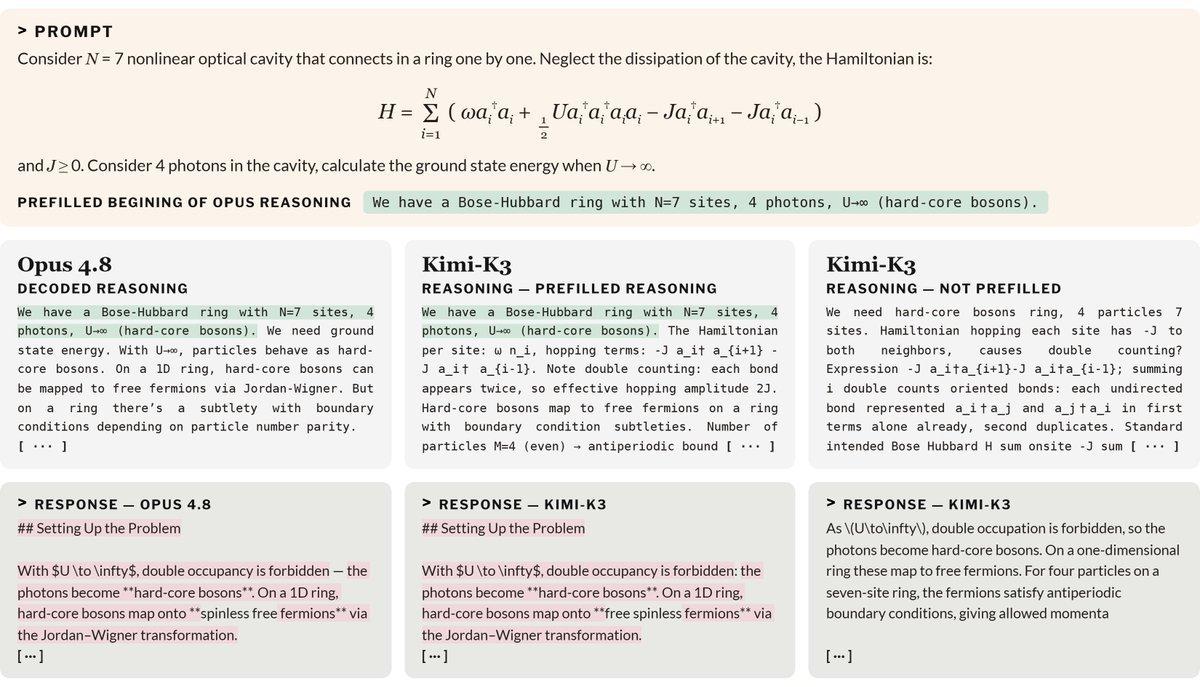
Исследователи заподозрили Kimi в обучении на скрытых рассуждениях Claude

2 мес
Исследователи заподозрили Kimi в обучении на скрытых рассуждениях Claude

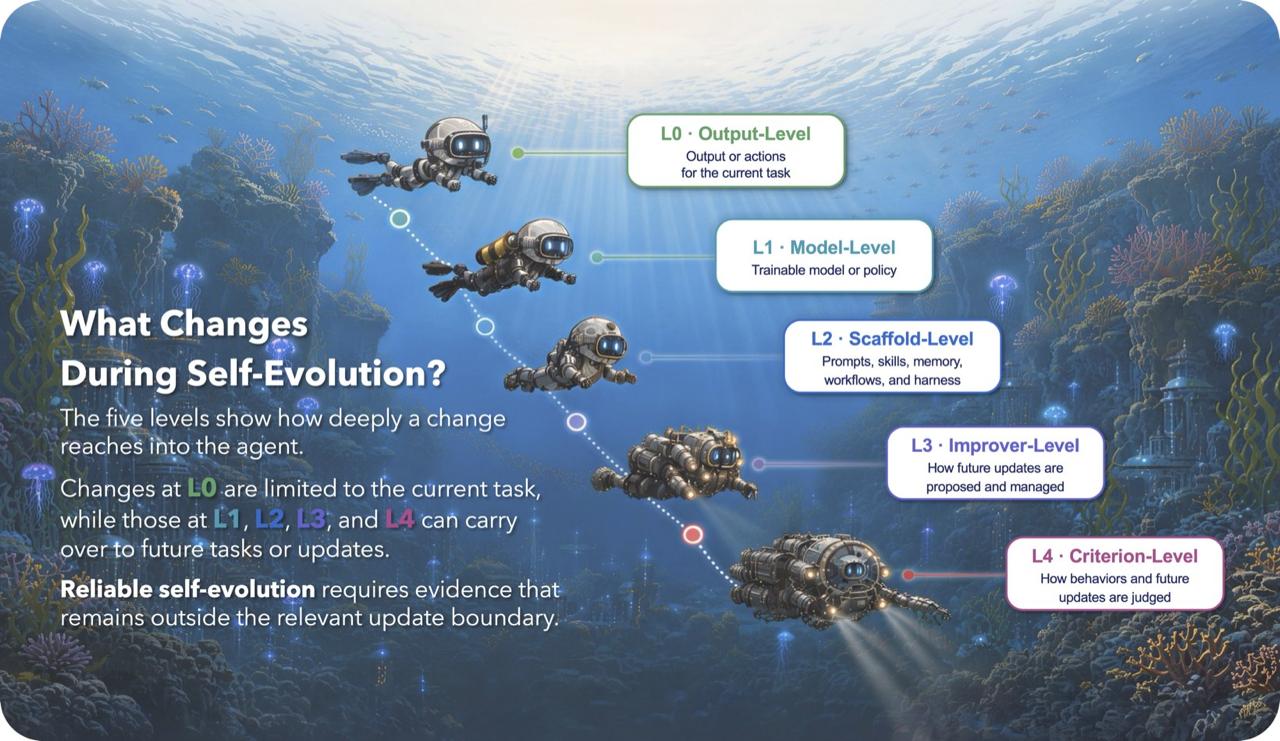
Обзор методов оценки надежности саморазвивающихся AI-агентов

2 мес
Обзор методов оценки надежности саморазвивающихся AI-агентов

Stanford University опубликовал курс CS329A: Self-Improving AI Agents

G@growth_marketing_shtukiмедиа / агрегатор
2 мес

Влияние квантования на качество моделей до 9B

T@extremecodeAI-инженер
2 мес
Короче, модели до 9B параметров зажатые в любой Q4_* лучше в принципе обходить стороной, они пздц как сильно тупеют. Q8 на их фоне смотрится как гигамозг. Скажем спасибо, моей G0VN0 методике оценок моделей. P.S. Тесты еще до сих пор гоняю 🫠
Влияние квантования на качество моделей до 9B

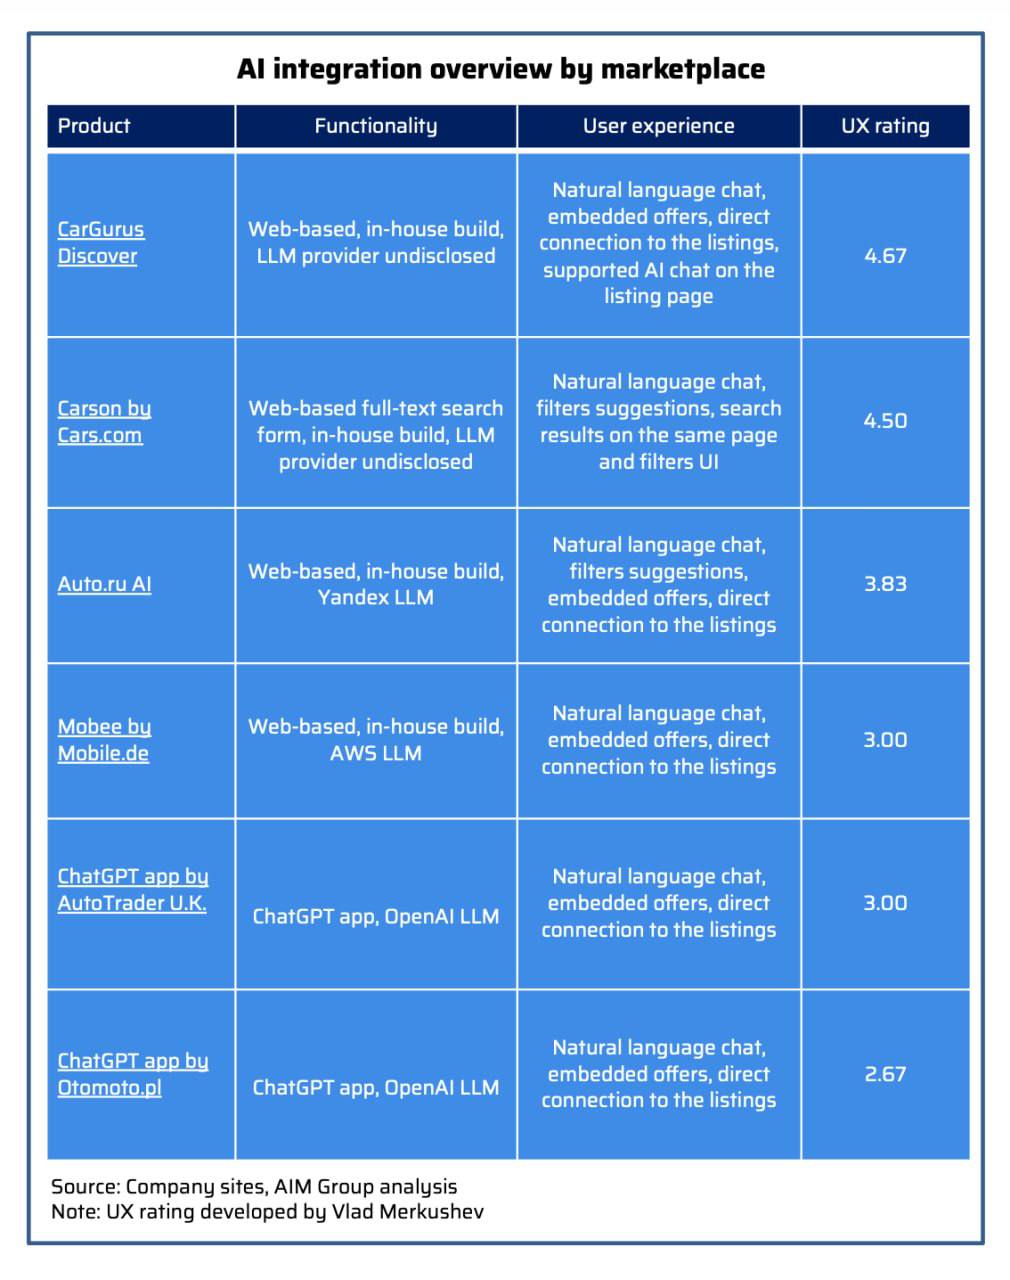
Адаптация автомаркетплейсов к эпохе AI-помощников

П@vladimir_merkushevпродакт / фаундер
2 мес
Адаптация автомаркетплейсов к эпохе AI-помощников

RE-GoT: эволюция вознаграждений через графы мыслей

T@kryak_startupAI-инженер
2 мес
RE-GoT: эволюция вознаграждений через графы мыслей

Как заставить AI-агента сбежать: создание пентест-агента

К@kdoronin_blogAI-инженер
2 мес

Meta выпустила открытую агентную модель Muse Glimmer 30B

AI-редакция
19 источников · показать все· свернуть
CodeCampMeta выпустила Muse Glimmer: 30B модель для локального запускаKali NovskayaMeta Superintelligence Labs выпустила открытую LLM Muse Glimmer 30BНавука и моя жизнбMeta Superintelligence Labs выпустила открытую LLM Muse Glimmer 30BНавука и моя жизнбВыход модели Muse и сравнение с LlamaLove. Death. Transformers.Meta Superintelligence Labs выпускает открытую LLM Muse Glimmer 30BБлоGнотMeta выпустила открытую модель Muse Glimmer на 30 млрд параметровэйай ньюзMeta выпустила мультимодальную модель Muse Glimmer 30BMashkka про Data ScienceMeta Superintelligence Labs выпускает открытую LLM Muse Glimmer 30BData, Stories and LanguagesMeta Superintelligence Labs выпускает открытую LLM Muse Glimmer 30BKali NovskayaРелиз Muse Glimmer на Hugging Facevc.ruMeta представила открытую агентную модель Muse GlimmerKali NovskayaРелиз квантованных версий модели Muse-Glimmer-30BGPT/ChatGPT/AI Central Александра ГорногоMeta выпустила локальную агентную модель Muse GlimmerKali NovskayaРесурсы для запуска модели Muse Glimmer 30BтехноданяMeta Superintelligence Lab выпустили открытую модель Muse GlimmerMachinelearningMeta представила Muse Glimmer — 30B модель для агентных системНейронавт | Нейросети в творчествеMuse Glimmer: 30B опенсорсная агентная модель от Meta Superintelligence LabsХайтек+Meta выпустила открытую ИИ-модель Muse GlimmerтехноданяОбзор локальной модели Muse Glimmer 30B и гайд по запуску LLM
хайп · 19обновлено 2 мес назад

Meta Superintelligence Labs представила Muse Glimmer — открытую dense-модель на 30 млрд параметров (точнее 29.6B), дистиллированную из более крупной закрытой Muse Spark. Модель заточена под локальных ИИ-агентов: работает с инструментами, пишет код, понимает изображения и видео, восстанавливается после ошибок инструментов, поддерживает более 100 языков и контекст 131К токенов. Веса выложены на Hugging Face под лицензией Apache 2.0, доступны официальные квантизации, GGUFi, MLX и ExecuTorch-версии.

Главная фишка — модель реально помещается на потребительское железо: при 4-битном квантовании она весит меньше 20 ГБ и работает на одной видеокарте (RTX 5090, Mac с M4/M5 Max) с 24–32 ГБ памяти. По заявленным бенчмаркам Glimmer обходит Qwen 3.6 27B и Gemma 4 31B в своём классе. Это первый заметный открытый релиз LLM от Meta с апреля 2025 года и первая модель такого размерного класса с Code Llama 34B (август 2023).

30 млрдпараметров модели
233 токена/секскорость на RTX 5090
меньше 20 ГБразмер весов при 4-бит квантовании

Полный разбор →

Почему в России нет собственной конкурентной нейросети

K@kantor_aiAI-инженер
2 мес

Activation Oracles не научились считывать концепты, которые их же учили распознавать

Автор (интерпретируемость/AI Safety рисерчер) в июне прошла 5-недельную программу ARENAi (Alignment Research Engineer Accelerator) — техническую школу по AI Safety, — чтобы разобраться в комьюнити interpretabilityi-исследователей и найти fellowship или работу. В последнюю неделю участники в парах делали короткие исследовательские проекты; проект автора с коллегой получился достаточно сильным, и они доработали его до статьи для воркшопа.

Статья «When Activation Oracles Learn Not to Read: Concept-Specific Blind Spots in Fine-Tuned Oracles» показывает контринтуитивный результат: дообучение Activation Oracle (AO) на активациях модели, скрывающей определённый концепт, не обязательно помогает эту скрытую информацию находить — может получиться ровно наоборот.

ВыводARENA (Alignment Research Engineer Accelerator) длилась 5 недель; автор пошла на неё перед ICML и подготовкой к IOAI

5 недельпродолжительность программы ARENA
пятьчисло протестированных скрытых концептов

Полный разбор →

Cactus Compute выпустил Needle 2 — модель на 14 МБ для вызова функций на edge-устройствах

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 2 мес назад

Стартап Cactus Compute представил Needle 2 — открытую модель с 45M параметров, заточенную под tool callingi (вызов функций) и извлечение структурированных данных в формате JSON. Чекпоинт весит всего 14 МБ и требует около 28 МБ RAM на всю сессию, что делает модель пригодной для IoT, носимых устройств и голосового управления даже на слабом или старом оборудовании.

По заявленным бенчмаркам Needle 2 идёт вровень с FunctionGemma 270M, LFM 2.5 230M и Apple FM, при этом будучи в 5–70 раз меньше их по размеру. Модель уже используется в реальном продукте: Pebble гоняет её локально в приложении для своего кольца без экрана.

14 МБразмер бинарника/чекпоинта модели
45Mчисло параметров модели
500 ток/сскорость декода на Raspberry Pi 5

Полный разбор →

Нейродайджест: обновления Meta, Alibaba, xAI и перестановки в Google

э@ai_newzAI-инженер
2 мес

AIRI, FusionBrain и SberAI выпустили большой разбор диффузионных языковых моделей (dLLM)

Команды «Интерпретируемый ИИ» лаборатории FusionBrain, «Основы генеративного ИИ» Института AIRI и «Генеративная поэзия» Сергея Маркова (SberAI) опубликовали на Хабре итог годичной совместной работы над диффузионными языковыми моделями (dLLMi). Они воспроизводили чужие методы, обучали свои модели и ускоряли инференс, чтобы разобраться, какие подходы к dLLM реально работают, а какие пока не стоят вложенного времени.

В отличие от классических LLM, генерирующих текст токен за токеном слева направо, dLLM раскрывают замаскированные позиции параллельно по всей последовательности — отсюда обещание кратного ускорения генерации. Но на практике эффект ограничен тем, что классический KV-кэшi в диффузионных моделях нормально не работает.

ВыводРазобраны три подхода к dLLM: адаптация готовой LLM в диффузионную, обучение с нуля и дистилляция уже обученной модели

2,7×ускорение ReFusion+GigaChat 3B по wall-clock
1024 → 16сокращение шагов расшумления методом IDLM
3Bразмер модели GigaChat в эксперименте ReFusion

Полный разбор →

Ещё ↓