Matrix-Game 4.0: игровая видеомодель мира в реальном времени
AlayaLab представила открытый 3D-стек MeshAxiom для агентов
«Маленький принц»: игровую сцену собрали преимущественно на Opus
Браузерная игра по «Маленькому принцу» создана с использованием Opus 5.5, Tripoi и Blender. Сцена собрана преимущественно на Opus; автор обзора отмечает, что для работы со стеклом потребовалась ручная правка.
Игра выглядит мило, но пока скорее предлагает интерактивное повествование, чем полноценный геймплей: сюжет нельзя изменить, а исследование локаций почти не вознаграждается. Проект показывает, что такие сцены можно создавать с помощью ИИ-инструментов, но сам по себе не устраняет трудности разработки увлекательной игры.
Почему отбор вариантов становится важнее их генерации
Плагин PureRef Connector для ComfyUI
MCP Blender генерирует 3D-сцены с освещением и текстурами
Релиз FastH3-Omni: открытая модель для генерации видео в реальном времени
Cамая быстрая и качественная на данный моментПост-трейнинг от FastVideo (haoailab) совместно с nuvalab. • Кондиционирование по первому и последнему кадру • Аудио-вход и сильная работа с диалогами • До 3 референс-изображений • Производительность уровня фронтира Эксклюзивное превью на Reactor API до 20 октября 2026 Потом - опенсорс #realtime #api MAX
Ошибки генерации нейросетей
EVOVA: браузерный редактор 3DGS с ИИ
AI-Toolkit получил встроенный интерфейс для генерации контента
Сравнение Claude Opus 5.5 и GPT-6 Astra в генерации подводного мира
Odyssey выпустила Odyssey-3 — модель для генерации интерактивных миров в реальном времени
Калифорнийский стартап Odyssey, основанный выходцами из индустрии беспилотных автомобилей, представил Odyssey-3 — модель, которая по текстовому запросу или картинке создаёт интерактивное 3D-окружение и просчитывает движение и взаимодействие объектов в реальном времени. Внутри сгенерированного мира можно перемещаться от первого или третьего лица, управлять камерой и на ходу добавлять события, на которые сцена реагирует.
Odyssey позиционирует продукт не только как развлечение, но и как симулятор для обучения роботов, беспилотных автомобилей и других физических систем — поверх модели обучают отдельные декодеры действий и политики управления. Попробовать модель можно бесплатно на сайте компании, тогда как ранее похожую функциональность (модель Geniei от Google) приходилось оплачивать — по словам источников, порядка $240.
Обзор пакетов нод для работы с моделью Iris-3B в ComfyUI

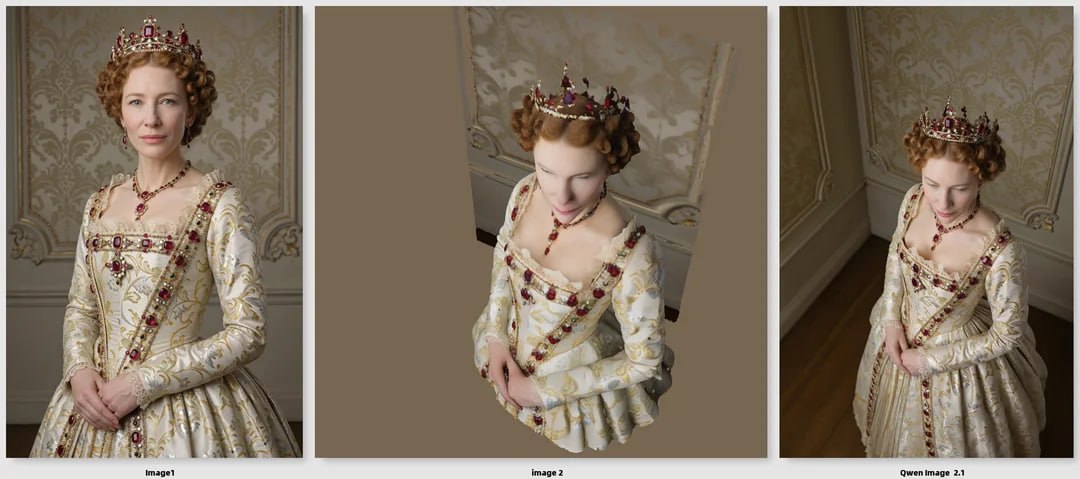
Релиз Qwen-Image-2.1 и инструменты для генерации

PAMI: генерация взаимодействий человека с объектами
ROME: генерация 3D-сцен из одного изображения
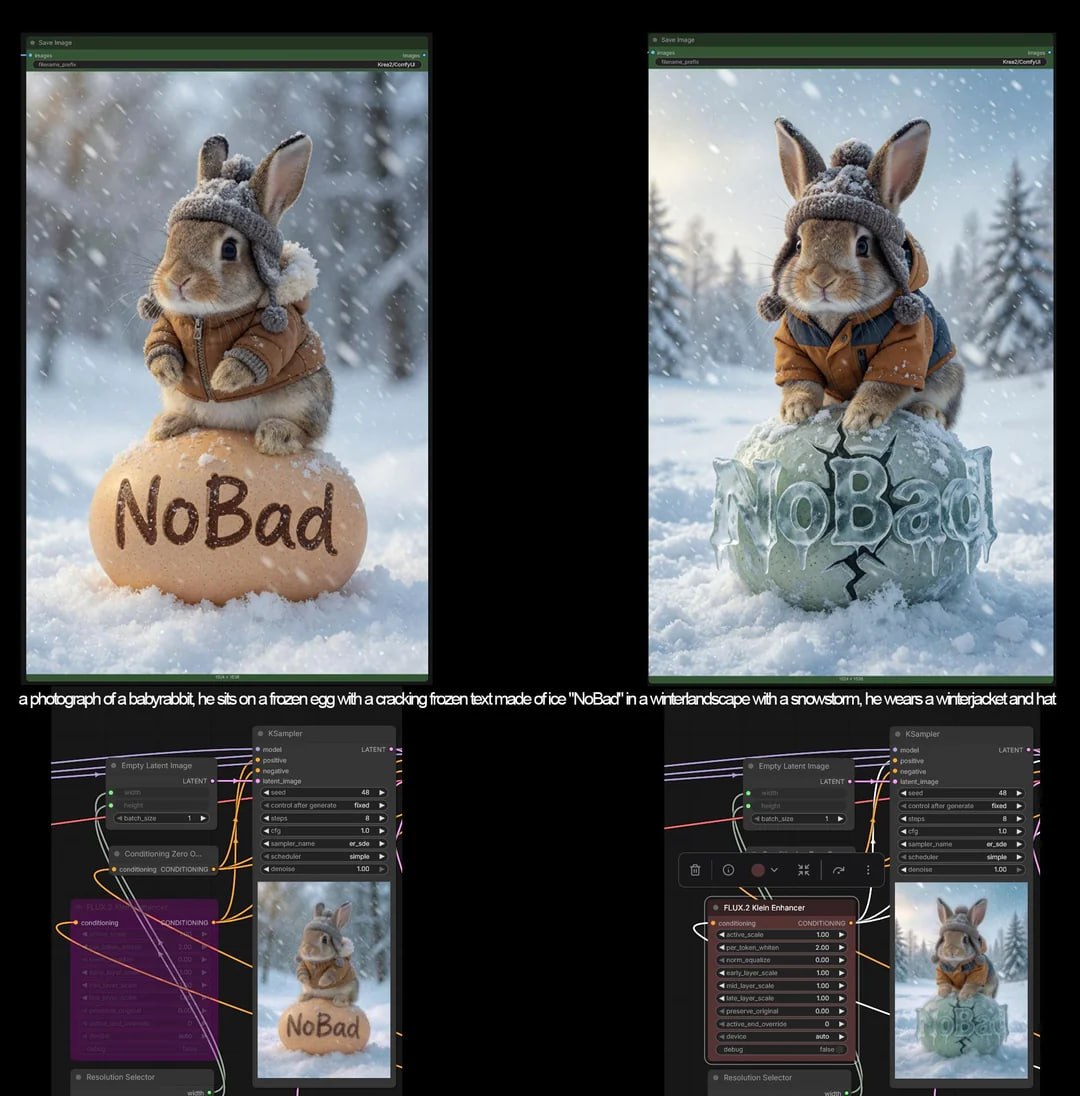
Обзор инструментов и моделей для Krea 2

UltraTex: генерация текстур для 3D-моделей
DistScene: генерация 3D-сцен из одного изображения
Representation-Space MMD: новый метод дистилляции диффузионных языковых моделей
Исследователи (в статье упоминаются «два Ильи и Дима») перенесли MMDi-лосс, ранее показавший себя в дистилляции диффузионных картиночных моделей, на диффузионные языковые модели. Подход заметно улучшает баланс качество/скорость (Парето-фронт) при генерации текста, снижая число шагов инференса без существенной потери качества.
Идея развивает более раннюю работу тех же авторов Scale-wise Distillation of Diffusion Models, где MMD-лосс применялся для ускорения диффузионных моделей изображений. Теперь аналогичная техника адаптирована под специфику текстовых диффузионных моделей — как дискретных, так и непрерывных.
ВыводMMD (Maximum Mean Discrepancy) — мера различия между распределениями P и Q через положительно определенный кернел k (линейный, RBF и др.), считается по формуле с тремя слагаемыми: E[k(x,x')] + E[k(y,y')] − 2E[k(x,y)].
Подборка инструментов и LoRA для Qwen-Image-2.1

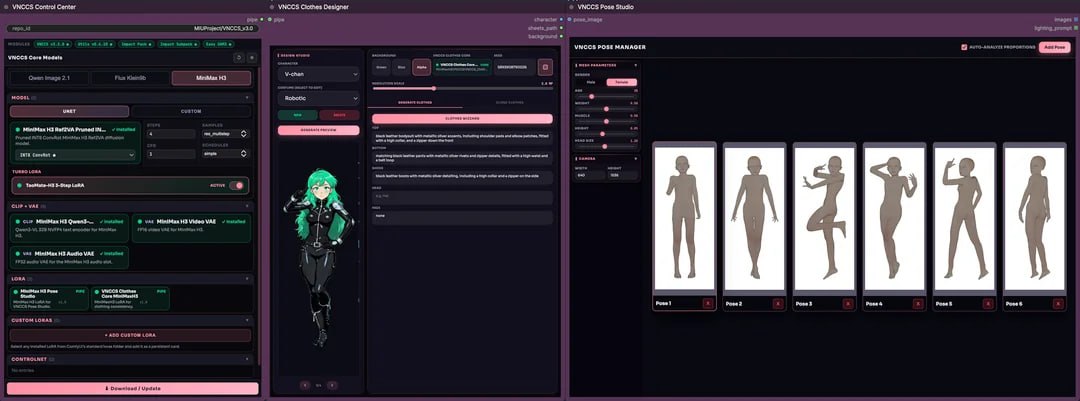
VNCCS 3.0: пайплайн для создания спрайтов персонажей в ComfyUI