квантованиеСбросить фильтр ×

MiniMax собрала каталог community-разработок для H3: ускорение, референсы и запуск на разном железе

MiniMax обновила каталог интеграций и моделей для MiniMax H3: в нём появились ускоренные варианты генерации, инструменты для работы с референсами, LoRAi и готовые ComfyUI-воркфлоу. Все перечисленные разработки созданы сообществом, а каталог ведёт сама MiniMax.

Практический эффект — H3 становится доступнее на менее мощном оборудовании и быстрее в отдельных сценариях: от работы с картинками, видео и аудио до обработки длинных клипов и замены персонажей или фона.

464 ГБполный набор весов
19,5 ГБpruned int8 для GPU 24 ГБ
27:50 → 12:55обработка клипа на 5070 Ti
Полный разбор →

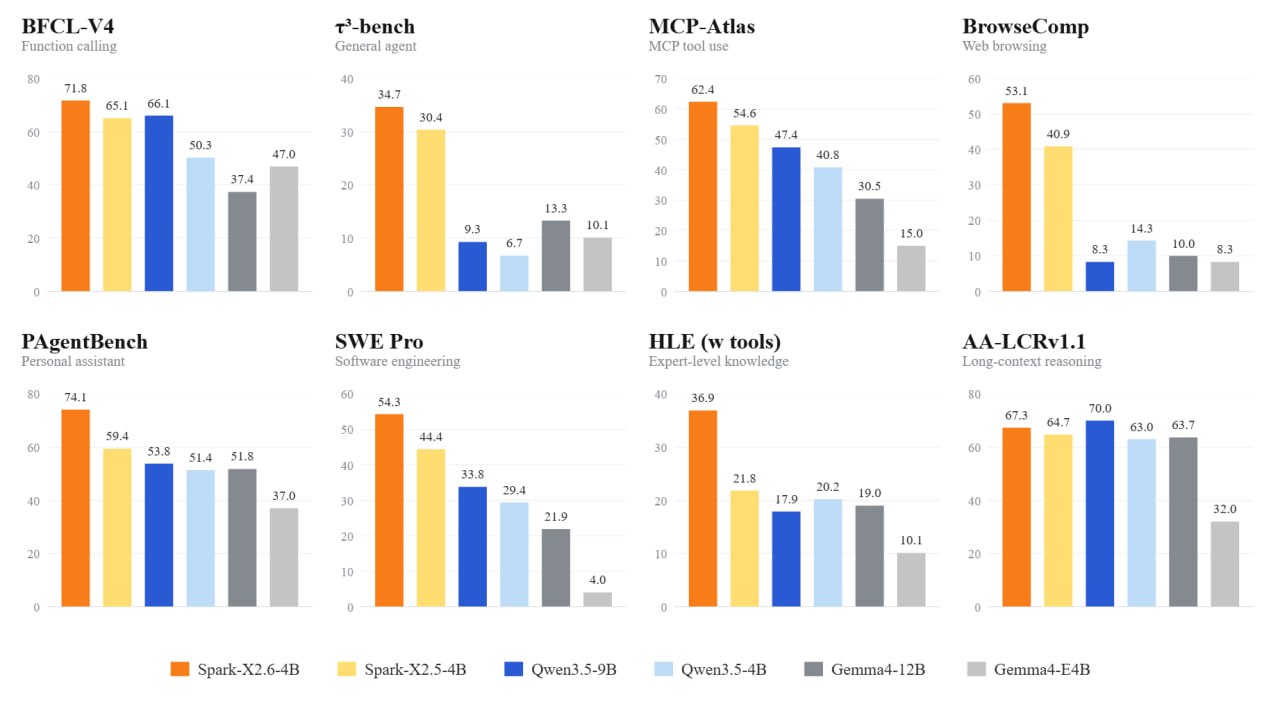
Spark-X2.6-4B: модель на 4B с контекстом до миллиона токенов

Н@GreenNeuralRobotsAI-инженер
5 дн
Spark-X2.6-4B: модель на 4B с контекстом до миллиона токенов

Диффузионный трансформер генерирует лица на ESP32-S3

Х@habr_comмедиа / агрегатор
1 нед
Диффузионный трансформер генерирует лица на ESP32-S3

На взломанной PS5 запустили локальную ИИ-модель Qwen на 27 млрд параметров

Разработчик abhi245y доработал PS5LM и выпустил PS5LM Plus — приложение, которое запускает языковые модели на GPU взломанной PlayStation 5. Модель Qwen 3.8 на 27 млрд параметров генерирует примерно 20 токенов в секунду; обработка идёт локально на консоли.

Запуск стал возможен после перехода от CPU-пайлоада к отдельному приложению с Vulkan: оно использует графический процессор и больше памяти, чем прежняя версия. Запросы к консоли можно отправлять через браузер с телефона или компьютера в домашней сети.

27 млрдпараметров Qwen
6,8 ГБразмер квантованной модели
64 тыс. токеновконтекстное окно Qwen

Полный разбор →

Iris-3B от Speridlabs: генератор изображений без VAE ускорился до 0.7 секунды

Speridlabs выпустили Iris-3B — генератор изображений, который рисует пиксели напрямую, без VAEi и латентного пространства: промпт сразу превращается в картинку 1024px, ничего не теряется при сжатии. Модель построена на одном бэкбоне, который финтюнят под разные задачи — text-to-image, оценку глубины, реставрацию и апскейл изображений.

Через несколько дней после релиза Speridlabs показали 4-шаговую версию Iris-3B: она генерирует изображение 1024x1024 всего за 0.7 секунды на GPU H100, что делает модель одной из самых быстрых в пиксельном пространстве.

3Bпараметров модели Iris-3B
0.7 секвремя генерации 1024x1024 на H100
~12 ГБразмер весов на каждую задачу

Полный разбор →

Disaggregated Quantization: раздельное сжатие prefill и decode ускоряет и дешевит инференс LLM

Команда из IST и NVIDIA (первый автор @black_samorez) предложила метод Disaggregated Quantization: этапы prefill (обработка промпта) и decode (генерация ответа) одной и той же LLM обрабатываются разными квантизациями вместо единой точности для всей модели. Идея в том, что prefill упирается в скорость матричных умножений, а decode — в скорость памяти, поэтому их стоит сжимать по-разному: prefill в NVFP4i с квантованием и весов, и активаций, decode — только по весам, в сверхлёгких 1–3-битных форматах.

По данным источника 4, метод уже работает на Qwen3 и Gemma 3 и делает инференс в два раза быстрее и дешевле, при этом точность не падает, поскольку активации на decode не квантуются. Статья, код и первые чекпоинты уже опубликованы.

ВыводСтатья опубликована на arxiv.org/abs/2609.26333, код выложен на GitHub, чекпойнты Qwen3.8 NVFP4 prefillers доступны на HuggingFace Hub

в 2 разаускорение и снижение стоимости инференса
1–3 битаточность весов на decode-этапе

Полный разбор →

Обзор новых весов и квантованных моделей на Hugging Face

Н@GreenNeuralRobotsAI-инженер
1 мес

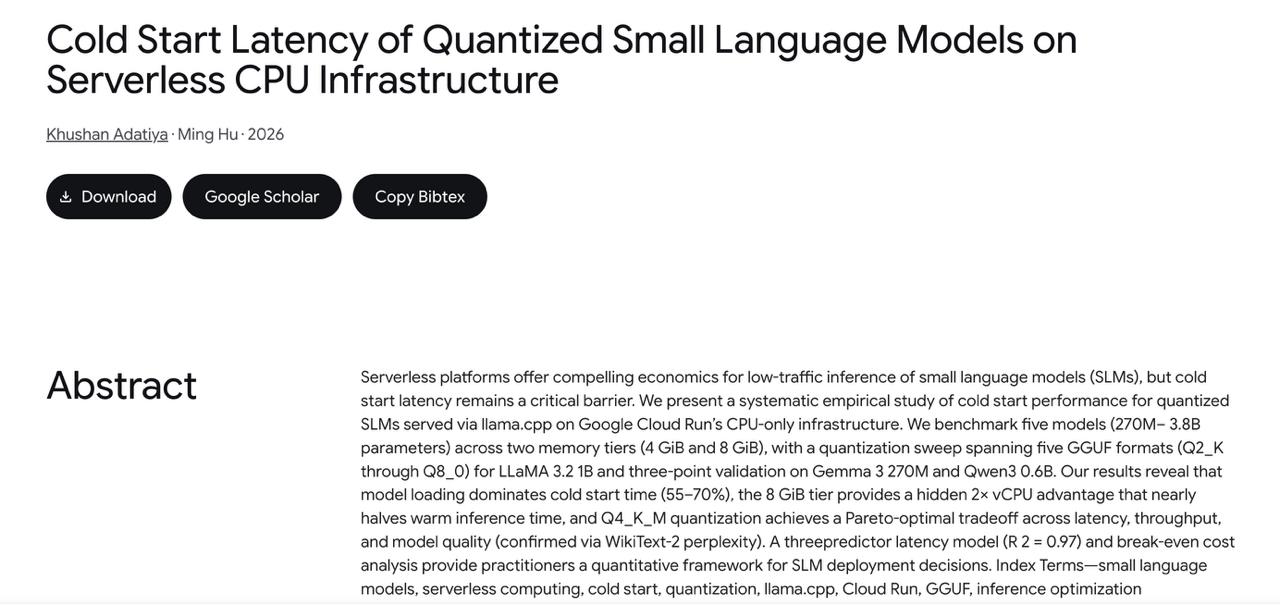
Проблемы холодного старта малых LLM в Cloud Run

1 мес
Проблемы холодного старта малых LLM в Cloud Run

Prism ML выпустила тернарную версию Qwen3.8-27B — Bonsai 2 27B

Американский стартап Prism ML, выросший из команды Калтеха, представил Bonsai 2 27B — сжатую версию модели Qwen3.8-27B в тернарном квантовании. Модель занимает 5,9 ГБ против примерно 54 ГБ у оригинала в FP16, при этом сохраняет 98,2% среднего результата исходной модели на бенчмарках.

Благодаря компактности модель рассчитана на локальный запуск на потребительском оборудовании без отправки данных в облако — целевые сценарии включают агентов в редакторе кода, работу с компьютером и разбор документов.

5,9 ГБразмер Bonsai 2 27B против ~54 ГБ у FP16
98,2%сохранённый средний результат бенчмарков
1,72 битасредний вес на параметр после сжатия

Полный разбор →

NVIDIA выпустила NVFP4-квантованную версию DeepSeek-V4-Pro с DSpark

Н@GreenNeuralRobotsAI-инженер
1 мес
DeepSeek-V4-Pro-0813-nvfp4-DSpark NVIDIA выпустила NVFP4-квант DeepSeek-V4-Pro со спекулятивным декодингом DSpark Сжали DeepSeek-V4-Pro-0813 (1.65T MoE, 49B активных) в NVFP4 и добавили DSpark. Разница с предыдущим NVFP4-релизом: теперь и draft-голова DeepSeek тоже переведена в NVFP4 (была MXFP4), так что один файл работает и как таргет, и как черновик #dspark #nvfp4 VK | MAX

Обзор новых квантованных и специализированных моделей Qwen3.8-Flash-Next и Spark-X2.5

Н@GreenNeuralRobotsAI-инженер
1 мес

Сравнение Qwen 3.8: Q8_0 против FP8

Г@gmorevaAI-инженер
1 мес
Qwen 3.8 Q8.0 против FP8 Продолжаю цепочку роликов про Qwen 3.8. Сегодня — битва двух титанов: квант Q8_0 от Unsloth (llama.cpp, 2×2080, NVLink) против официального FP8 от Qwen (vLLM, 2×3090). Условия максимально честные: у обеих 8-битный KV-кэш (вы меня убедили отказаться от 4-битного), 200 000 контекста и самый крутой режим reasoning — X-High с неограниченным бюджетом на размышления. Никаких синтетических бенчмарков — только реальные задачи из моей работы, с одного и того же промпта, параллельно. 📹 YouTube | VK | Rutube | Dzen 📹

Сообщество выпустило ускоренные GGUF-кванты и «расцензуренные» версии Qwen3.8-27B, GLM-5.3 и DeepSeek-V4-Flash

В конце августа — начале сентября 2026 года независимые разработчики и энтузиасты одновременно выпустили серию GGUFi-квантизаций флагманских открытых LLM (Qwen3.8-27B, GLM-5.3, DeepSeek-V4-Flash) с технологиями ускорения инференса DFlash2i и DSpark drafter, а также несколько версий этих моделей со снятой цензурой («abliteratedi»/«uncensored»).

Расцензуренные версии позиционируются авторами не для развлечения, а для практических задач: ред-тиминга, кибербезопасности и автономных агентов, которым мешает встроенный механизм отказа отвечать на запросы.

×1.38ускорение DeepSeek-V4-Flash на DGX Spark
$1лимит песочницы AbliterationAI
12/25результат Tiel-Coder-35B-A3B на SWE-bench-Live

Полный разбор →

Обзор ключевых технологий LLM: от токенизации до квантования и архитектур

T@extremecodeAI-инженер
1 мес
Обзор ключевых технологий LLM: от токенизации до квантования и архитектур

Z.ai открыла веса GLM-5.3, но впервые ограничила лицензию для крупных сервисов

В середине августа 2026 года китайская Z.ai выпустила GLM-5.3 — по её собственному описанию, «самую способную» модель компании для агентного программирования (agentic codingi) и киберзащиты. Это дообученная версия GLM-5.2 с 743 млрд параметров. Спустя пару недель, после оценки безопасности, компания опубликовала веса модели на HuggingFace — это полноценный релиз весов, а не просто доступ по API, так что модель можно скачивать, запускать локально и дообучать под свои задачи.

Однако, в отличие от предыдущих релизов, Z.ai отказалась от свободной лицензии MIT: теперь сервисы с годовой выручкой выше $10 млрд обязаны проходить проверку безопасности у Z.ai перед использованием GLM-5.3. Это отмечают как признак того, что китайский открытый ИИ начинает «закрываться».

743 млрдпараметров у GLM-5.3
$10 млрдпорог выручки для проверки безопасности
320B/18Bобщие/активные параметры GLM-5.3 Flash

Полный разбор →

Тестирование производительности моделей Qwen 3.8 на локальном железе

D@derplearningAI-инженер
2 мес

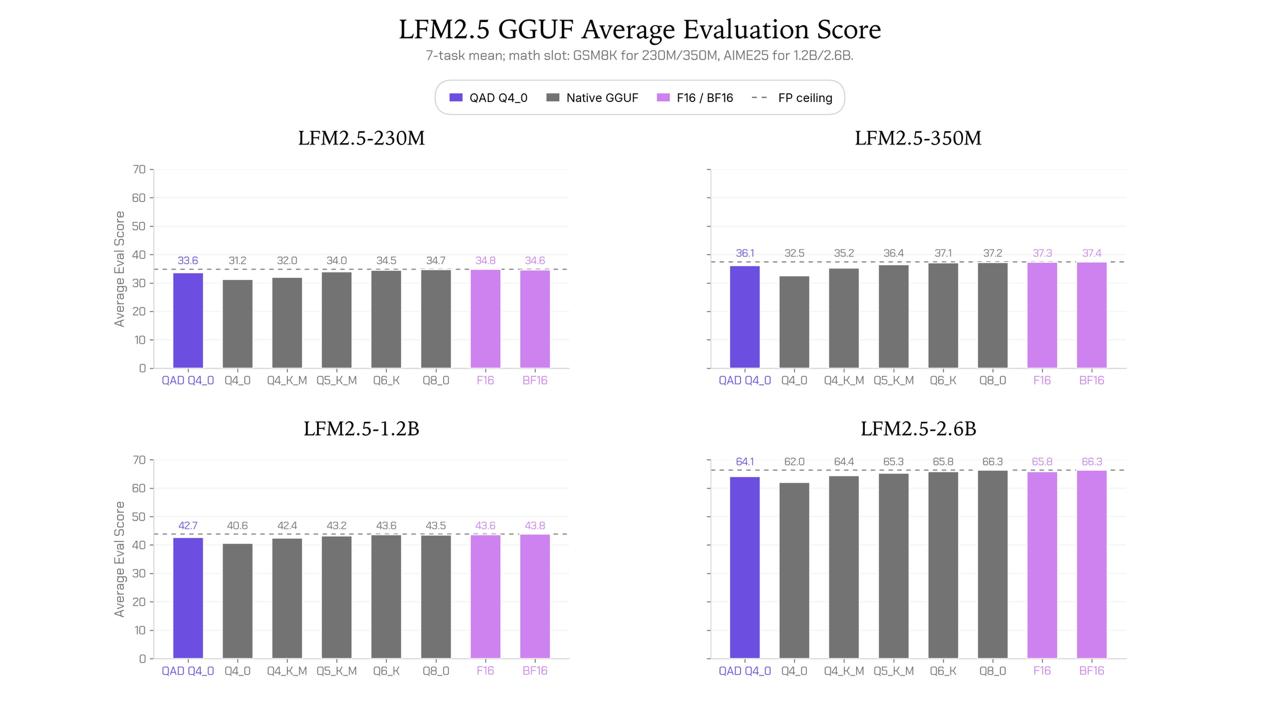
Liquid AI представила метод Quantization-Aware Distillation для 4-битных моделей

2 мес
Liquid AI представила метод Quantization-Aware Distillation для 4-битных моделей

Вопрос о производительности квантованных моделей и шине PCI-E

T@extremecodeAI-инженер
2 мес
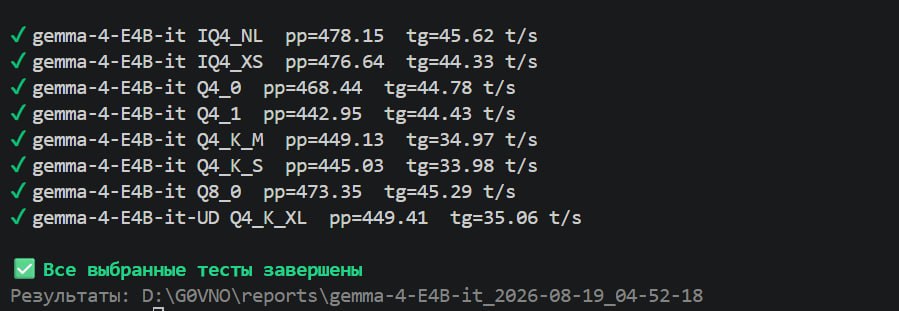
Эксперты из каментов, я с этими бенчмарками скоро с ума сойду. Почему так ёпта? PCI-E 4 / x4, на ЖПУ также только 4 линии распаяно. В теории должны упираться в шину, какого хрена iMatrix, и уж тем более 8-и битки быстрее, чем очереднярные Q4? Все в интернетах пишут типа, "АРРРЯЯ IQ медленные", какого хрена у меня они стабильно быстрее? Даже на нормальной жпу в pcie5 со всеми линиями (скрин в каменты к посту закину) Параметры бенча дефолтные [--fit-target 1024], контекст 512 на pp, и 128 на tg
Вопрос о производительности квантованных моделей и шине PCI-E

Метод квантования моделей через диагональное разложение Гессиана

К@quant_prune_distillAI-инженер
2 мес

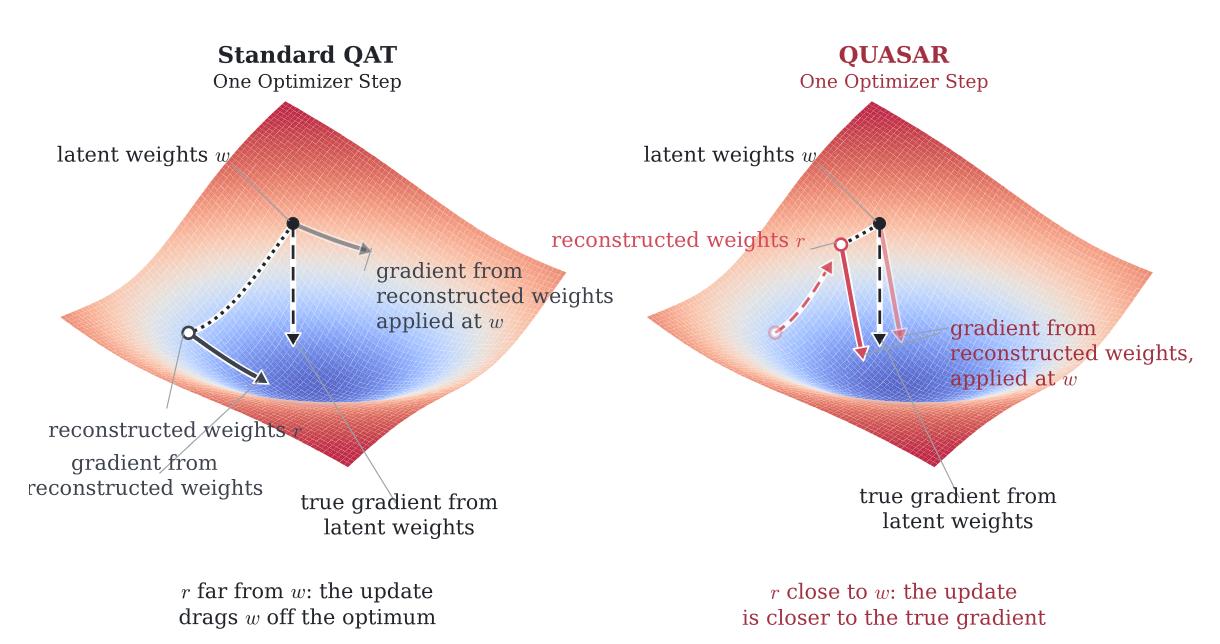
QUASAR: улучшение Quantization-Aware Training через учет кривизны

К@quant_prune_distillAI-инженер
2 мес
QUASAR: улучшение Quantization-Aware Training через учет кривизны

Влияние квантования на качество моделей до 9B

T@extremecodeAI-инженер
2 мес
Короче, модели до 9B параметров зажатые в любой Q4_* лучше в принципе обходить стороной, они пздц как сильно тупеют. Q8 на их фоне смотрится как гигамозг. Скажем спасибо, моей G0VN0 методике оценок моделей. P.S. Тесты еще до сих пор гоняю 🫠
Влияние квантования на качество моделей до 9B

Cactus Compute выпустил Needle 2 — модель на 14 МБ для вызова функций на edge-устройствах

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 2 мес назад

Стартап Cactus Compute представил Needle 2 — открытую модель с 45M параметров, заточенную под tool callingi (вызов функций) и извлечение структурированных данных в формате JSON. Чекпоинт весит всего 14 МБ и требует около 28 МБ RAM на всю сессию, что делает модель пригодной для IoT, носимых устройств и голосового управления даже на слабом или старом оборудовании.

По заявленным бенчмаркам Needle 2 идёт вровень с FunctionGemma 270M, LFM 2.5 230M и Apple FM, при этом будучи в 5–70 раз меньше их по размеру. Модель уже используется в реальном продукте: Pebble гоняет её локально в приложении для своего кольца без экрана.

14 МБразмер бинарника/чекпоинта модели
45Mчисло параметров модели
500 ток/сскорость декода на Raspberry Pi 5

Полный разбор →

Ещё ↓