нейросетиСбросить фильтр ×

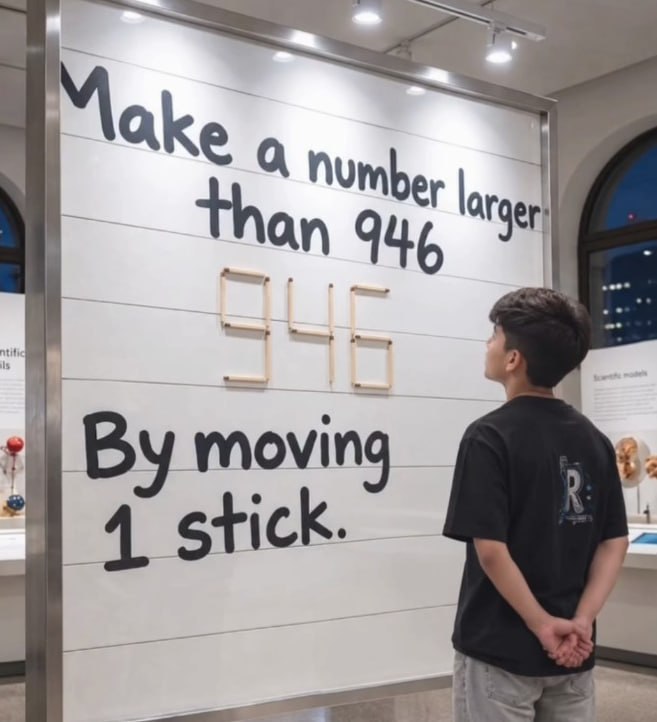
Эксперимент с логической задачей и SOL 6

М@cgeventAI-инженер
2 нед
Эксперимент с логической задачей и SOL 6

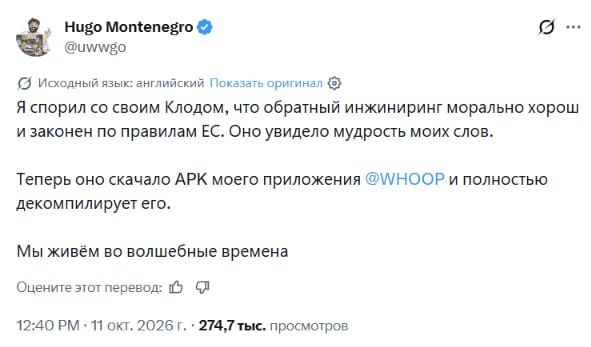
Конфликт пользователя и нейросети в комментариях UX Live

U@uxliveмедиа / агрегатор
2 нед
Кстати если вы вдруг пропустили самый смешной срач в каментах UX Live за прошедший месяц — можете вернуться сюда https://t.me/uxlive/18503 в каменты на 3 часа 18 минут и почитать как нейросеть моггает (староинтернетовское: овнит) человека, который пришел защищать нейросети от могганья и сам был могнут всухую Gemini без единого промпта кроме "моггни его + скрин". Стас ты лакомишься?

Выход модели Kroma на базе Krea-2

Н@GreenNeuralRobotsAI-инженер
2 нед
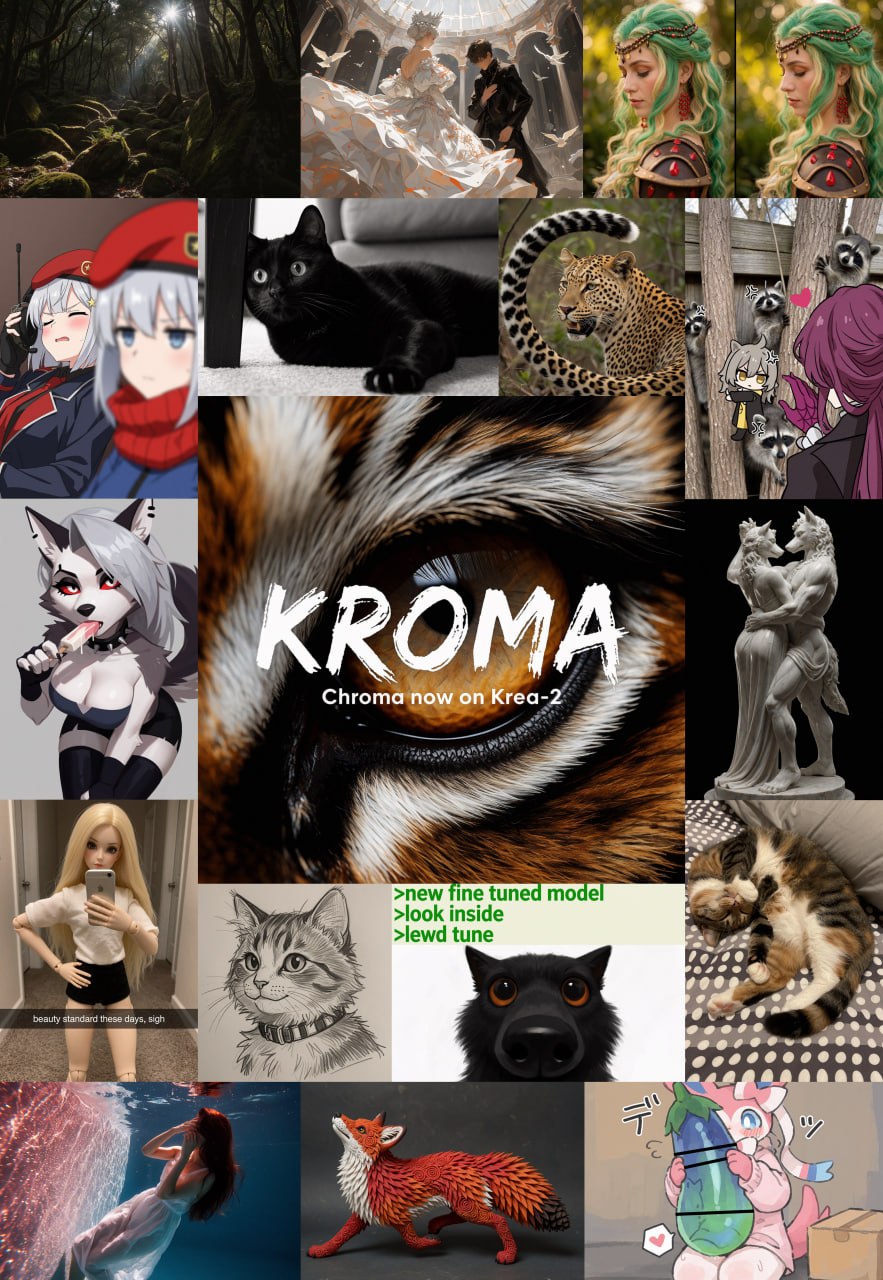
Kroma Файннтюн Krea-2 В отличие от предыдущего (Chroma), здесь не пришлось раздистиллировать модель — Krea дали настоящие базовые веса, так что Kroma выходит с OPD (RL) прямо поверх базы и дает хороший результат из коробки. • Генерация на базе Krea-2 без схлопывания модели • Лучшие результаты после RL-дообучения поверх базы • Нацелен на качество данных — ~90% качества идет из датасета • Тренировка ~10K часов RTX 6000 Pro (3+ месяца на 4-GPU машине), включая неудачные эксперименты • Донат от ComfyOrg на 2 видеокарты int8 Civitai #t2i #krea2 MAX
Выход модели Kroma на базе Krea-2

Короткометражный хоррор-фильм «ТИШИНА», созданный с помощью ИИ

М@cgeventAI-инженер
2 нед

Нода ComfyUI для точечного редактирования изображений Klein

Н@GreenNeuralRobotsAI-инженер
2 нед

Vivix W1: новый видеогенератор из Китая с фокусом на дешевизну

Н@GreenNeuralRobotsAI-инженер
2 нед

Odyssey выпустила Odyssey-3 — модель для генерации интерактивных миров в реальном времени

Калифорнийский стартап Odyssey, основанный выходцами из индустрии беспилотных автомобилей, представил Odyssey-3 — модель, которая по текстовому запросу или картинке создаёт интерактивное 3D-окружение и просчитывает движение и взаимодействие объектов в реальном времени. Внутри сгенерированного мира можно перемещаться от первого или третьего лица, управлять камерой и на ходу добавлять события, на которые сцена реагирует.

Odyssey позиционирует продукт не только как развлечение, но и как симулятор для обучения роботов, беспилотных автомобилей и других физических систем — поверх модели обучают отдельные декодеры действий и политики управления. Попробовать модель можно бесплатно на сайте компании, тогда как ранее похожую функциональность (модель Geniei от Google) приходилось оплачивать — по словам источников, порядка $240.
66,1балл Pro-версии на Physics-IQ Verified
1280×720разрешение Odyssey-3 Pro
$240стоимость похожей функции у Google ранее

Полный разбор →

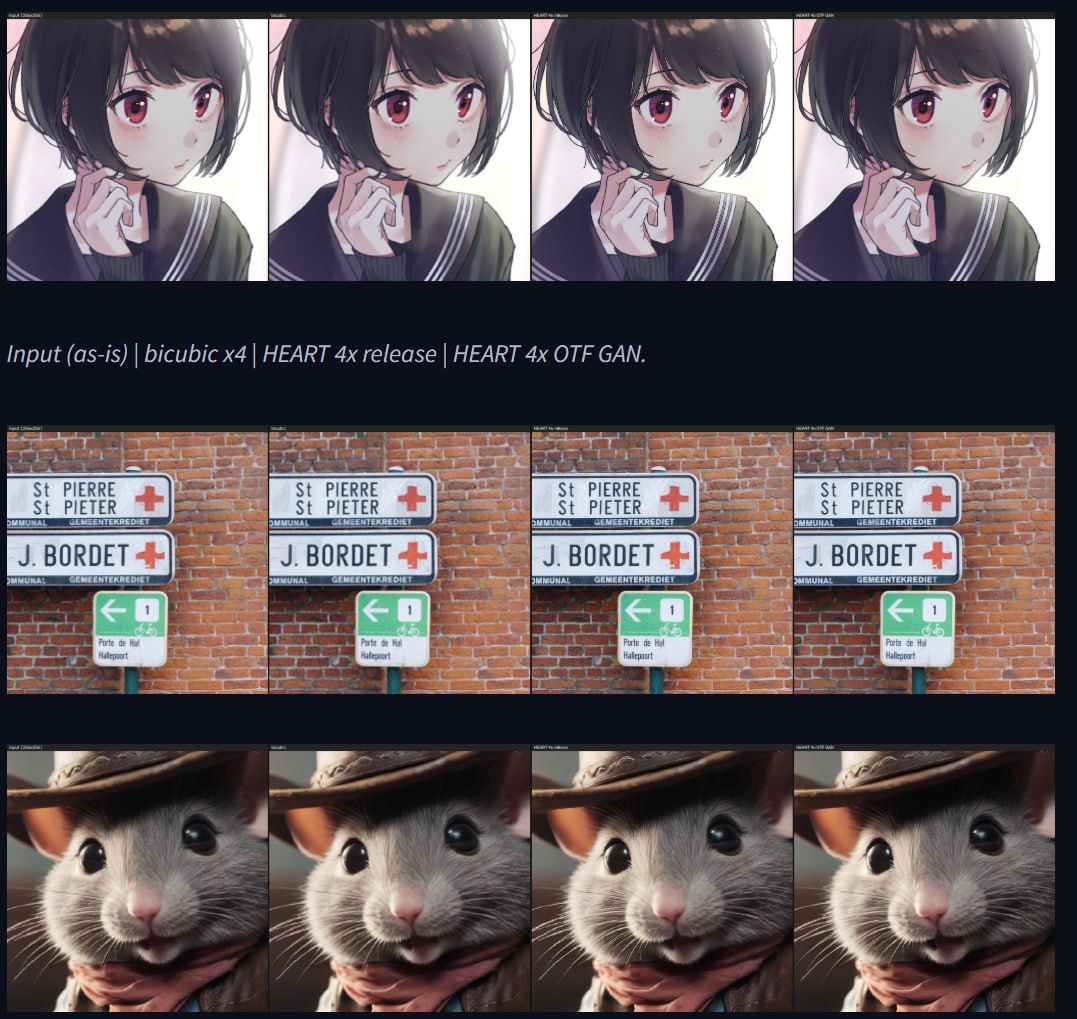
HEART: нейросеть для апскейла изображений

Н@GreenNeuralRobotsAI-инженер
2 нед
HEART супер-резолюшн от Philip Hofmann (часть набора BODY) Нейросеть для апскейла изображений. Простая в обучении и быстрая, спроектирована для реального использования, а не погони за бенчмарками. Натренирована на обычной RTX 3060 12 ГБ. • Апскейл 2x и 4x • OTF-модели восстанавливают реальные фото (шум, сжатие), а не только чистые даунскейлы • Экспорт в динамический ONNX с первого раза, готово для TensorRT • Работает в chaiNNer • ~16.7M параметров, один файл Проверил на свидетеле - ... ну да пикселей больше. а где супер-резолюшн? huggingface.co/Phips/HEART github.com/Phhofm/heart-train Демо #upscale MAX
HEART: нейросеть для апскейла изображений

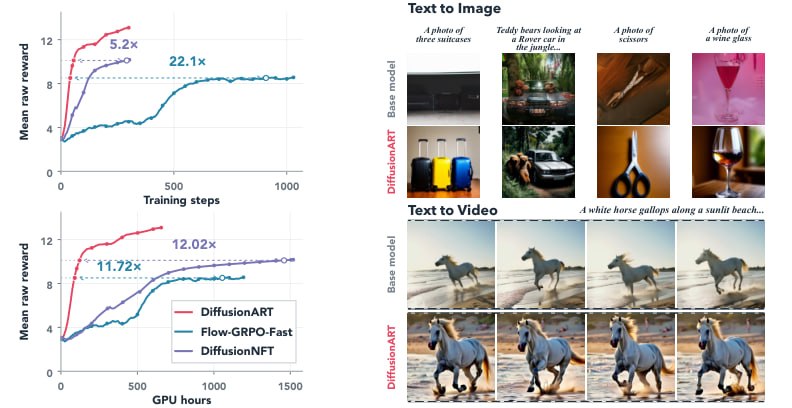
DiffusionART: новый алгоритм дообучения диффузионных моделей от Kling AI

Н@GreenNeuralRobotsAI-инженер
2 нед
DiffusionART Алгоритм дообучения диффузионных моделей от Kling AI. Обучает модели генерации видео и изображений сильно дешевле - в 12 раз меньше GPU-часов при более высоком вознаграждении. • RL-дообучение видео- и image-моделей: качество, следование промпту, feedback • Стабильное обучение без крахов, без настройки EMA-расписания • Работает на #HunyuanVideo-13B, #Wan21-I2V-14B, #SD35-M Соль — порядок операций: сначала агрегировать вознаграждения и endpoints, потом регрессия, переиспользуя замороженную цель. Убирает скрытую силу согласованности из классического NFT, из-за которой обучение нестабильно Гитхаб HF #finetuning MAX
DiffusionART: новый алгоритм дообучения диффузионных моделей от Kling AI

Обзор новых инструментов для LTX 2.5: LoRA, апскейл и генерация звука

Н@GreenNeuralRobotsAI-инженер
2 нед

Обзор новых инструментов для LTX 2.5: LoRA, апскейл и генерация звука

Н@GreenNeuralRobotsAI-инженер
2 нед

Влияние нейросетей на модель подписок

М@olya_tashitмедиа / агрегатор
2 нед
Есть много вещей, которые стали хуже из-за нейронок. Но если куда-нибудь денется мерзкая практика подписок - особенно за физические вещи - это будет просто великолепно!
Влияние нейросетей на модель подписок

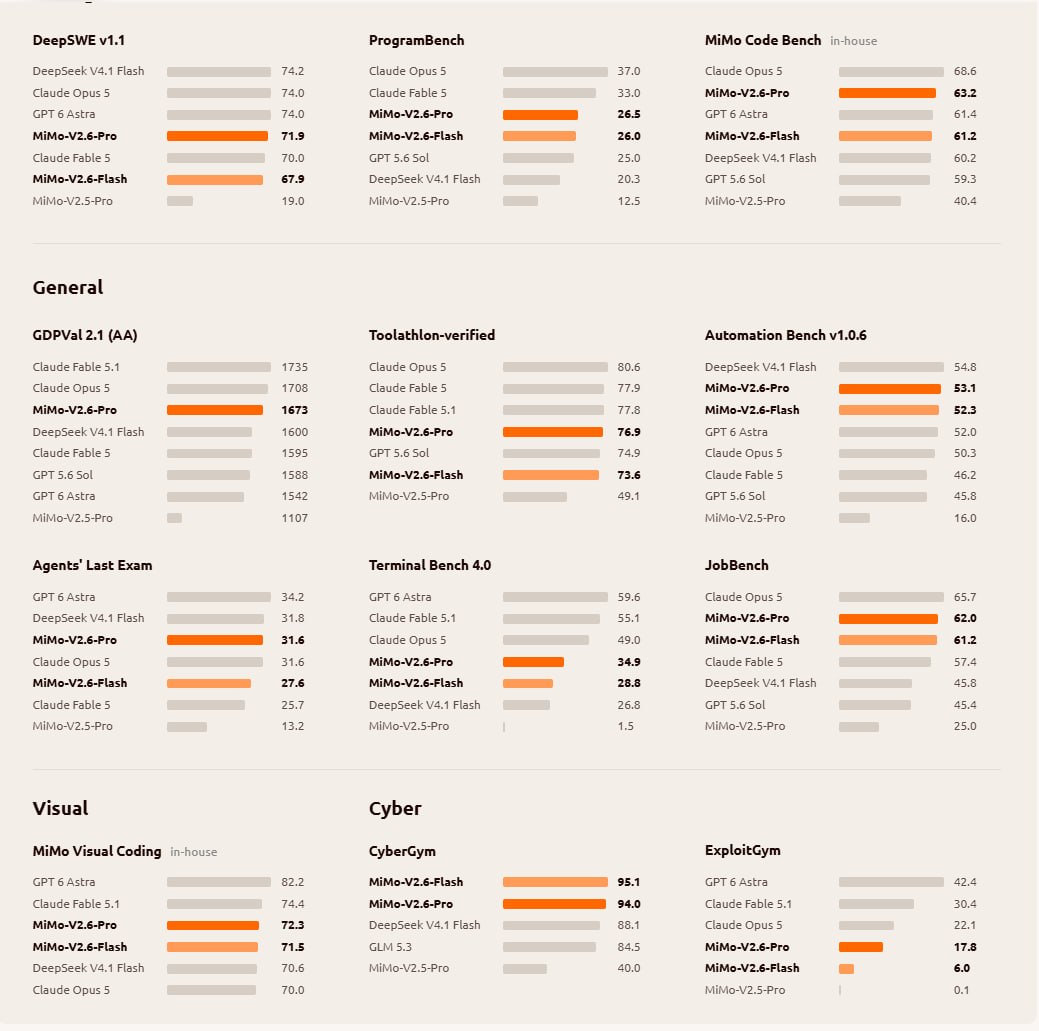
Xiaomi представила семейство моделей MiMo-V2.6 на Hugging Face

Н@GreenNeuralRobotsAI-инженер
2 нед
Xiaomi открыли на Hugging Face семейство MiMo-V2.6 — omni-modal модели, которые масштабируют RL-вычисления в сторону самоулучшения • MiMo-V2.6-Pro-RL — 1T, текст • MiMo-V2.6-Flash-RL — 311B, текст • MiMo-V2.6-Distill-Qwen-9B — 9B, мультимодальная (картинки+текст) • MiMo-V2.6-Pro-MOPD и Flash-MOPD — варианты 1T/311B Фокус на RL-самоулучшение: модели дообучаются через открытые RL-среды. Есть дистилляция до компактных 9B мультимодальной версии. Весь стек обучения открыт HF Попробовать API #flagship #omnimodal #multimodal MAX
Xiaomi представила семейство моделей MiMo-V2.6 на Hugging Face

На GitHub вышел Animator — инструмент для генерации объясняющих видео по текстовому промпту

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 2 нед назад

В открытом доступе на GitHub появился инструмент Animatori, который по одной текстовой команде создаёт полноценный объясняющий видеоролик: сам пишет сценарий, рисует анимацию, записывает озвучку, синхронизирует её с кадрами и собирает итоговое видео.

Под капотом работают нейросети Geminii, которые генерируют по 4-5 сцен анимации примерно за минуту — то есть ролик уровня популярных YouTube-объяснялок можно получить почти мгновенно, просто задав тему.

4-5 сцен в минутускорость генерации анимации

Полный разбор →

Ещё ↓