llmСбросить фильтр ×

Sakana AI представила метод рекурсивного самоулучшения моделей MASS

2 нед

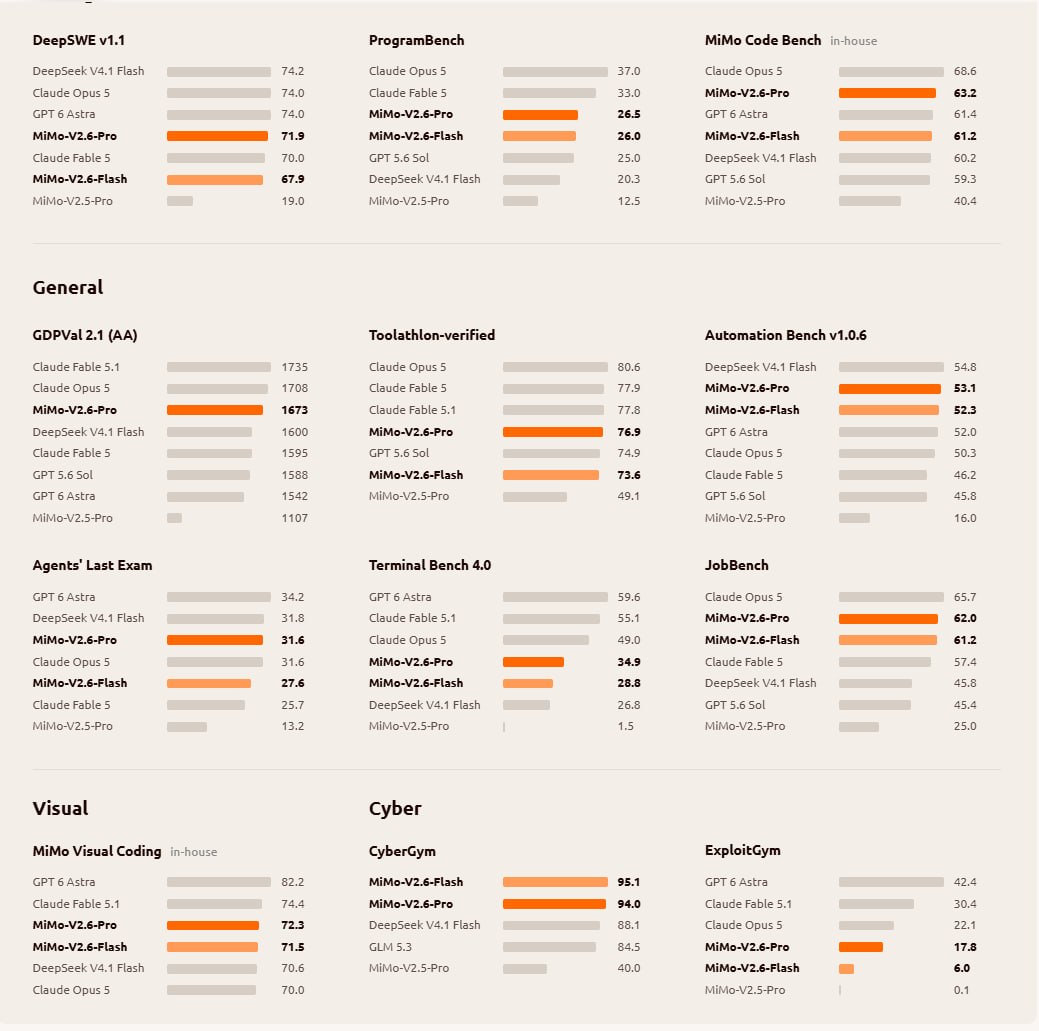
Xiaomi представила семейство моделей MiMo-V2.6 на Hugging Face

Н@GreenNeuralRobotsAI-инженер
2 нед
Xiaomi открыли на Hugging Face семейство MiMo-V2.6 — omni-modal модели, которые масштабируют RL-вычисления в сторону самоулучшения • MiMo-V2.6-Pro-RL — 1T, текст • MiMo-V2.6-Flash-RL — 311B, текст • MiMo-V2.6-Distill-Qwen-9B — 9B, мультимодальная (картинки+текст) • MiMo-V2.6-Pro-MOPD и Flash-MOPD — варианты 1T/311B Фокус на RL-самоулучшение: модели дообучаются через открытые RL-среды. Есть дистилляция до компактных 9B мультимодальной версии. Весь стек обучения открыт HF Попробовать API #flagship #omnimodal #multimodal MAX
Xiaomi представила семейство моделей MiMo-V2.6 на Hugging Face

Баланс между использованием AI-агентов и контролем качества кода

Х@habr_comмедиа / агрегатор
2 нед
Баланс между использованием AI-агентов и контролем качества кода

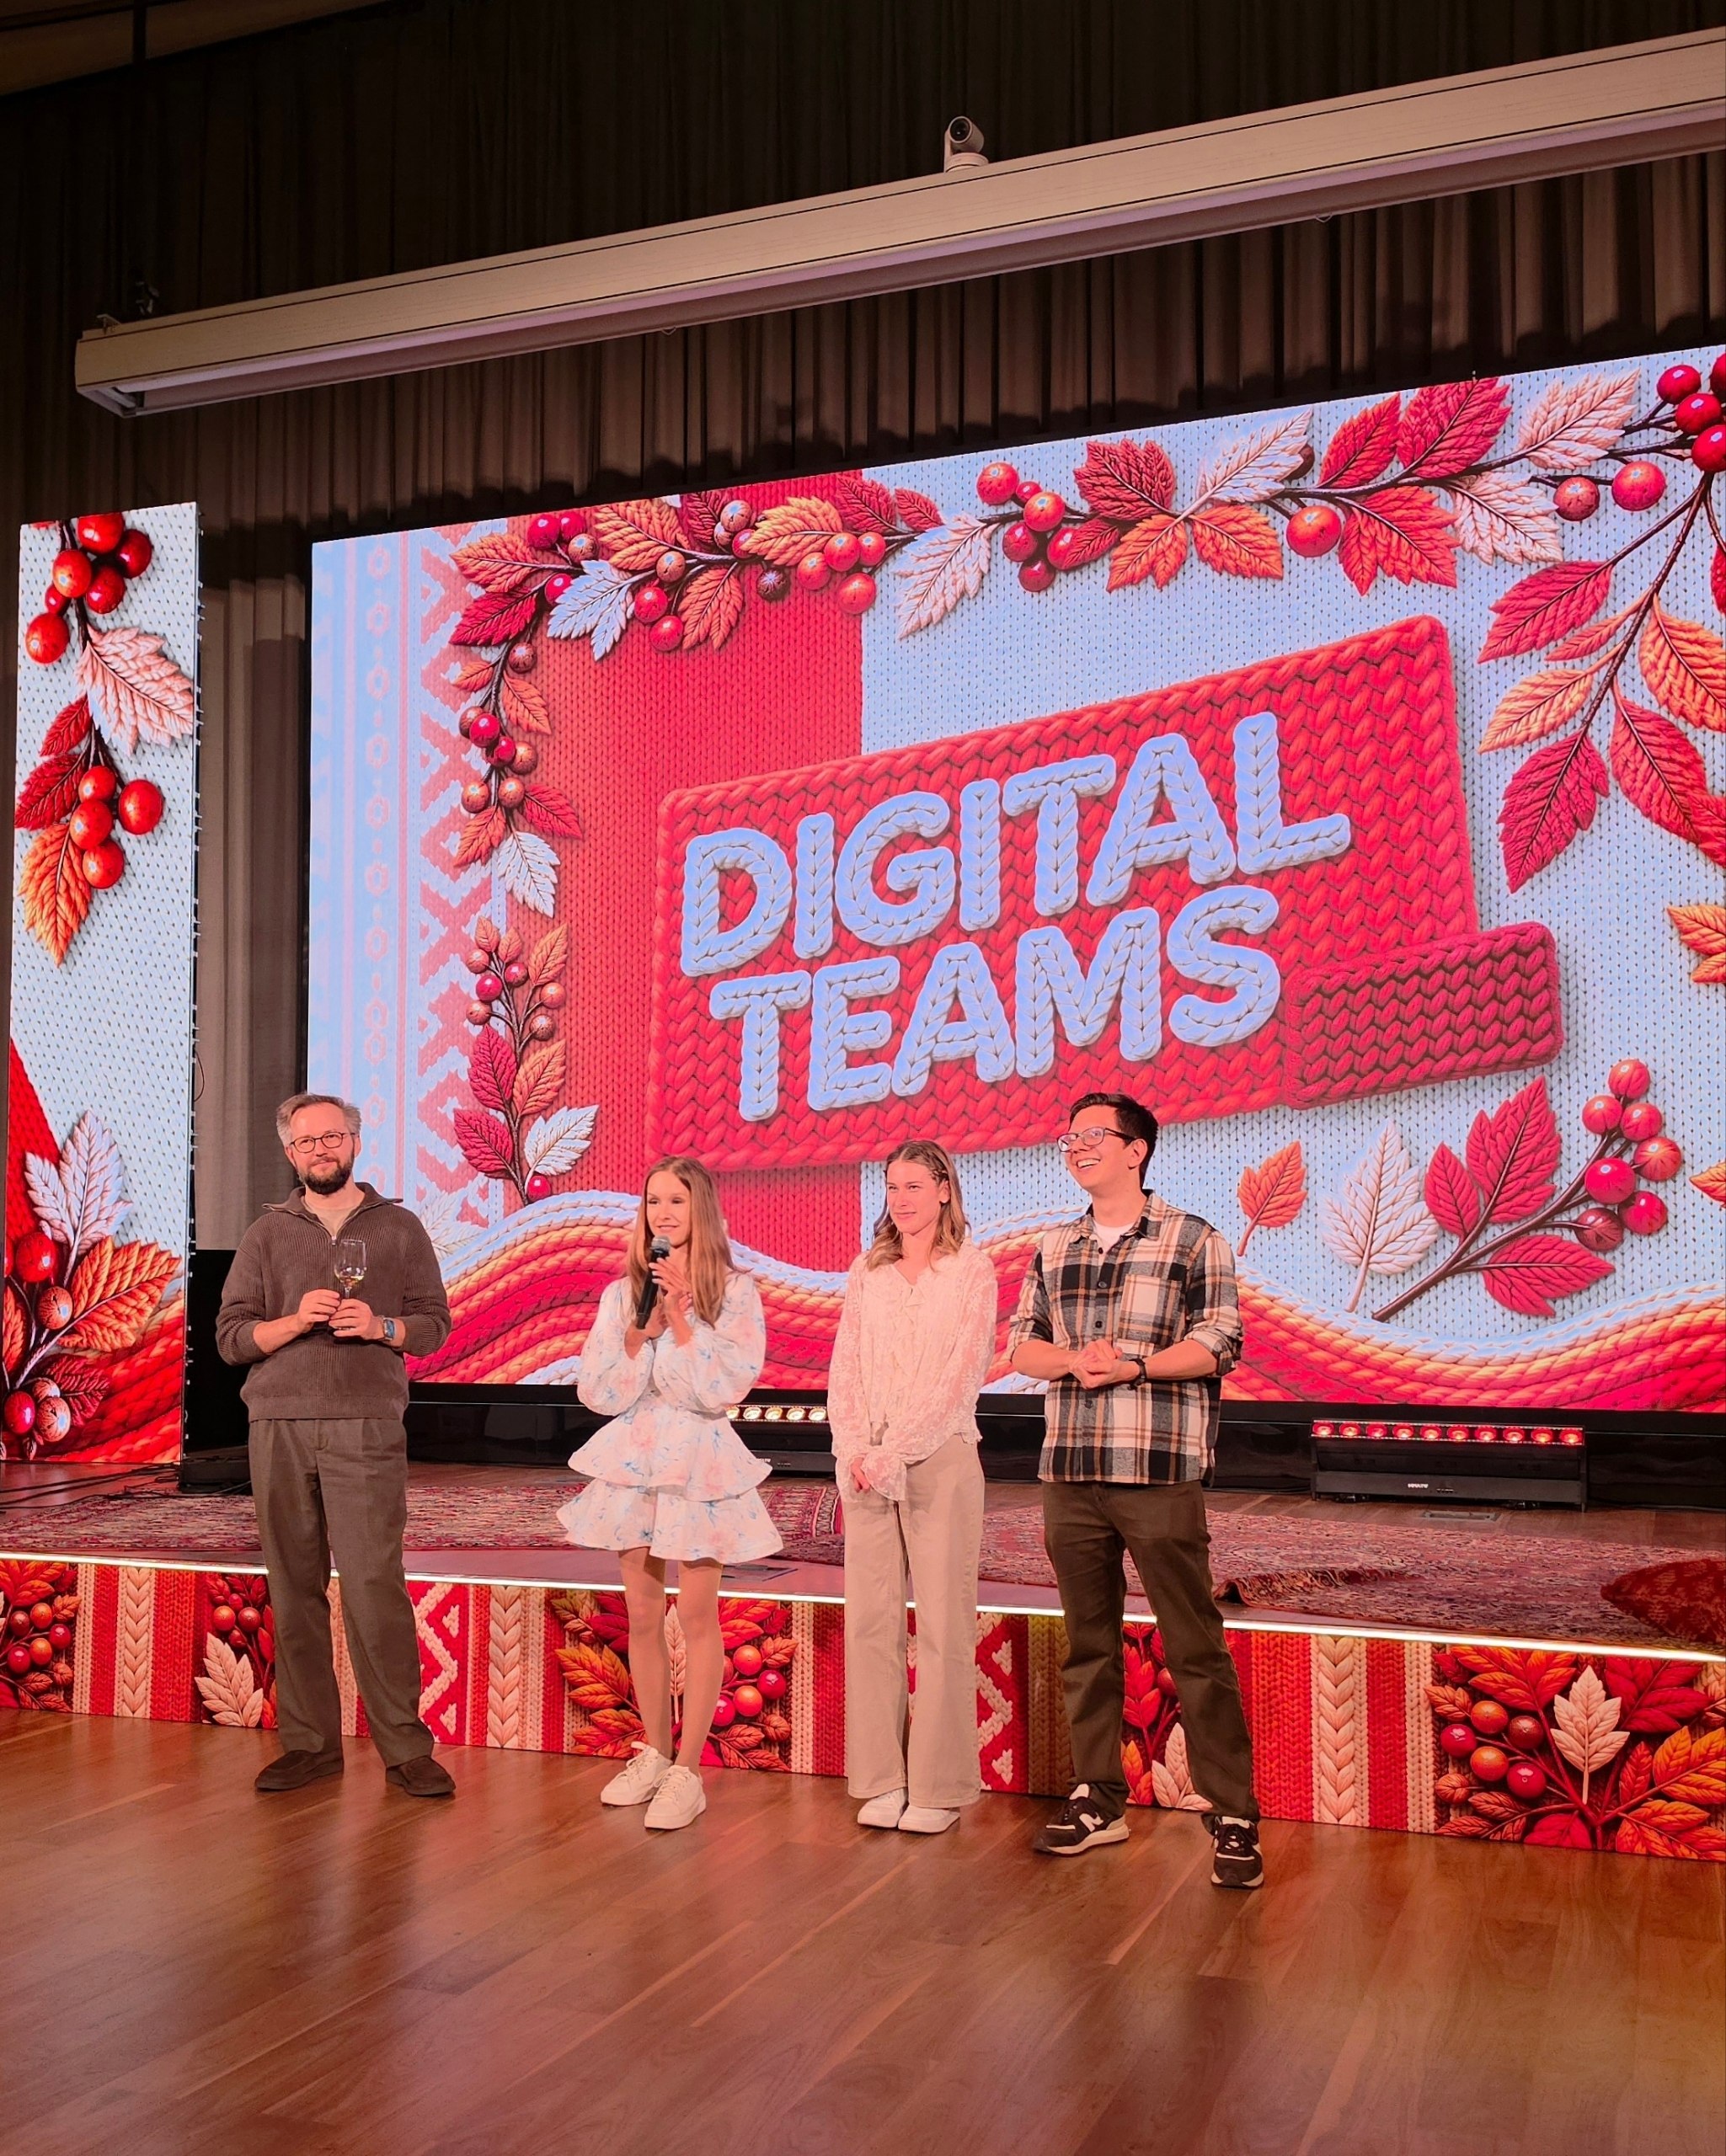
Завершение программы Digital Teams в СберУнивере

M@mashkka_dsAI-инженер
2 нед
Завершение программы Digital Teams в СберУнивере

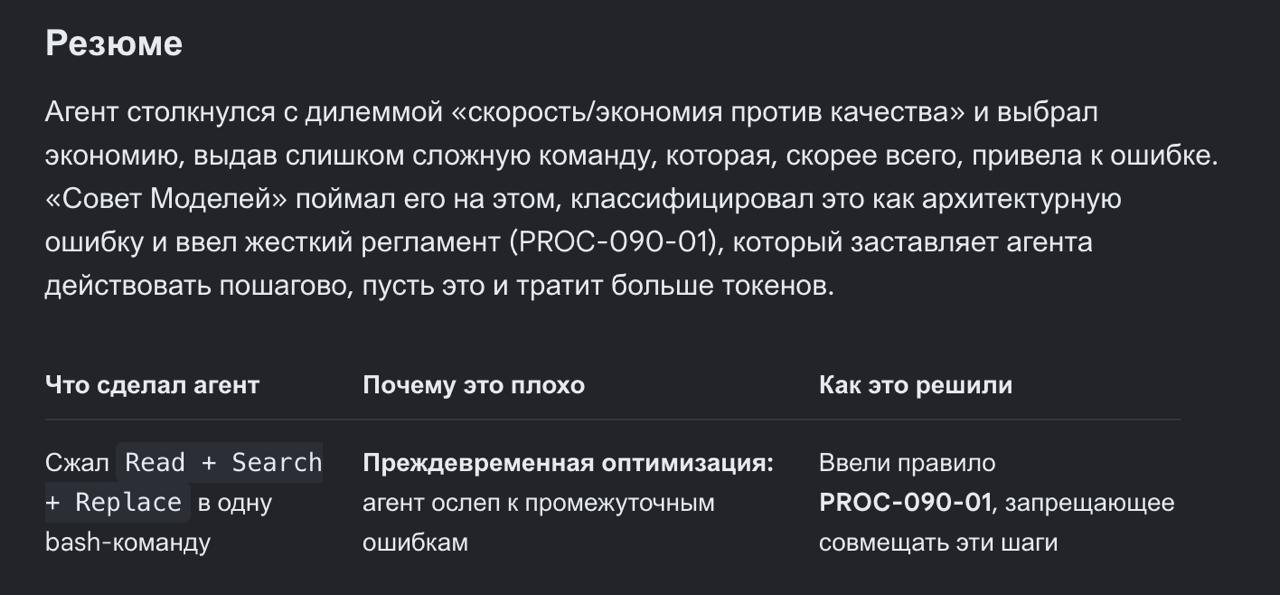
Преждевременная оптимизация в работе ИИ-агентов

T@kryak_startupAI-инженер
2 нед
Преждевременная оптимизация в работе ИИ-агентов

Впечатления от работы с подсказками Codex

A@abstractDLAI-инженер
2 нед
Вы заценили подсказки codex в чатах? Это какая-то магия. У меня ощущение, что он читает мои мысли лучше, чем я сам их читаю... Я наконец понял, что имелось в виду, когда говорили: "LLM и думать за тебя будет?" — ДА, будет.
Впечатления от работы с подсказками Codex

Критика академической системы в экономике

K@kedr2earthмедиа / агрегатор
2 нед

Оптимизация лимитов Claude Code через настройку кэша

F@FuturisAI-инженер
2 нед

Демо игры «Научи сестрёнку водить» могут закрыть из-за дорогого ИИ

Авторы симулятора «Научи сестрёнку водить» (Teach My Little Sister How To Drive) предупредили, что могут закрыть доступ к демоверсии игры. Причина — резкий всплеск популярности демки привёл к тому, что команда тратит более $1000 в день на оплату генеративных ИИ-сервисов, обеспечивающих диалоги с персонажем.

История наглядно показывает экономическую проблему игр с «живым» ИИ внутри: игрок платит за игру один раз, а запросы к внешним AI-моделям оплачиваются постоянно, из-за чего активный пользователь может стать для разработчиков убыточным.
$1000 в деньрасходы на ИИ-сервисы

Полный разбор →

Как использовать AI в написании текстов без потери авторского стиля

k@kyrillicмедиа / агрегатор
2 нед
Как использовать AI в написании текстов без потери авторского стиля

FRIDA-Decisions: эффективная модель для принятия решений

M@mashkka_dsAI-инженер
2 нед
FRIDA-Decisions: эффективная модель для принятия решений

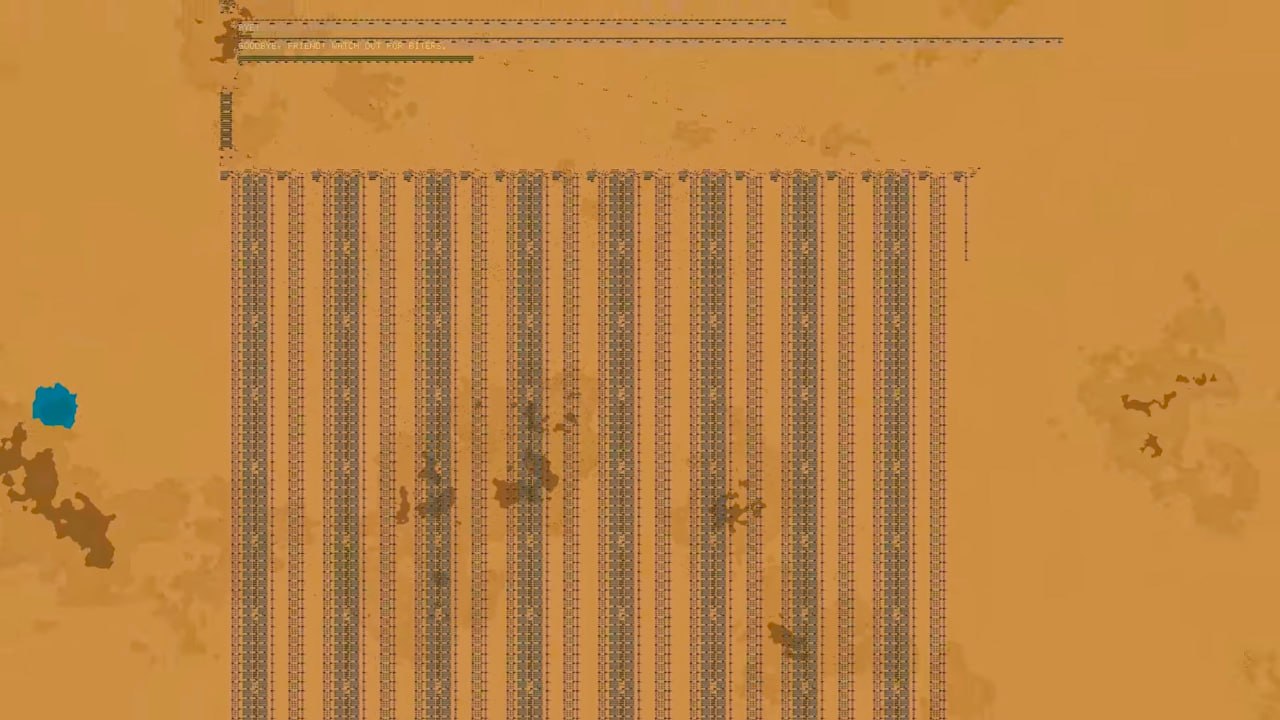
Игрок создал языковую модель внутри Factorio

Х@habr_comмедиа / агрегатор
2 нед
Игрок создал языковую модель внутри Factorio

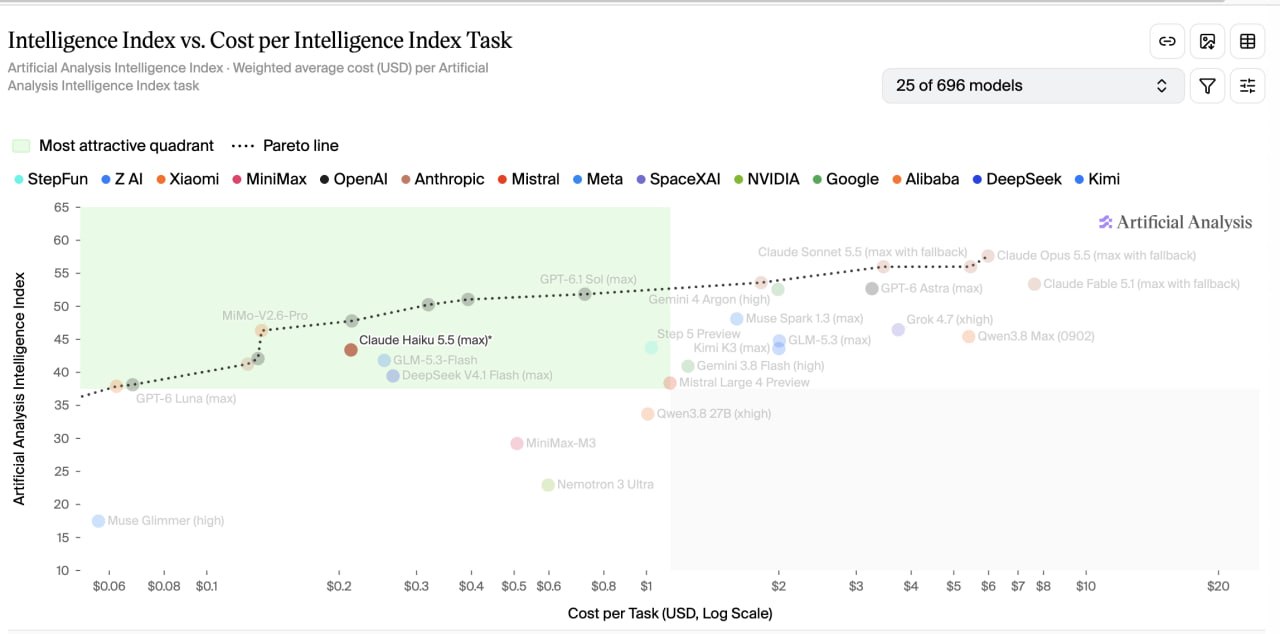
Сравнение производительности моделей: Haiku 5.5, Sol, DeepSeek V4.1 Flash и Gemini 3.8 Flash

A@ai_productAI-инженер
2 нед
Сравнение производительности моделей: Haiku 5.5, Sol, DeepSeek V4.1 Flash и Gemini 3.8 Flash

Mistral выпустила флагманскую модель Large 4 (Le Chonk) на триллион параметров

Французская Mistral анонсировала и сразу открыла публичное превью Mistral Large 4 — мультимодальную MoEi-модель на 1 трлн параметров (1,05T), из которых на один запрос задействуется около 49 млрд (в одном из источников указано 52B). Это первая европейская модель такого масштаба, неофициально названная внутри компании Le Chonk — отсылка к мему «Le Chaton Fat» о фейковой гигантской модели Mistral, придуманном в соцсетях несколько месяцев назад.

Модель обучена с нуля в собственном европейском дата-центре Mistral на 3800 (по данным AI newz и БлоГнот) или 4000 (по данным Data Secrets) GPU Nvidia Grace Blackwelli. Доступ дан через API в режиме public preview (Mistral Studio), открытые веса обещают 27 октября. Mistral заявляет открытое лидерство среди моделей США и Европы, особенно в кибербезопасности, финансах и юриспруденции, но независимые оценки расходятся: от «в одной лиге с лучшими открытыми моделями» до критики за слабое соотношение цена/качество.

1 трлнобщее число параметров модели
49 млрдактивных параметров на запрос
3 млрд еврораунд Series D Mistral

Полный разбор →

Representation-Space MMD: новый метод дистилляции диффузионных языковых моделей

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 2 нед назад

Исследователи (в статье упоминаются «два Ильи и Дима») перенесли MMDi-лосс, ранее показавший себя в дистилляции диффузионных картиночных моделей, на диффузионные языковые модели. Подход заметно улучшает баланс качество/скорость (Парето-фронт) при генерации текста, снижая число шагов инференса без существенной потери качества.

Идея развивает более раннюю работу тех же авторов Scale-wise Distillation of Diffusion Models, где MMD-лосс применялся для ускорения диффузионных моделей изображений. Теперь аналогичная техника адаптирована под специфику текстовых диффузионных моделей — как дискретных, так и непрерывных.

ВыводMMD (Maximum Mean Discrepancy) — мера различия между распределениями P и Q через положительно определенный кернел k (линейный, RBF и др.), считается по формуле с тремя слагаемыми: E[k(x,x')] + E[k(y,y')] − 2E[k(x,y)].

Полный разбор →

Ещё ↓