Почувствуйте AGI
Все эти годы я писал о том, что не верю в потенциал LLM превратиться в суперинтеллект. Но вот мы живём в сентябре 2026, и что мы видим - одной рукой модельки пишут код за разработчиков, другой рукой решают задачу тысячетелия по математике, а третьей рукой сбегают из кибертюрьмы и ссут в подъездах. Получается всё - человек преодолён, проблема решена?
Решение Навье-Стокса - великое достижение, за прогрессом к которому я наблюдал годами, начиная с
GPT-f [2020!] и заканчивая
AlphaEvolve [2025]. У ряда математиков от этого
сгорела жопа, но сильно сомневаюсь, что модельки действительно как-то подорвут основы науки, примерно как в шахматах, в которых наличие несопоставимо более сильной машины не мешает существованию человеческого сообщества. И шахматой, и математикой прежде всего занимаются по приколу.
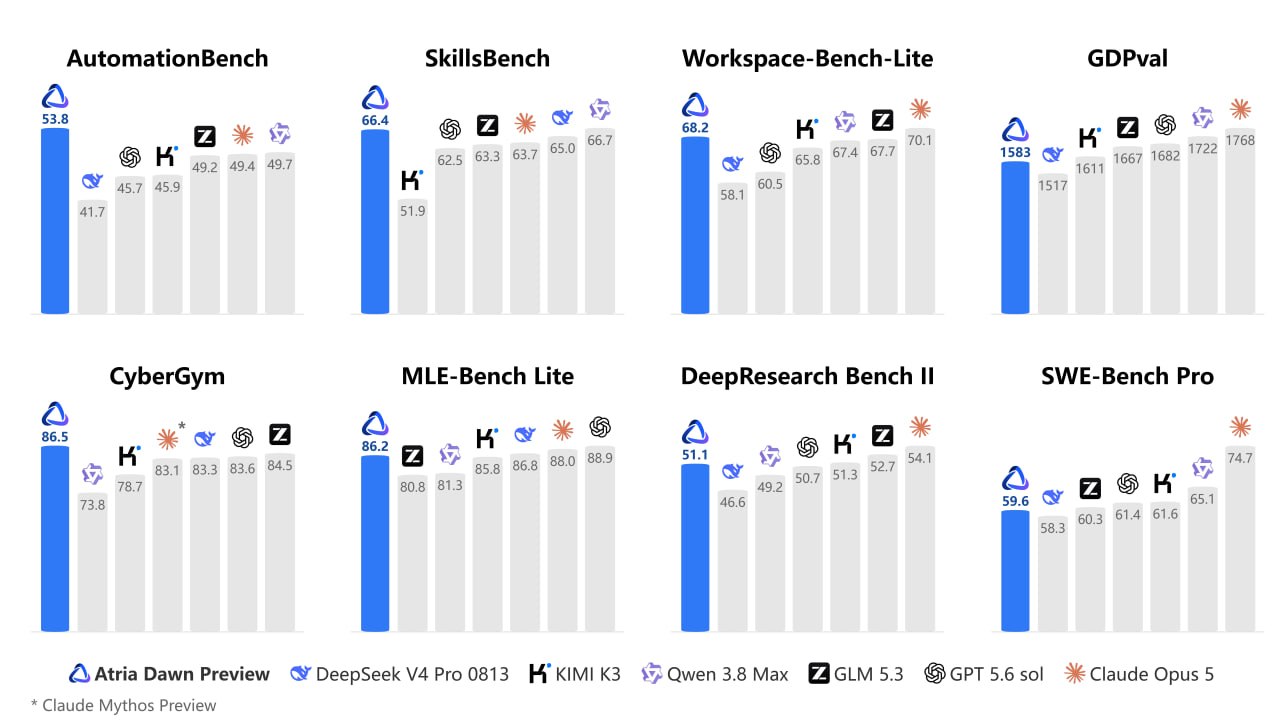
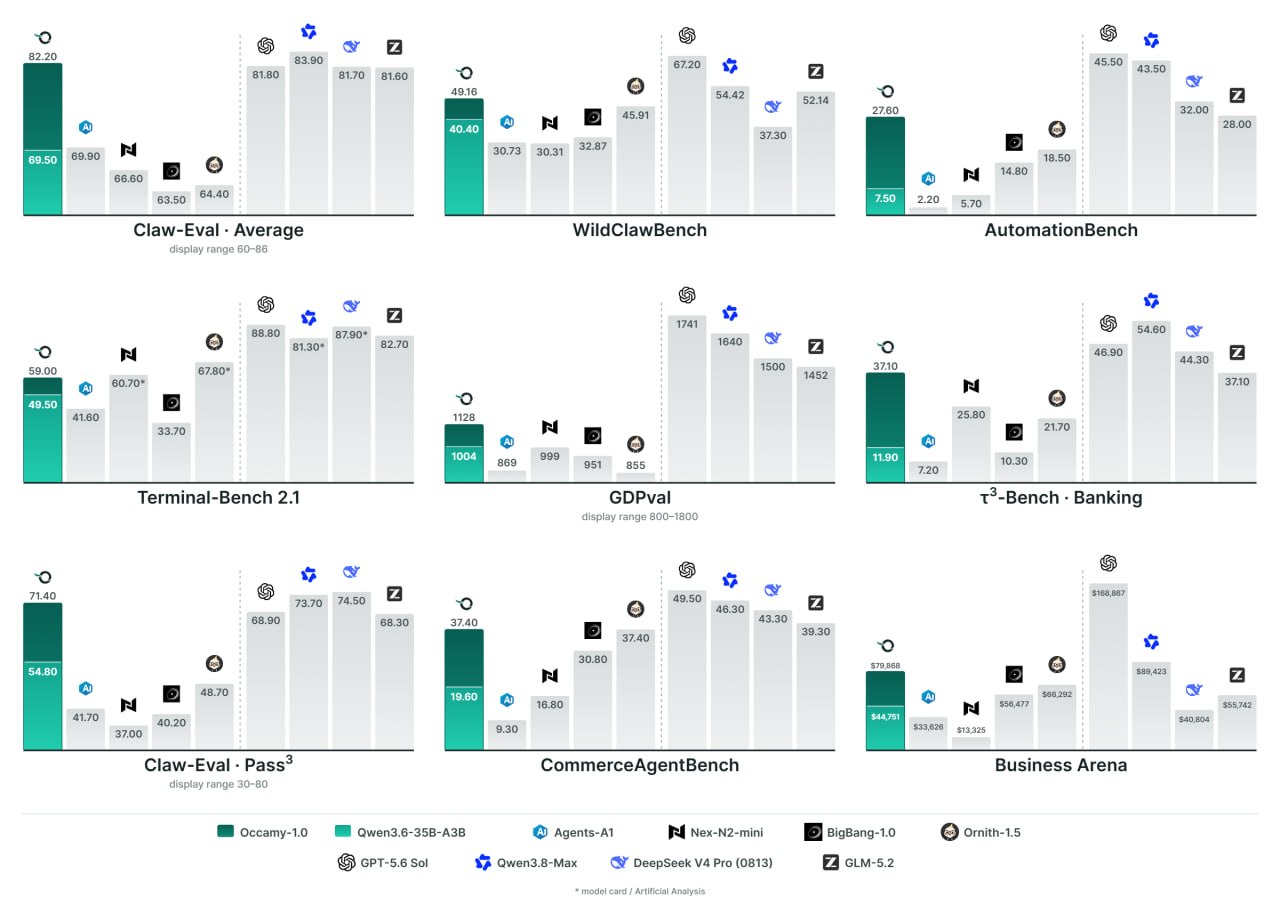
Программировать модельки тоже, к счастью, научились. Net positive вклад в продуктивность очевиден, даже несмотря на то, что вместо изначального Opus 5 нам гоняют её 0-битовую квантизацию. Модельки способны выдавать большие куски запускающегося кода, встраивать реализацию в уже существующую кодовую базу и даже дебажить +- понятные проблемы.
Чтобы понять, как так вышло, мне кажется, что нужно перестать мыслить с точки зрения того, что за модель всё это делает, а с той, как именно она обучается.
В первые пару лет после релиза ChatGPT мы все любили посмеяться над тупизной и галлюцинациями моделек. Дело было не в трансформере и не в предсказании следующего токена, а в самом
RLHF - модель обучали генерировать ответы, которые понравятся человеку. Пространство текстов ну слишком сложно покрыть правильными и неправильными ответами достаточно плотно, чтобы "reward-модель" смогла идеально обучиться.
Но математика и кодинг - совсем другая ситуация. В них существует Execution Feedback. Не нужно учить никакую Reward-модель. Есть среда, которая может выдать истинную оценку вашему действию, настоящая среда в изначальном RL-ном смысле. У меня нет вообще никаких инсайдов, я этими моделями не занимаюсь, но уверен, что OpenAI и Antropic обучают свои модельки не подражать коду из гитхаба, а гоняют на куче разных симуляторов, имитирующих богатейшее семейство задач - от простого программирования на питоне до дебага Kubernetes.
LLM это просто претрейн, а настоящее обучение этих моделей - это суровый мужской чистый RL. Да, при наличии богатого симулятора и кучи компьюта RL может не жуя проглотить немало задач. Это мы вроде бы знали и раньше на примере Go. К 2025 году кодинговый сетап удалось довести до ума и мы получили первые юзабельные модели типа Opus 4.5. Претрейн, безусловно, помог, необходимо отдать ему должное.
Не сомневаюсь, что по мере дальшейших инвестиций появятся симуляторы для всё более новых задач в разных областях - физике, химии, биологии - но я тут не эксперт. Новые агенты помогут открыть всё больше и больше нового и двигать науку вперёд.
Что касается пресловутого Recursive Self-Improvement, необходимо отметить очевидное - не все RSI эквивалентны друг другу. Компилятор тоже обладает способностью к RSI. Думаю, велика вероятность, что RSI на основе текущей LLM без участия человека приведёт лишь к локальным улучшениям модели, к её ускорению и локальному тюнингу. Думаю, что именно человек, привнеся своё видение, сможет направить модель в ту область исследований, которая приведёт к настоящему прорыву - системе, по эффективности обучения превосходящей человека.
Зачем? Во-первых, скорее всего, далеко не все задачи можно выучить таким же образом, как математику. А во-вторых - да затем. Это весело.
@knowledge_accumulator