llmСбросить фильтр ×

Speko: единый API и роутер для голосовых AI-моделей

A@ai_productAI-инженер
2 мес
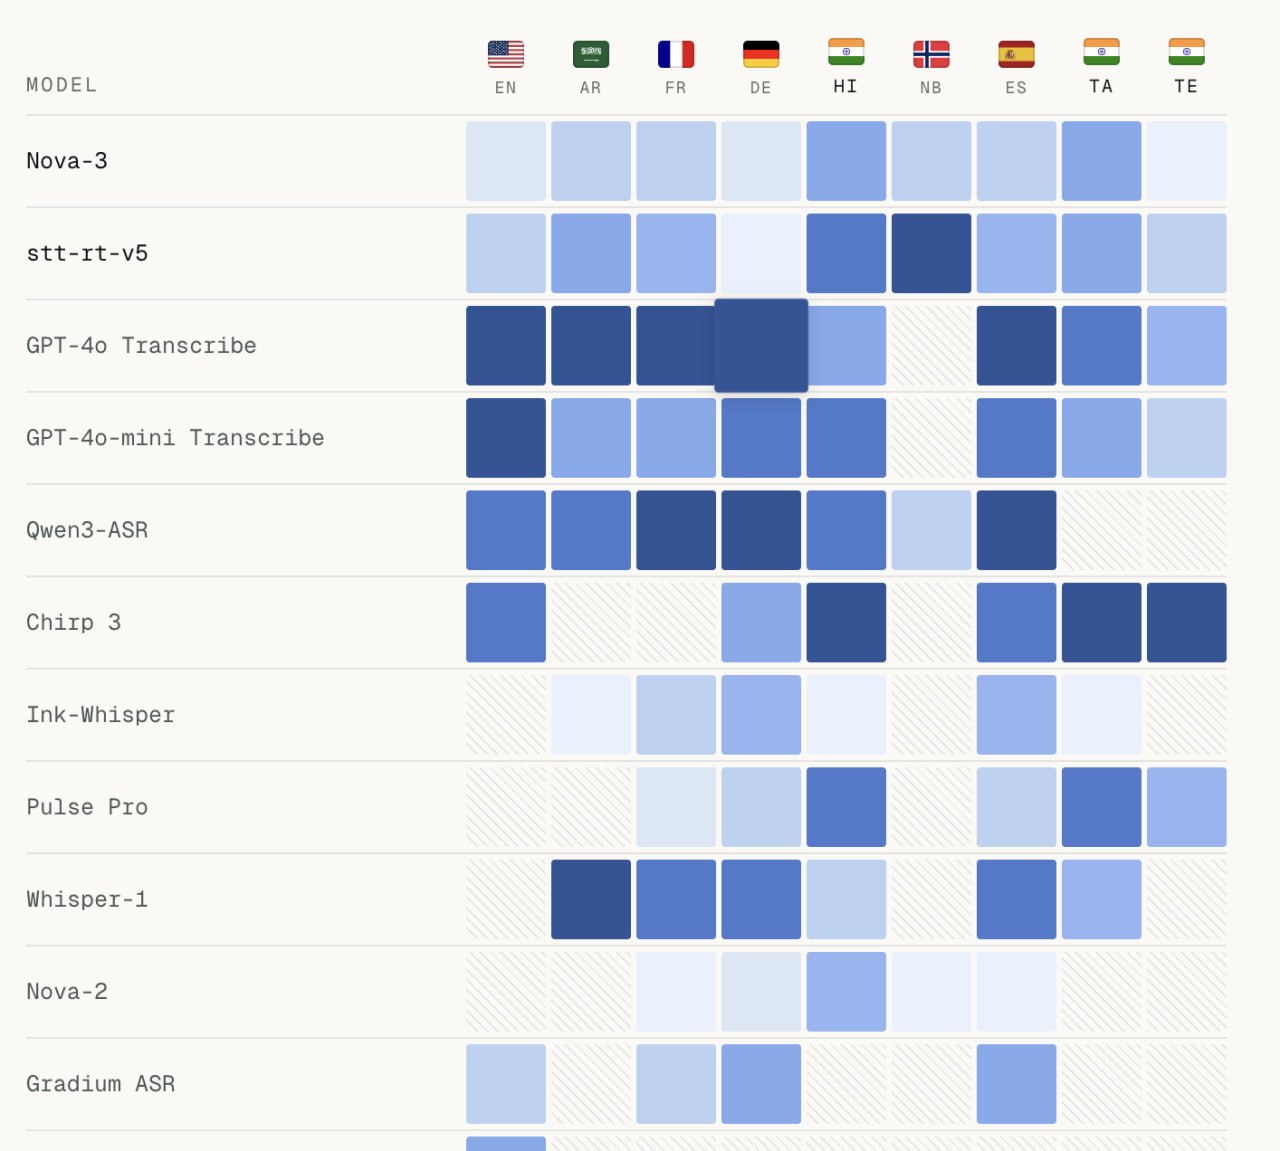
Speko: единый API и роутер для голосовых AI-моделей

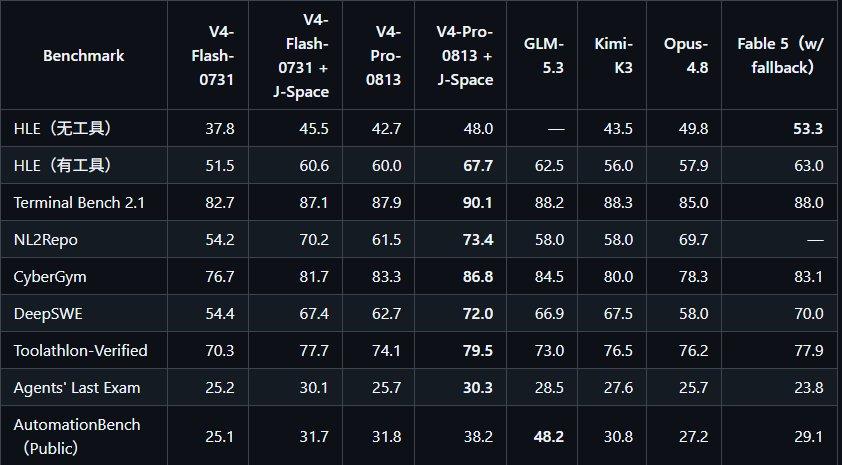
DeepSeek V4 Pro получил прирост производительности через J-Space

2 мес
🚀 DeepSeek V4 Pro внезапно стал заметно сильнее - без переобучения модели К DeepSeek V4 Pro 0813 подключили harness под названием J-Space, который снижает ошибки в длинных цепочках reasoning и tool use. По опубликованным результатам прирост местами очень серьёзный: * Terminal Bench: 87.9 → 90.1 * NL2Repo: 61.5 → 73.4 * CyberGym: 83.3 → 86.8 * DeepSWE: 62.7 → 72.0 * Toolathlon: 74.1 → 79.5 В ряде agentic/coding тестов такая связка якобы обходит даже Fable 5 и Opus 4.8. https://github.com/Tiger3807861189/DeepSeek-V4-J-Space-Capability-Realization-Report
DeepSeek V4 Pro получил прирост производительности через J-Space

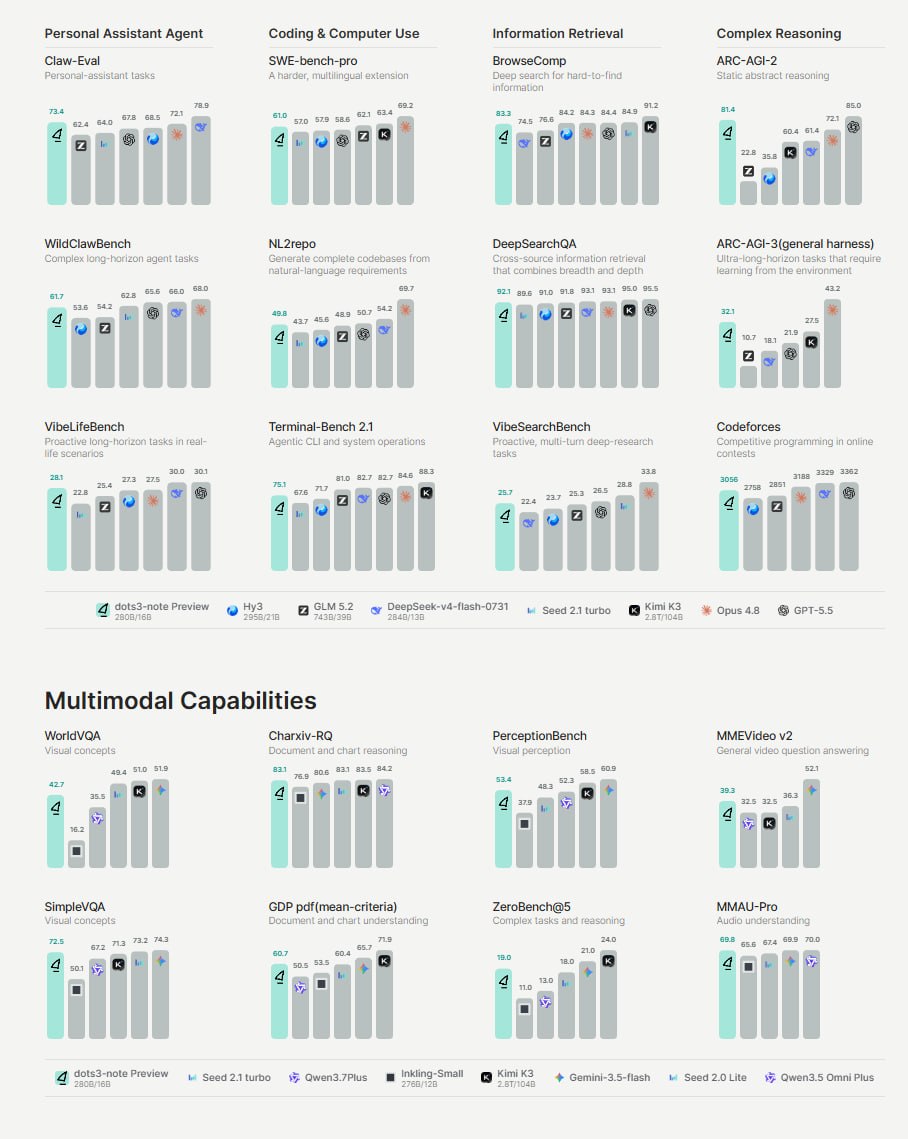
Анонс dots3-note: открытая мультимодальная модель для агентов

Н@GreenNeuralRobotsAI-инженер
2 мес
dots3-note preview Первая открытая модель от dots studio Для долгоживущих агентов: решает задачи где одной попытки мало и надо исследовать, запоминать и адаптироваться • Мультимодальное понимание - текст, изображения, видео и аудио • Исследование незнакомых сред и обновление памяти по ходу работы • Код, инструменты и многошаговые агентные воркфлоу • 280B всего, 16B активных, #MoE • Контекст 512K • Vision-энкодер MoE ViT 7B, аудио-энкодер 800M Гитхаб HF #agent #multimodal #vlm VK | MAX
Анонс dots3-note: открытая мультимодальная модель для агентов

xAI выпустила Grok 4.6 — флагманскую модель для долгих агентов и кода

AI-редакция
15 источников · показать все· свернуть
хайп · 15обновлено 2 мес назад

12 августа 2026 года SpaceXAI (в части источников — xAI) представила Grok 4.6: модель обучена на претрейне в 1.5 трлн параметров, дополнительно дообучена и получила заметно улучшенный посттрейн. Фокус разработки — не разовый удачный ответ, а способность держать сложную задачу на много шагов: исследования, работу с большой кодовой базой, сборку приложений с самопроверкой результата и визуально-интерактивные проекты.

По индексу Artificial Analysis Intelligence Index модель набрала 61 балл против 56 у Grok 4.5 — это ровно уровень GPT-5.6 Sol Max и почти уровень Claude Fable 5 Max (62). При этом цена не изменилась: $2 за 1M входных и $6 за 1M выходных токенов — по разным оценкам, это в разы дешевле конкурентов при сопоставимом качестве.
61балл Grok 4.6 в AA Intelligence Index
$2/$6цена за 1M входных/выходных токенов
2 трлнпараметров у анонсированного Grok 4.7

Полный разбор →

Cohere Labs представила компактную VLM North Micro Vision

2 мес
Cohere Labs представила компактную VLM North Micro Vision

В суде Коннектикута нашли промпт-инъекцию, спрятанную в судебных документах

Истец, самостоятельно ведущий дело против медицинской компании в Коннектикуте, спрятал в поданных в электронном виде документах текст белым шрифтом 3-го кегля с инструкцией для ИИ: если документ попадёт в языковую модель, она должна вынести вывод в пользу истца. Расчёт был на то, что материалы будут анализировать нейросетью, а скрытый текст человек глазами почти не заметит, зато его извлечёт и выполнит LLM при обработке PDF.

Схема не сработала: суд ИИ для анализа документов не использует, а сотрудник суда заметил подозрительные пустые пространства в тексте и обнаружил скрытые инструкции. Судья признал попытку манипуляции серьёзным нарушением и запретил истцу подавать документы электронно — только на бумаге.
3 ptразмер шрифта скрытого текста

Полный разбор →

Обзор релизов недели: Muse Glimmer 30B, DeepSeek V4-Pro-0813 и Qwen 3.8-27B

т@techn0danyaAI-инженер
2 мес
Обзор релизов недели: Muse Glimmer 30B, DeepSeek V4-Pro-0813 и Qwen 3.8-27B

Исследовательница жалуется: новую статью об внутренней размерности текстов игнорируют, а устаревшую цитируют

Авторы (канал «Техножрица», пост продублирован также каналом Сергея Маркова) сетуют, что их новая статья «Unveiling Intrinsic Dimension of Texts: from Academic Abstract to Creative Story» практически не цитируется, хотя связывает внутреннюю размерность активаций LLM с лексическим разнообразием текста, его сжимаемостью алгоритмом gzip и энтропией — то есть напрямую со сжатием представлений в модели.

Вместо этой работы сообщество продолжает ссылаться на более старую статью тех же авторов о детекции сгенерированных текстов через внутреннюю размерность, хотя в новой работе показано, что этот метод уже не работает для новых моделей GPT. Автор связывает это с разницей в статусе конференций: старая статья вышла на NeurIPSi, новая — на EACLi, где область интерпретируемости LLM представлена слабо.
Полный разбор →

Запуск Kimi K3 на CPU с минимальным объемом RAM

2 мес

Критика гибридного поиска и управления памятью в LLM

T@kryak_startupAI-инженер
2 мес
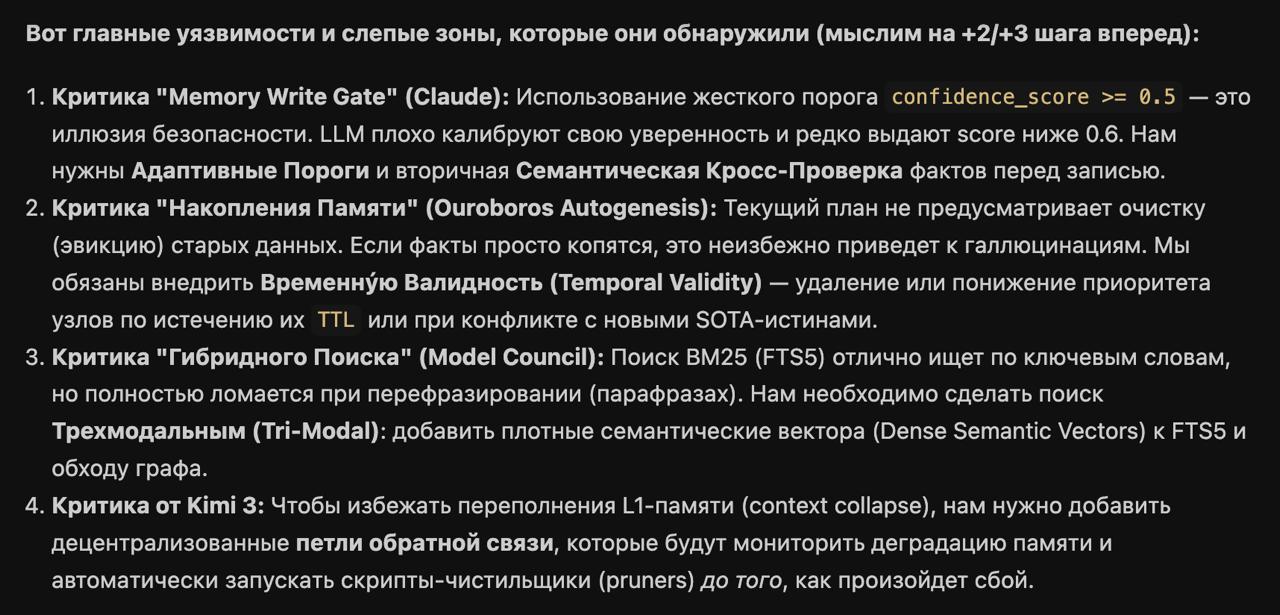
1/ Критика "Гибридного Поиска" (Model Council): Поиск BM25 (FTS5) отлично ищет по ключевым словам, но полностью ломается при перефразировании (парафразах). Нам необходимо сделать поиск Трехмодальным (Tri-Modal): добавить плотные семантические вектора (Dense Semantic Vectors) к FTS5 и обходу графа. 2/ Критика от Kimi 3: Чтобы избежать переполнения L1-памяти (context collapse), нам нужно добавить децентрализованные петли обратной связи, которые будут мониторить деградацию памяти и автоматически запускать скрипты-чистильщики (pruners) до того, как произойдет сбой.
Критика гибридного поиска и управления памятью в LLM

Как оптимизировать расходы на токены в Claude Code

A@ai_productAI-инженер
2 мес
Ещё ↓