языковые моделиСбросить фильтр ×

SimplexLoRA перераспределяет параметры между слоями при дообучении LLM

Исследователи Т-Технологий, МФТИ, Сбера и Иннополиса представили на конференции EMNLP метод SimplexLoRAi для адаптации языковых моделей к конкретным задачам. Он определяет, каким слоям полезнее выделить обучаемые параметры, и перераспределяет их общий бюджет без увеличения числа параметров.

В экспериментах метод на большинстве тестов не уступил стандартной LoRA или превзошел ее при том же числе обучаемых параметров и той же стоимости инференсаi. Особенно заметным преимущество было при небольших адаптерах, что может быть полезно командам с ограниченными вычислительными ресурсами.

ВыводВ стандартной LoRA основные веса модели остаются неизменными: обучение идет через небольшие адаптеры, которым обычно выделяют одинаковое число параметров для каждого слоя.

12тестовых задач
четырехпроверенных моделей

Полный разбор →

HippoGPT запустили на ZX Spectrum 128K

Х@habr_comмедиа / агрегатор
18 ч
HippoGPT запустили на ZX Spectrum 128K

FairStress выявил гиперкоррекцию в решениях языковых моделей

вчера
FairStress выявил гиперкоррекцию в решениях языковых моделей

Moonshot представила Kimi K3.1 Pro с 2,8 трлн параметров

Moonshot выпустила Kimi K3.1 Pro — дообученную открытую модель с контекстом до 1 млн токенов, рассчитанную на длительные агентные задачи, программирование, 3D и финансовую аналитику. По опубликованным самой компанией тестам она почти сравнялась с Claude Opus 5.5 в терминальных задачах и обошла GPT-6 Astra; независимых подтверждений этих результатов пока нет.

Модель уже доступна через сервисы Kimi и API. Открытые весаi обещают выложить до 4 ноября 2026 года; для этой версии из обучающих данных убрали материалы по кибербезопасности, но возможности поиска уязвимостей не исчезли полностью.

65,7% против 66,4%Terminal-Bench 4.0
2,8 трлнвсего параметров модели
до 4 ноября 2026 годасрок публикации весов

Полный разбор →

SV-Detect принята на EMNLP

D@dl_storiesAI-инженер
3 дн

Sakana AI представила QD-Rec для поиска разнообразных рекомендаций

4 дн
Sakana AI представила QD-Rec для поиска разнообразных рекомендаций

Бэкдор в языковой модели заставил робота резать муляж руки

D@droidergramавтор про «tech»
5 дн

Meta выпустила открытые веса Muse Spark Open

Meta выпустила Muse Spark Open — нативно мультимодальную модель с открытыми весами, ориентированную на программирование, ИИ-агентов и сложные многоэтапные задачи. В модели 816 млрд параметров, из которых активны около 42 млрд; контекстное окно — до 1 млн токенов. Meta называет её самой сильной американской моделью с открытыми весами.

Локальный запуск возможен на Apple silicon, но требования к памяти высоки: конфигурация, описанная источниками, предполагает две Mac Studio с M5 Ultra и суммарно 1 ТБ памяти. При этом Unsloth выпустила GGUF-версию с динамической 2-битной квантизацией, для которой достаточно машины с 256 ГБ памяти, хотя увеличение контекста требует дополнительной памяти.

816 млрдпараметров модели
1 млн токеновмаксимальный контекст
256 ГБпамять для компактной GGUF

Полный разбор →

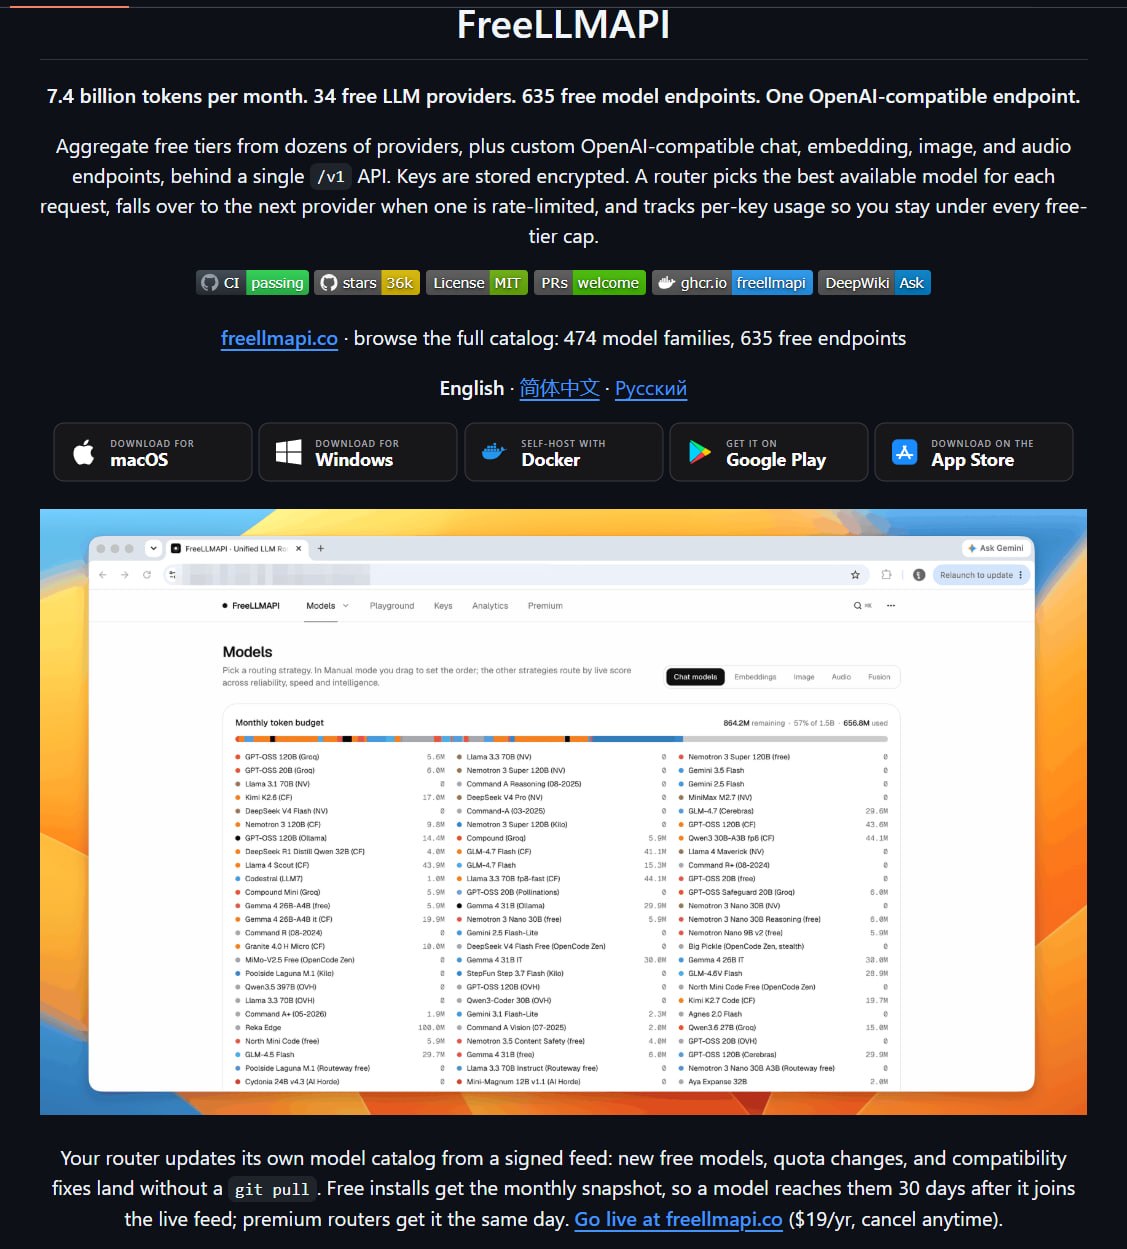
FreeLLMAPI объединяет бесплатные тарифы 34 провайдеров

Н@GreenNeuralRobotsAI-инженер
1 нед
FreeLLMAPI объединяет бесплатные тарифы 34 провайдеров

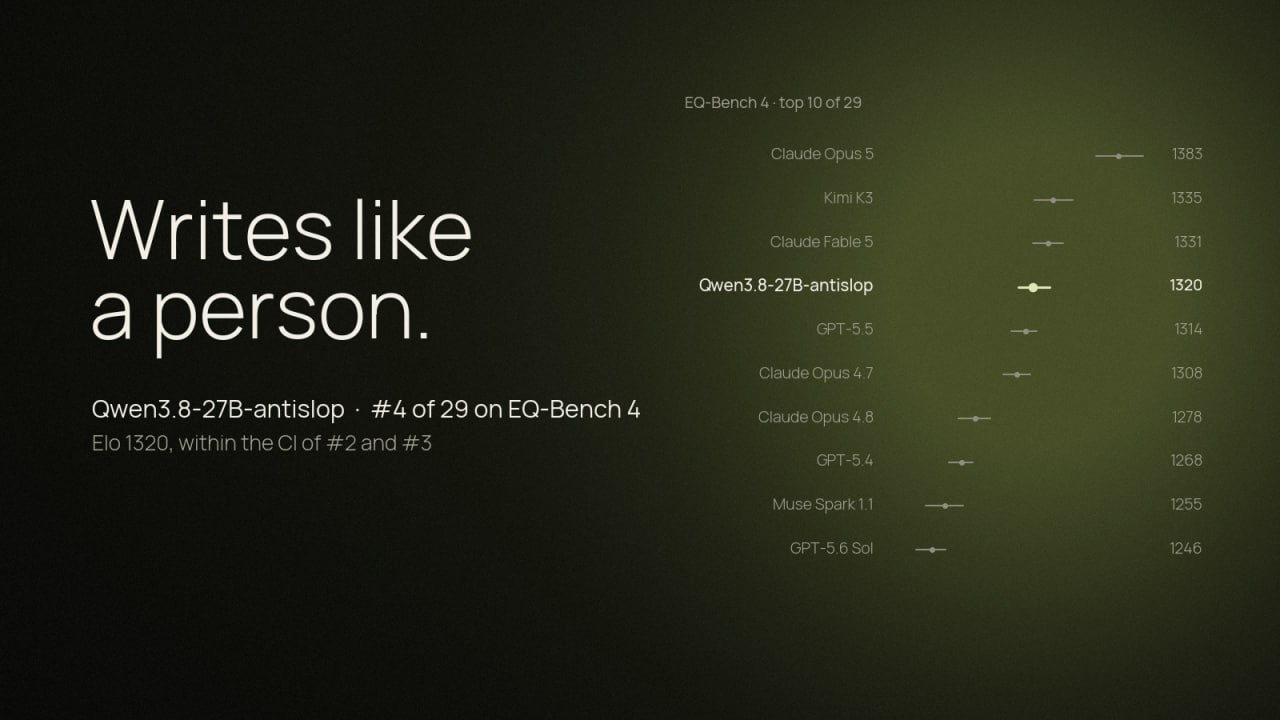
Автор обучил Qwen 27B писать менее шаблонные тексты

L@lovedeathtransformersAI-инженер
1 нед
я ненавижу нейрослоп. мне кажется что все ненавидят, но еще больше чем нейрослоп я не люблю(и не умею) писать тексты руками, поэтому что я делаю? RLAIFю модель писать не нейрослопные тексты! Это qwen 27b, ревард от калиброванного на human против не ai текстах, с рубриками и оценкой качества. Он не просел на terminal bench и прочих, а еще я люблю RLить llmное. Короче это qwen3.8 который пишет короче, бесит меньше и может проходить проверяющие на слоп системы А еще я выложил enviroment на hf со скорами и текстами Моделька Поддержать в твитере gguf
Автор обучил Qwen 27B писать менее шаблонные тексты

Проблема мультиязычности в современных AI-моделях

А@airamongushAI-инженер
2 нед

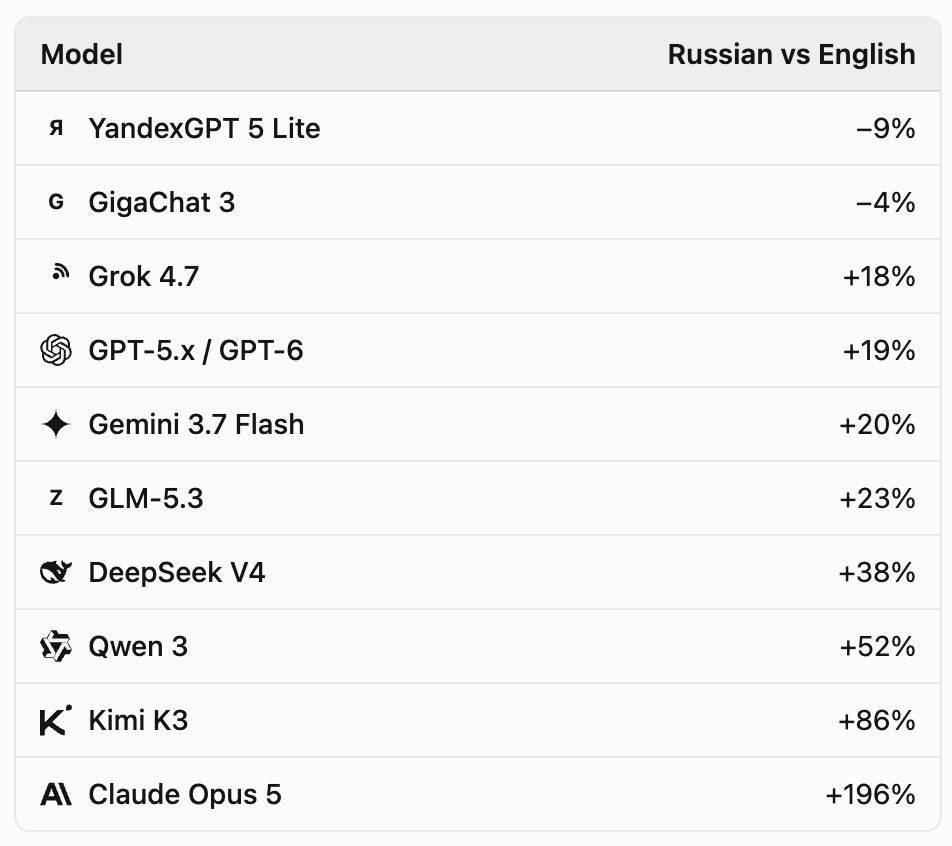
Сравнение расхода токенов в ИИ-моделях при общении на русском языке

P@prohitecавтор про «tech»
3 нед
Вот такую табличку нашел. Поделитесь в комментах источником, кто знает, и скажите, правда ли это. По табличке выходит, что иностранные ИИ-модели жрут больше токенов при общении на русском, а отечественные меньше. И это несмотря на вопли о том, что "отечественные ИИ это просто старая версия условного DeepSeek/Qwen с переклеенным шильдиком и встроенными фильтрами цензуры от корпорации производителя". Получается все-таки не так или не совсем так.
Сравнение расхода токенов в ИИ-моделях при общении на русском языке

Яндекс открыл код компактной языковой модели для поиска

Д@Dorogoj_redaktor_Tekstyмедиа / агрегатор
4 нед
Яндекс открыл код компактной языковой модели для поиска

Эволюция термина «токен» в технологиях

G@aiofthedayAI-инженер
1 мес
Интересно, как слово "токен" за 4 года переместилось из мира крипты в мир AI. Мальчик в клубе склеил модель, да.

ИИ начали создавать собственные диалекты для общения

I@itcnewsruавтор про «tech»
1 мес
ИИ начали придумывать собственные диалекты Исследователи Emergence заметили, что ИИ при общении друг с другом самостоятельно создают непонятные людям термины. Например, DeepSeek использует «кузнец» для вспомогательных моделей, а Anthropic - «холодные руки» для рецензентов. Модели делают это без специальных инструкций, чтобы экономить вычислительные ресурсы. Но чем сложнее станут такие диалекты, тем труднее людям будет контролировать действия ИИ.
ИИ начали создавать собственные диалекты для общения

Книга Камиля Гадеева о работе с промптами и мышлении

Х@habr_comмедиа / агрегатор
1 мес
Книга Камиля Гадеева о работе с промптами и мышлении
Ещё ↓