Сравнение расхода токенов в ИИ-моделях при общении на русском языке
P@prohitecавтор про «tech»
3 недОбсуждение эффективности токенизации русского языка в зарубежных и отечественных ИИ-моделях на основе пользовательской таблицы.
Эффективность токенизации напрямую влияет на стоимость использования ИИ-моделей.
- Разный расход токенов при работе с русским языком меняет итоговую стоимость запросов.
- Оптимизация токенизатора под конкретный язык позволяет моделям работать быстрее и дешевле.
- Вопрос о том, являются ли российские модели самостоятельными разработками, остается предметом дискуссий в сообществе.
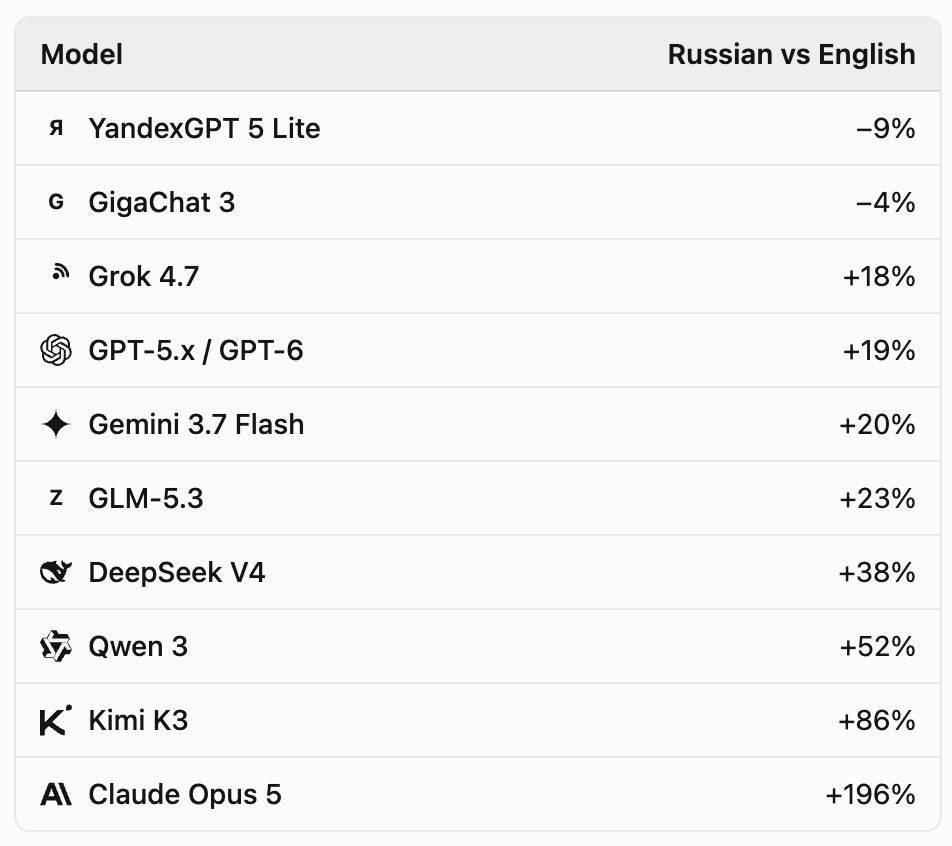
Вот такую табличку нашел. Поделитесь в комментах источником, кто знает, и скажите, правда ли это. По табличке выходит, что иностранные ИИ-модели жрут больше токенов при общении на русском, а отечественные меньше. И это несмотря на вопли о том, что "отечественные ИИ это просто старая версия условного DeepSeek/Qwen с переклеенным шильдиком и встроенными фильтрами цензуры от корпорации производителя". Получается все-таки не так или не совсем так.
Кратко (AI)
Автор поста делится таблицей, согласно которой российские ИИ-модели расходуют меньше токенов при общении на русском языке по сравнению с зарубежными аналогами. Это ставит под сомнение утверждения о том, что отечественные разработки являются лишь переименованными версиями моделей DeepSeek или Qwen с добавленной цензурой.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖