Проблема качества данных при обучении ИИ
Д@disruptors_officialмедиа / агрегатор
1 месКстати, если ИИшку будут реально тренировать на таких данных, и она станет тупая, то это буквально shit in shit out
Исследователи предложили способ сэкономить вычислительные ресурсы при предобучении языковых моделей: на первом этапе претрейна модель учится не на отдельных токенах, а на усреднённых эмбеддингах нескольких подряд идущих токенов, при этом на выходе предсказывается не следующий токен, а «мешок» (bag-ofi) из нескольких следующих токенов без учёта их порядка. После этой стадии обучение продолжается в стандартном режиме.
Экономия достигается за счёт того, что через модель прогоняется в s раз меньше токенов, а значит за тот же вычислительный бюджет модель успевает увидеть больше данных из корпуса — в r·s + (1 − r) раз больше, где r — доля обучения на усреднённых токенах, s — размер окна усреднения.
ВыводМетод проверен на трёх dense llama-like моделях размером 270M, 600M и 3B, а также на MoE-модели 10B-A1B.
Дофаминовая яма - это когда не угадал с ревордом для модели.
Hugging Face встроила в свой чат-бот агента ML Interni, который берёт на себя весь процесс машинного обучения — от текстового описания задачи до готовой модели. Инструмент рассчитан на пользователей без профильного опыта в ML: достаточно словами описать идею, а дальше агент действует самостоятельно.
Это снижает порог входа в разработку нейросетей — теперь для обучения модели не нужно самостоятельно искать датасеты, настраивать инфраструктуру и писать код обучения.
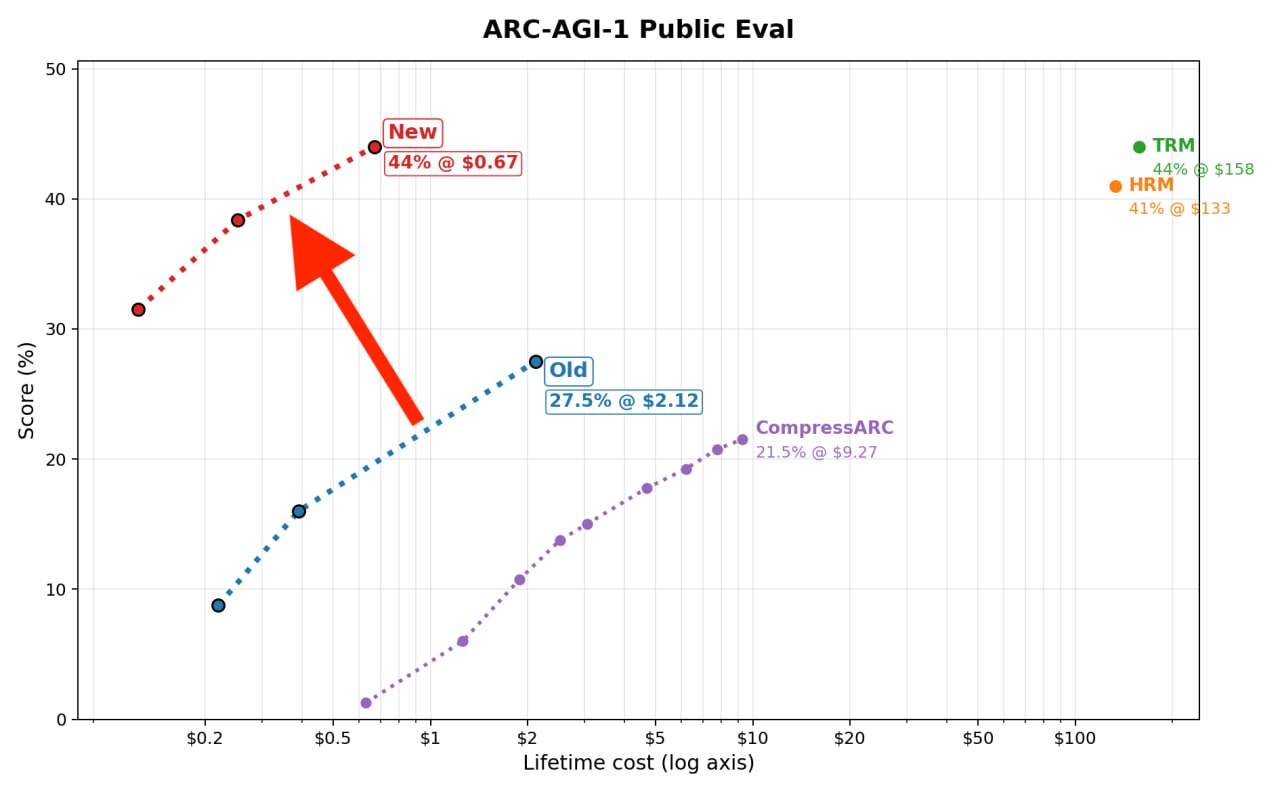
Источники сообщают о неназванной внутренней модели, которая при тех же вычислительных затратах решает значительно больше задач, чем модель Astrai. Обучение модели ещё не завершено, то есть её показатели должны расти дальше.
Главный аргумент — единственный опубликованный график из статьи, где по оси X отложены вычисления на этапе инференса (test-time computei) в логарифмической шкале, а по оси Y — доля решённых задач. При одинаковом бюджете вычислений новая модель решает примерно в 2,5–3 раза больше задач, чем Astra.
ВыводПри одинаковых вычислительных затратах новая модель решает около 38% задач против 14% у Astra
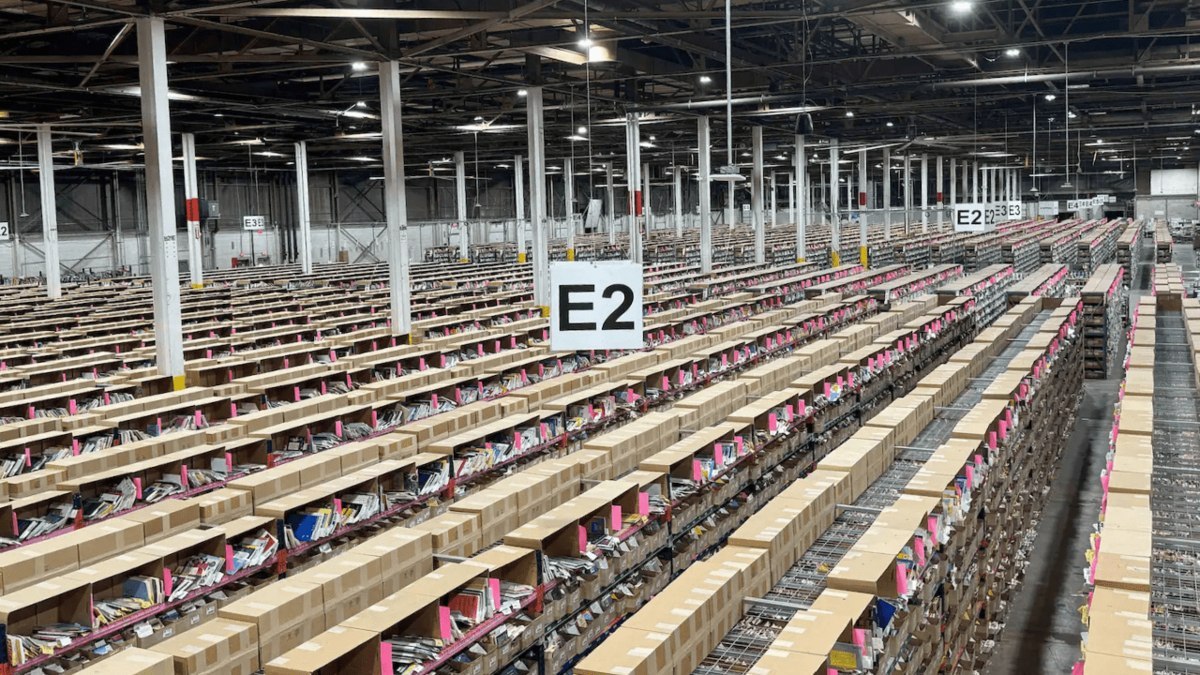
Журналисты выяснили, кто стоит за скупкой и уничтожением бумажных раритетов ради обучения нейросетей: спрятанный в редкой книге трекер привёл к складу Amazon в Лас-Вегасе. Там книги, купленные у букинистов, не хранят для продажи, а вспарывают и оцифровывают — так компания кормит свою модель Novai.
Проект Internet Archivei пытается спасти издания от такой судьбы: волонтёры вручную сканируют книги, которым грозит уничтожение, и выкладывают копии в открытый доступ.
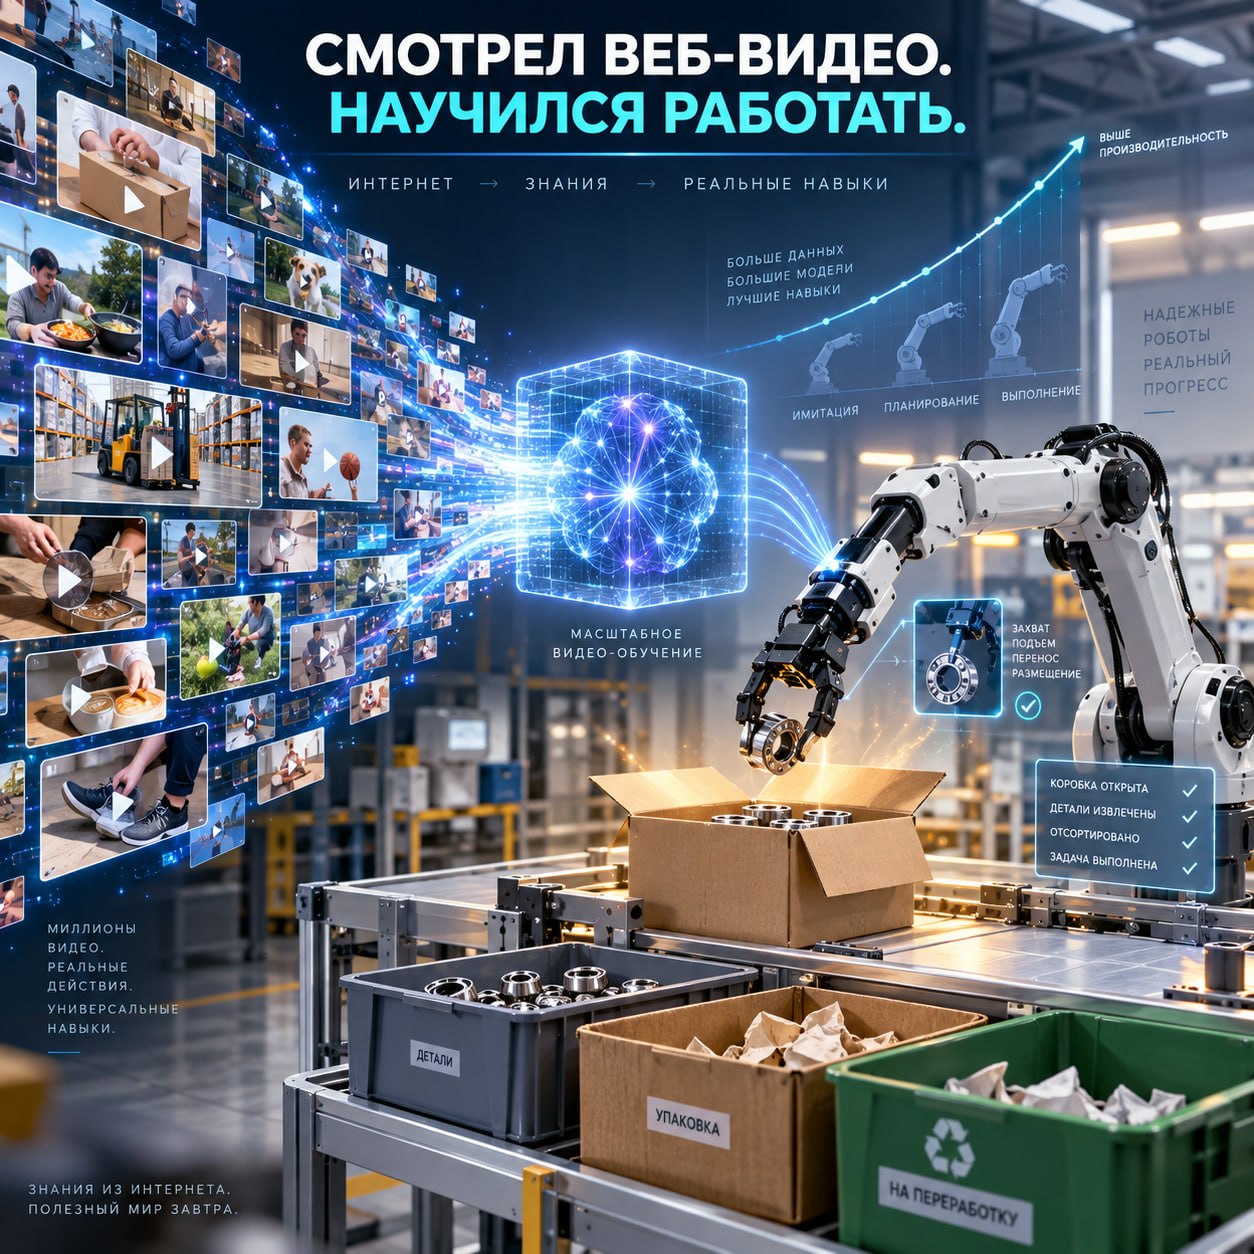
Стартап человекоподобных роботов Figure AI четыре месяца в закрытом режиме тестировал приложение Indexi, через которое обычные люди записывают видео повседневных бытовых задач — мытьё посуды, уборка, работа по дому — и получают за это деньги. Собранные ролики уже используются для обучения модели Helixi, лежащей в основе роботов Figure.
Проблема, которую решает Index: если языковые модели обучают на текстах, которых в интернете полно, то для роботов не хватает данных в формате POV о том, как человек выполняет обычные бытовые действия. Приложение уже доступно в AppStore и GooglePlay, а масштаб сбора данных Figure планирует увеличить ещё в 100 раз.
Обанкротившийся 1 мая крупнейший американский лоукостер Spirit Airlines стал источником нового вида актива: его внутренние корпоративные данные — письма, чаты, финансы, код — были проданы на банкротном аукционе. Победителем стал Google, предложивший $10 млн; данные пойдут на разработку продуктов и обучение ИИ-моделей.
Случай показывает, что рынок ИИ-данных переходит от бесплатного скрапинга публичного интернета и лицензирования качественного контента (как у News Corp или Financial Times) к покупке операционных данных умерших компаний — переписки, регламентов, истории решений. Это нужно, чтобы учить не просто отвечающие модели, а ИИ-агентов, способных управлять реальными бизнес-процессами.
Журналисты 404 Media подтвердили подозрения букинистов: аномально высокий спрос на подержанные книги по всему миру связан не только с читателями, но и с ИИ-компаниями, которым нужны «чистые» данные для обучения нейросетей. Спрятав Apple AirTagi в партию редких изданий, купленных через букиниста, журналисты выяснили, что заказ пришёл на склад Amazon — там книги разрезают для быстрого сканирования и затем утилизируют.
Это продолжение истории с Anthropic, которая ранее скупала, сканировала и уничтожала миллионы бумажных книг для обучения своих моделей; суд признал такую практику «добросовестным использованием». Теперь похожая схема обнаружена у Amazon, а активисты из Anna's Archive призывают волонтёров массово сканировать книги, чтобы сохранить их в открытом доступе, прежде чем их скупят и уничтожат ИИ-лаборатории.