llmСбросить фильтр ×

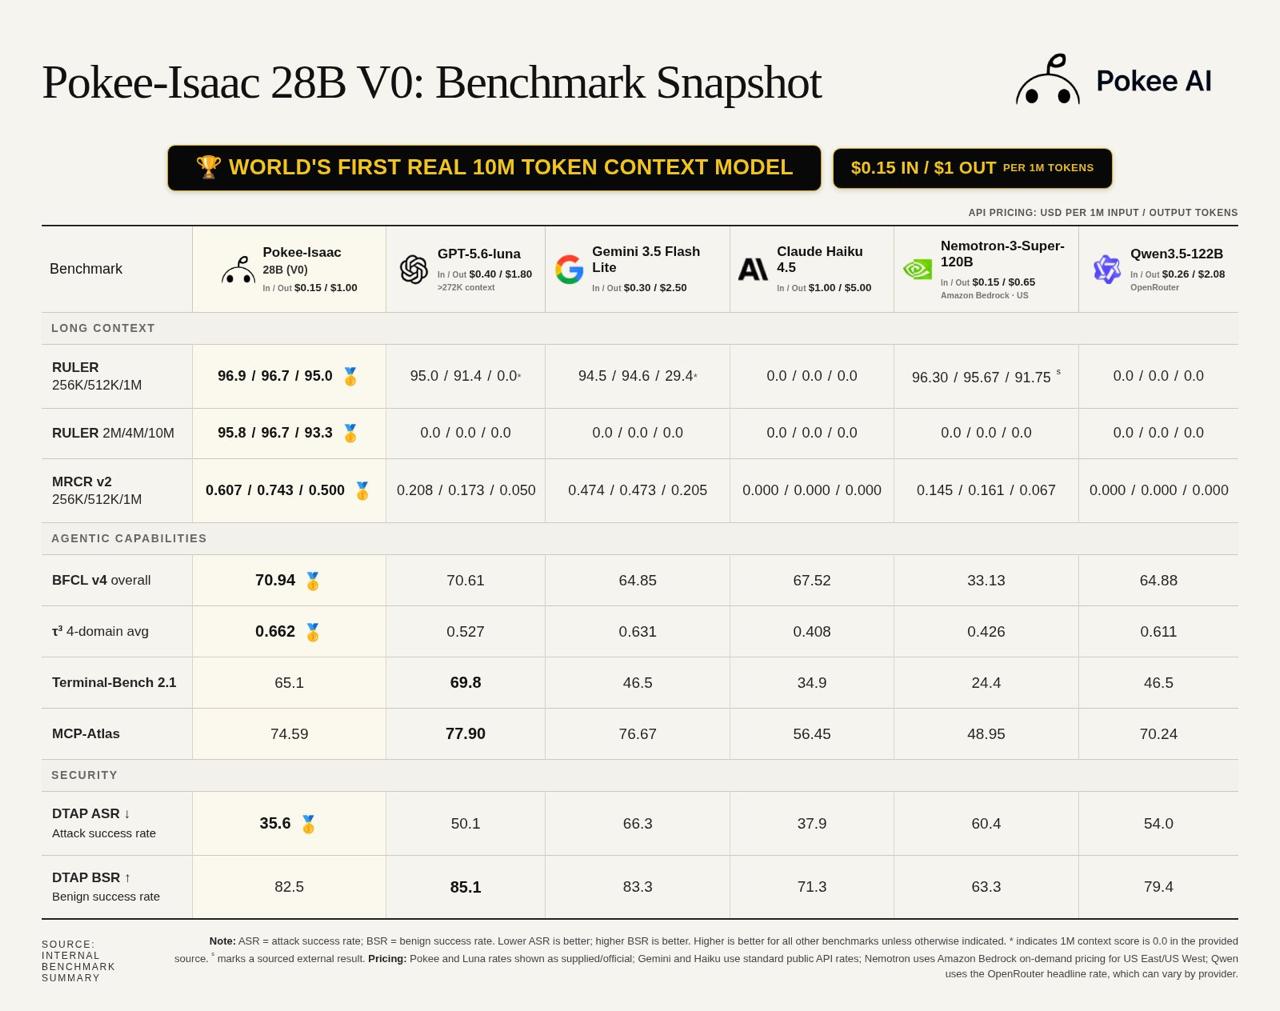
Pokee представила агентную модель Isaac 28B с контекстом 10 млн токенов

2 мес
Pokee представила агентную модель Isaac 28B с контекстом 10 млн токенов

Yandex AI Studio добавила инструмент Monium Traces для анализа поведения ИИ-агентов

В Yandex AI Studio появился новый инструмент observabilityi — Monium Tracesi, который показывает полный путь выполнения ИИ-агента: системные и пользовательские промпты, ответы модели, вызовы инструментов и контекст каждого шага.

Обычный мониторинг для агентных систем малополезен: метрики могут быть «зелёными», а агент при этом потеряет контекст, выберет неподходящий инструмент или уйдёт в бесконечный цикл. Трейсы позволяют увидеть саму цепочку принятия решений и быстро найти момент, где агент начал работать некорректно.

Полный разбор →

Firecrawl выпустила опенсорсный Rust-парсер документов anydoc (бывший pdf-inspector)

Компания Firecrawl открыла исходный код быстрого парсера документов на Rusti. Сначала инструмент называли pdf-inspector и он конвертировал только PDF в Markdown, но затем Firecrawl расширила его до anydoc — библиотеки, которая переводит в Markdown не только PDF, но и DOCX, PPTX, XLSX и ещё около 10 других форматов, сохраняя заголовки, таблицы, списки и общую структуру документа.

Инструмент рассчитан на подготовку данных для RAGi-пайплайнiов и AI-агентов: он ставится локально (в том числе на макбук, работает в браузере) и встраивается напрямую в пайплайны обработки документов, например в Claude Code.

0,002 секвремя обработки одной страницы PDF
0,47 секвремя конвертации PDF на 200 страниц
<5 мссреднее время обработки документа в anydoc

Полный разбор →

Безопасность данных при использовании ИИ в разработке

Х@habr_comмедиа / агрегатор
2 мес
Безопасность данных при использовании ИИ в разработке

Экономика AI-агентов: почему стоимость токенов обманчива

П@badTechProjectAI-инженер
2 мес
Экономика AI-агентов: почему стоимость токенов обманчива

Liquid AI выпустила компактную агентную модель LFM2.5-2.6B для локальной работы на смартфоне

Liquid AI представила LFM2.5-2.6B — агентную модель на 2,6 млрд параметров, которая полностью работает на устройстве: планирует действия, вызывает инструменты и выполняет многошаговые задачи без облачного API. Это важно для тех, кто хочет запускать ИИ-агентов локально, без затрат на облачную инфраструктуру и с сохранением приватности данных.

По тестам разработчика, модель по ряду задач на следование инструкциям и tool usei превосходит более крупные Gemma и Qwen, при этом потребляет менее 2,5 ГБ памяти на CPU.

2,6 млрдпараметров модели LFM2.5-2.6B
34 трлнтокенов в обучающих данных
128Kразмер контекстного окна

Полный разбор →

Kimi K3: китайская MoE-модель на 2,8 трлн параметров с открытыми весами — и скрытая цена «бесплатности»

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 2 мес назад

Китайская компания Moonshot AI выпустила Kimi K3 — MoEi-модель с 2,8 трлн общих и 104 млрд активных параметров, открытыми и бесплатно скачиваемыми весами, native vision и контекстом в 1M токенов. По заявлению авторов, это первая открытая модель 3T-класса, и по многим тестам она приблизилась к топовым закрытым американским моделям, вызвав ажиотаж в индустрии — вплоть до реакции Илона Маска, который назвал релиз «впечатляющим» и сообщил, что xAI готовит ответ на 2 трлн параметров.

Однако «бесплатность» весов не означает дешевизну использования: по официальным рекомендациям Moonshot AI для развёртывания К3 нужна конфигурация «суперузла» из 64+ ускорительных карт, с первоначальными инвестициями порядка 20 млн юаней (~$3 млн), не считая затрат на электроэнергию — что резко ограничивает круг тех, кто реально может запустить модель у себя.

2.8T / 104Bобщие и активные параметры Kimi K3
1M токеновдлина контекста модели
~$3 млн (20 млн юаней)минимальные инвестиции в инфраструктуру для запуска

Полный разбор →

Критика рынка обучения AI evals

N@proproductкарьера / HR
2 мес

Методика оценки качества квантованных моделей

T@extremecodeAI-инженер
2 мес
Методика оценки качества квантованных моделей

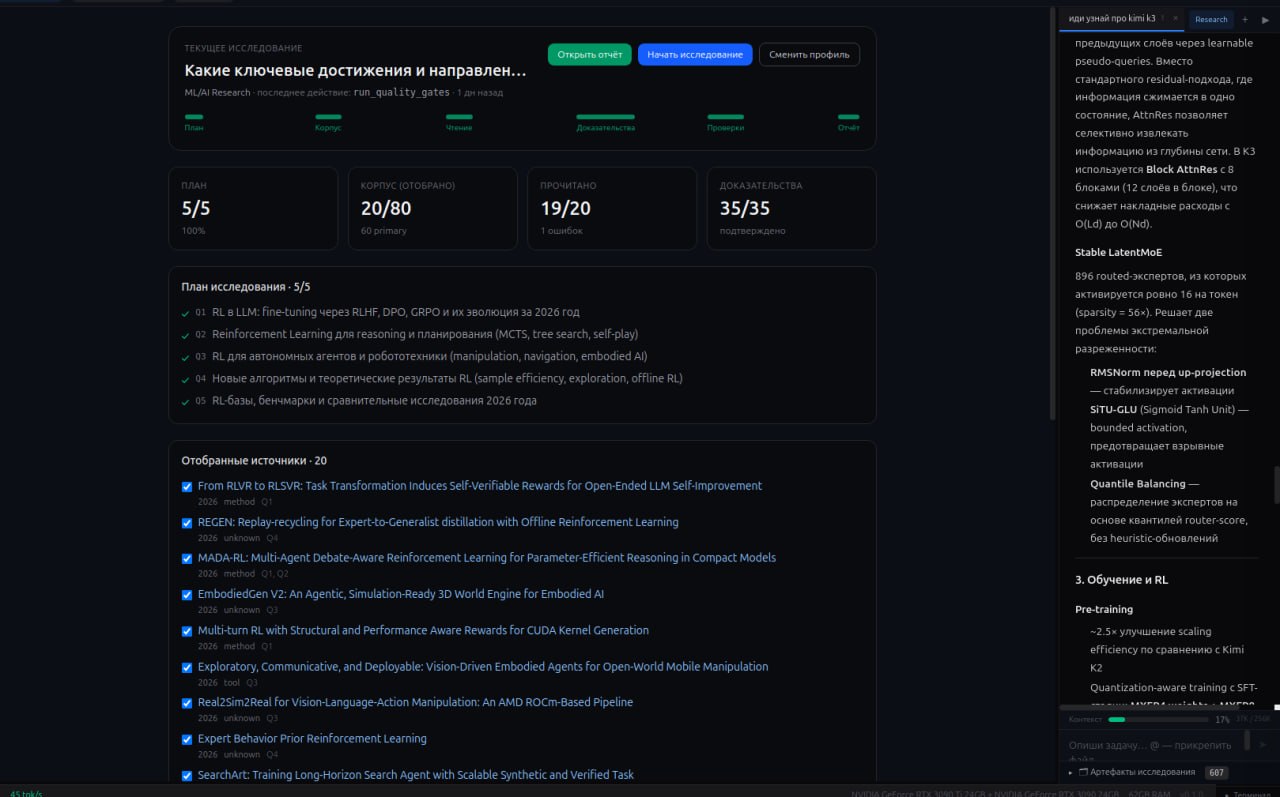
Обновление локального исследовательского агента на базе Qwen

А@AGI_and_RLAI-инженер
2 мес
Обновление локального исследовательского агента на базе Qwen

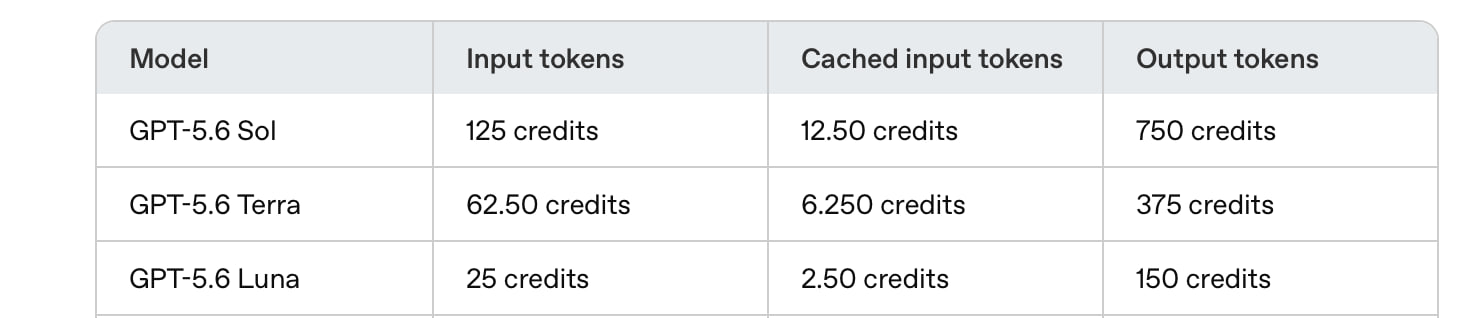
Дайджест AI за неделю: веса Kimi K3, снижение цен GPT‑5.6, обновление DeepSeek V4 Flash и новые видео- и робот-модели

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 2 мес назад

На неделе с 27 июля по 2 августа 2026 вышло сразу несколько крупных релизов в LLM и генеративных моделях. Moonshot AI открыли веса своей крупнейшей модели Kimi K3 (2.8T параметров), OpenAI снизили цены на линейку GPT-5.6 и представили математическую мультиагентную модель Astra, а DeepSeek обновили V4 Flash без изменения архитектуры. Параллельно ByteDance и MiniMax выпустили новые генераторы видео, а Google DeepMind — модель для управления роботами.

События показывают, что гонка идёт одновременно по нескольким фронтам: открытые веса больших LLM, снижение цены токена, доказательства математических теорем через ИИ и мультимодальная генерация видео/аудио с точным контролем движения.

2.8Tпараметров Kimi K3
$0.14/$0.28цена за млн токенов DeepSeek V4 Flash
180 секундмакс. длина видео Seedance 2.5

Полный разбор →

Риски стартапов перед лицом развития LLM

M@startup_ventureавтор про «startups»
2 мес

WASTE: движок на 6000 строк C запускает полновесную Kimi K3 без GPU, подгружая экспертов с SSD

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 2 мес назад

Разработчики SQLite AI создали инференс-движок WASTE (6000 строк C, без BLAS, CUDA и Python в рантайме), который позволяет запускать полновесную MoEi-модель Kimi K3 на обычном железе — вплотную к пределу возможностей потребительских дисков и памяти. Модель никогда полностью не загружается ни в RAM, ни в VRAM: в память кладётся только «плотный» резидентный блок, а нужные на каждом шаге эксперты подтягиваются прямо с диска.

Это важно, потому что Kimi K3 — гигантская MoE-модель (по разным оценкам 2,8–3 трлн параметров), которая в обычном виде требует терабайты памяти. WASTE показывает, что такие модели можно гонять локально без серверных стоек с DDR5, хотя цена — скорость в доли токена в секунду.

982 ГиБразмер сконвертированной модели K3
0,49-0,54 токена/сскорость на MacBook с 64 ГБ
6000 строкобъём кода движка WASTE на C

Полный разбор →

Релиз модели Qwythos-27B-v1 от Empero

Н@GreenNeuralRobotsAI-инженер
2 мес
Qwythos-27B-v1 27B версия модели от Empero на базе Qwen3.5-27B, дообученная под агентские сценарии и работу с инструментами. Архитектура не урезана, все ключевые компоненты (MTP, vision) остались без изменений • нативная MTP-головка - ускорение генерации через self-speculative decoding • встроенная поддержка function calling, сразу выдаёт <tool_call> без доп. обёрток • заточка под CLI-агентов и многошаговые вызовы инструментов • полная мультимодальность, сохранена исходная vision-архитектура • контекст 1M токенов • лицензия Apache-2.0 Квантизации #multimodal #coding #agent #reasoning #toolcall #gguf
Релиз модели Qwythos-27B-v1 от Empero

Сравнение эффективности моделей Codex и Claude Code

J@junior_pmAI-инженер
2 мес
Сравнение эффективности моделей Codex и Claude Code

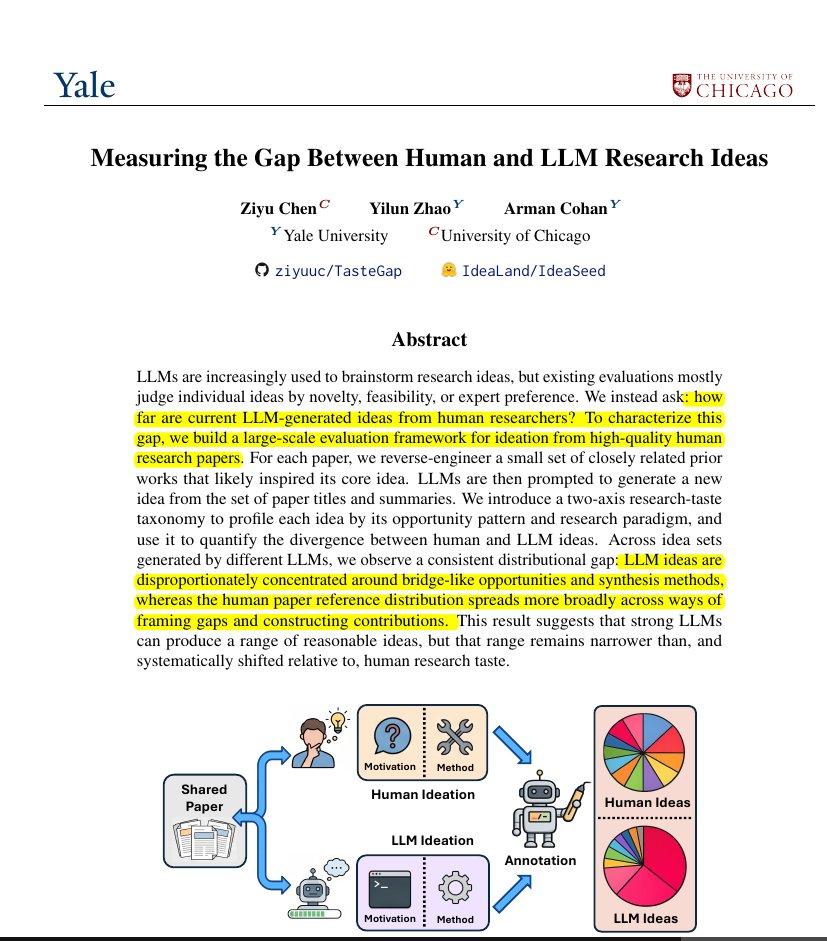
LLM придумывают научные исследования менее разнообразно, чем люди

2 мес
LLM придумывают научные исследования менее разнообразно, чем люди
Ещё ↓