генерация музыкиСбросить фильтр ×

Alibaba выпустила генератор музыки HappyShrimp 1.0

1 нед

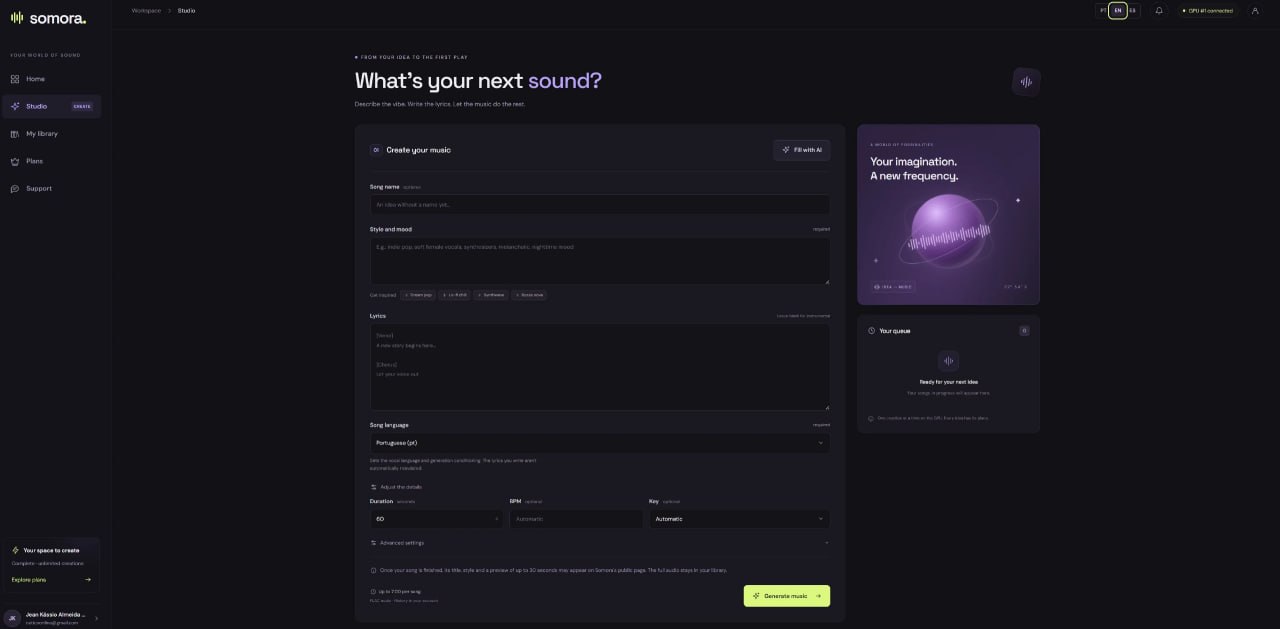
Somora: сервис для генерации музыки из текста

Н@GreenNeuralRobotsAI-инженер
2 нед
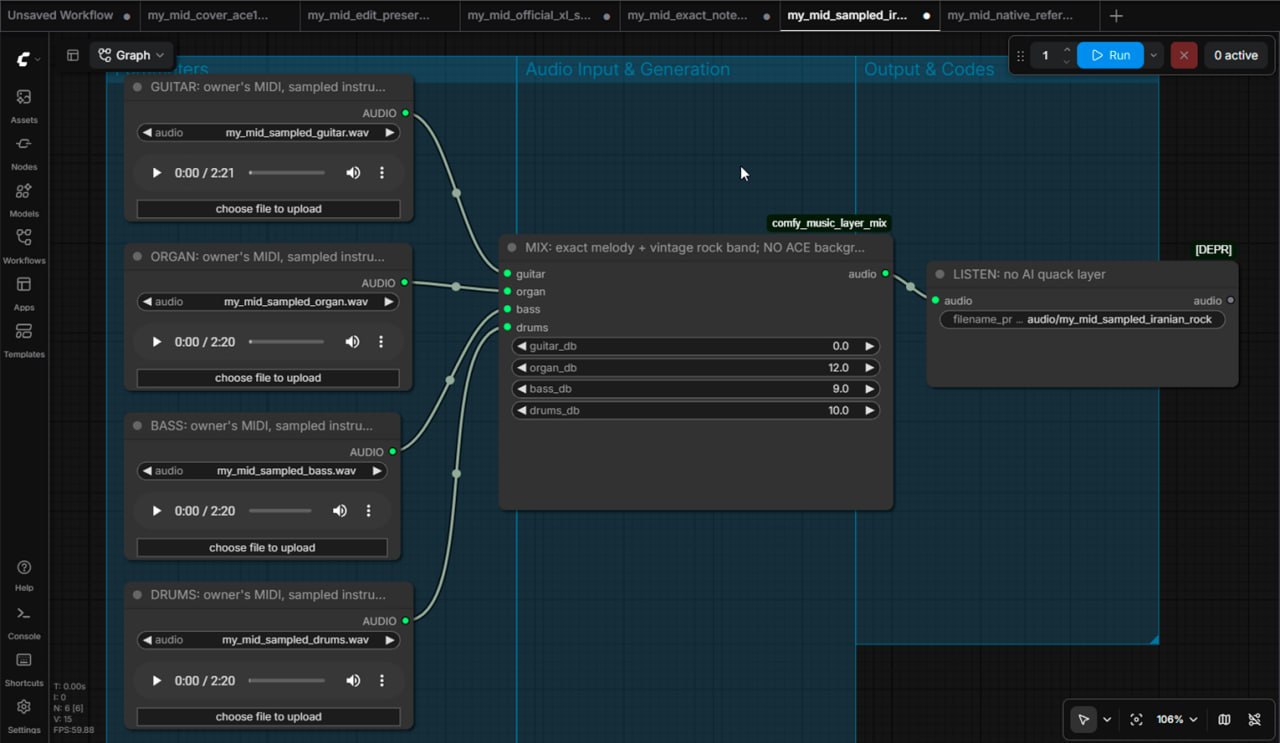
Somora Сайт для создания ИИ-песен из текста или музыкальной идеи, без работы с ComfyUI напрямую. Опиши стиль и настроение, напиши или сгенерируй текст — и получи готовый трек • Песня с текстом или инструментальная композиция • Выбор стиля, длительности, BPM и тональности • Выбор языка песни • Трек через ChatGPT-плагин (пишет лирику и заполняет форму) • Скачивание в FLAC • Бэкенд — Ace-Step 1.5 XL (SFT + SFT/Turbo), через свой ComfyUI-нод AceStep SFT • Бесплатный тариф, для старта 2 генерации в день • Есть платные Básico и Completo #t2m MAX
Somora: сервис для генерации музыки из текста

YuE2: открытая модель для генерации песен с редактируемой партитурой

N@neurohiveAI-инженер
4 нед

Обновления экосистемы YuE2: техрепорт, VAE и новые инструменты

Н@GreenNeuralRobotsAI-инженер
4 нед

Опыт использования ACE Studio для создания музыки

М@cgeventAI-инженер
1 мес
Опыт использования ACE Studio для создания музыки

YuE2: вокруг музыкальной ИИ-модели за неделю выросла целая экосистема плагинов для ComfyUI

Музыкальная генеративная модель YuE2 получила официальную поддержку в ComfyUIi: 20 сентября 2026 вышла стабильная версия с базовой интеграцией, а 25 сентября в основной репозиторий Comfy-Org/ComfyUI влился PR #16250 (вошёл в релиз v0.36.0), добавивший генерацию музыки по стилю и тексту, плюс PR #16293 с фиксами для AMD и расширенным контролем ABC-нотации.

Вслед за официальной поддержкой за неделю появилось множество независимых инструментов и LoRAi под YuE2: студии для локальной генерации песен и каверов, обучение LoRA под конкретный стиль или артиста, ноды для правки готовых треков и клонирования голоса, ускоренные workflow и радио на базе LLM. Для контент-мейкеров и разработчиков это означает быстрый переход YuE2 от нишевой модели к полноценной production-цепочке с открытым инструментарием.
2700треков в наборе инструментальных LoRA
16xускорение KSampler в workflow Supernova
v0.36.0версия ComfyUI с генерацией YuE2 по стилю и тексту

Полный разбор →

Обзор инструментов для генерации музыки: MuLaCover и DiffSynth-Music

Н@GreenNeuralRobotsAI-инженер
1 мес

Релиз семейства моделей StepAudio 3

Н@GreenNeuralRobotsAI-инженер
1 мес
StepAudio 3 Новые модели от Степана StepAudio 3 Realtime Полнодуплексная аудио-языковая модель. Говорит и слушает одновременно, размышляет вслух не замолкая китайский и английский StepAudio 3 Music Генерация песен: планирует структуру (куплеты, припев, бридж, аранжировку), создает 48-kHz стерео до 5м 30с язык задается описанием песни Помимо этого в семейство вошли говорилка с дизайном голоса Gen, TTS и ASR китайский, английский, японский, корейский, французский, испанский Voice Studio - пока только разговорная, музыка анонсирована #musicediting #dialog #asr #tts #voicedesign

Nova AI: универсальный плагин для генерации музыки в DAW

Н@GreenNeuralRobotsAI-инженер
1 мес
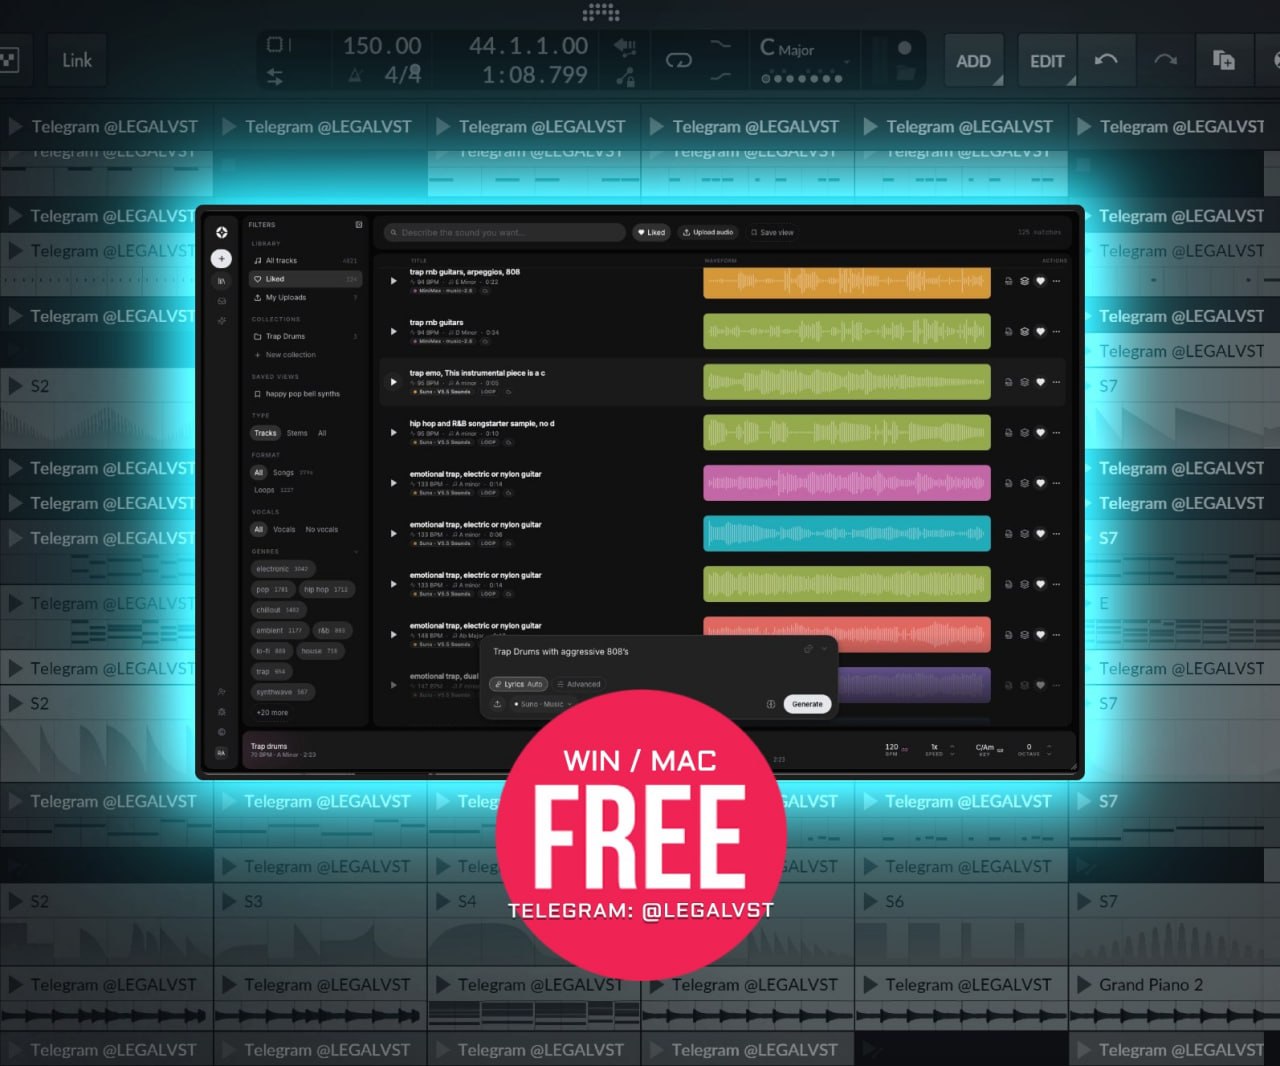
Nova AI: универсальный плагин для генерации музыки в DAW

Инструментарий MiniMax Music для ComfyUI

Н@GreenNeuralRobotsAI-инженер
1 мес
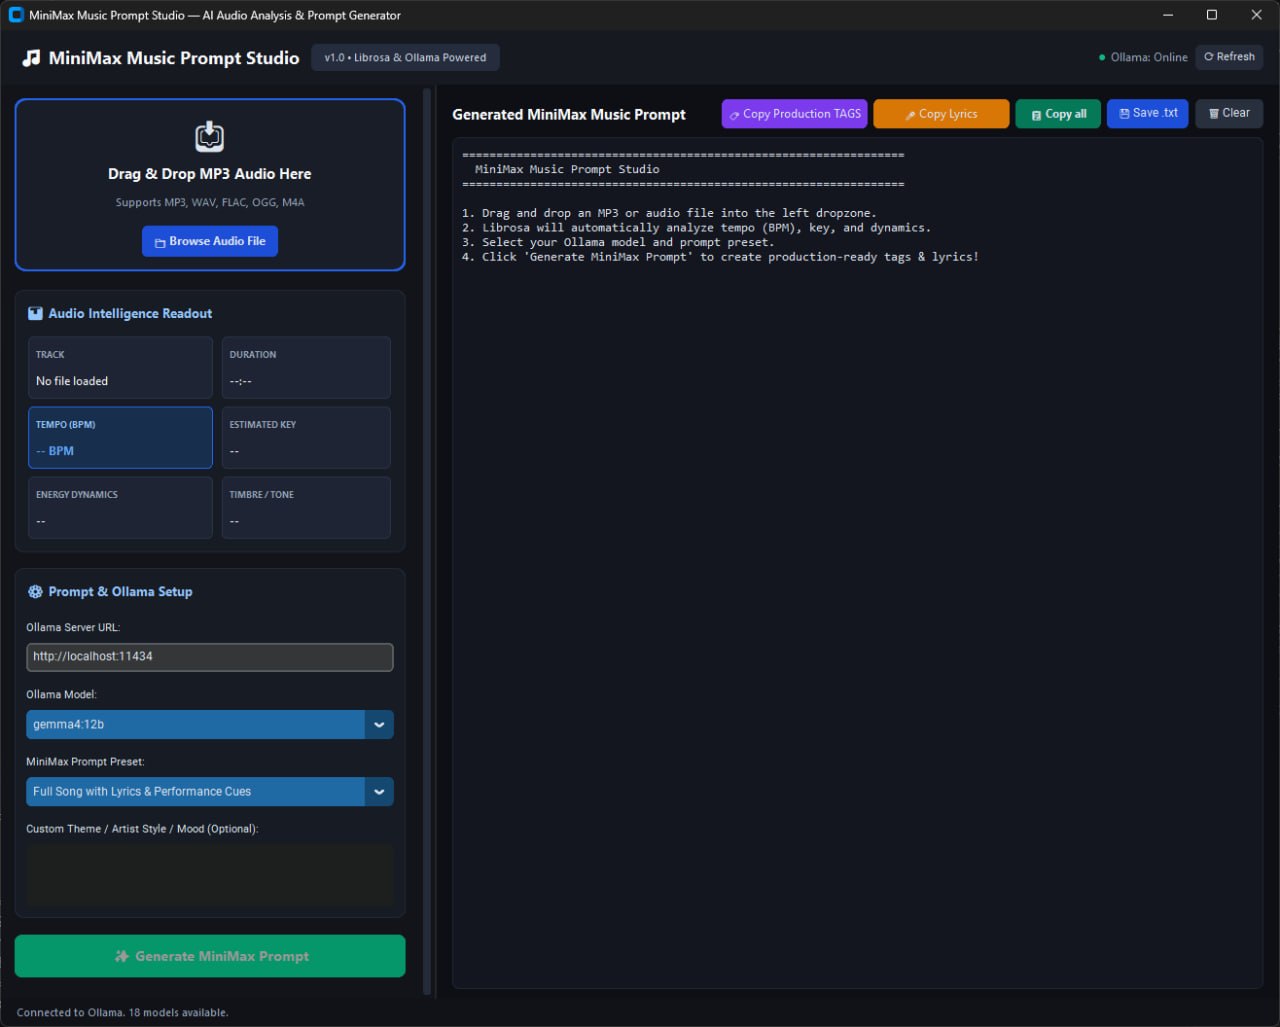
Инструментарий MiniMax Music для ComfyUI

Suno отменяет списание кредитов на 40 часов

М@cgeventAI-инженер
1 мес
Suno раздает кредиты Следующие 40 часов (от момента написания поста) у всех ПЛАТНЫХ планов генерации НИЧЕГО не стоят. Ваши кредиты просто не тратятся. Включая работу в Studio. Не спать! @cgevent

YuE2: открытая модель генерации музыки с редактируемой партитурой

Вышла YuE2 — новая версия открытого генератора музыки, который сначала создаёт редактируемый музыкальный план (мелодию и аккорды), а затем превращает его в полноценную песню с вокалом и инструментами. Это позволяет вручную вмешиваться в процесс: сохранять мелодию, менять гармонию, стиль, добавлять соло или загружать собственную партитуру в формате ABC notationi.

По качеству модель приближается к Suno v5, при этом работает локально и быстро на потребительских GPU. Авторы утверждают, что YuE2 превосходит Mureka 9 и Minimax 3, целясь в уровень Suno 5. Главная оговорка — лицензия CC BY-NC 4.0i запрещает коммерческое использование.
71 секундавремя генерации 3.6-мин песни на RTX 4090
3Bразмер модели YuE2
48 kHzкачество выходного аудио, stereo

Полный разбор →

Обзор инструментов и обновлений для MiniMax Music 3

Н@GreenNeuralRobotsAI-инженер
1 мес
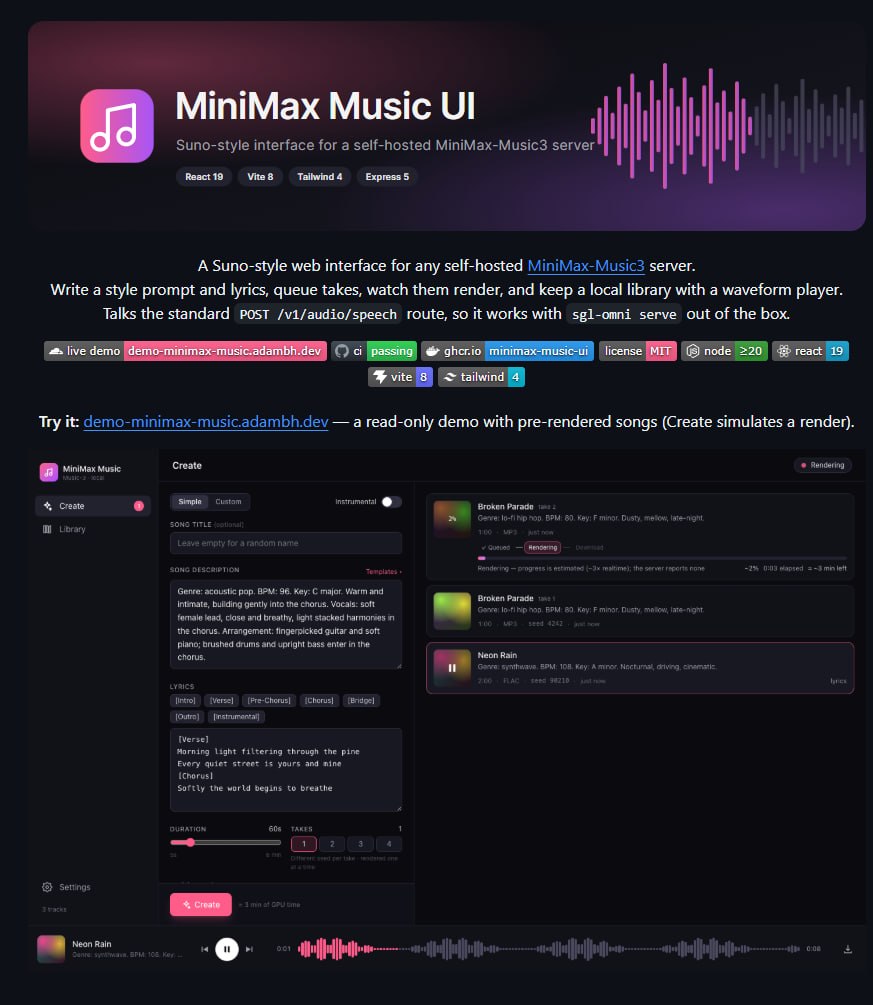
Накопилось по #minimaxmusic3 huggingface.co/nerualdreming/open-rvq-encoder-minimax-music3-169m-v4-onnx - RVQ-энкодер 169M для MiniMax Music: трек в коды, доработка, замена секций, ONNX github.com/deepbeepmeep/Wan2GP - Wan2GP обновился до MiniMax Music 3, FL2VA, Ref2VA github.com/adambenhassen/minimax-music-ui - Suno-интерфейс локально для MiniMax Music с библиотекой треков github.com/Senzube4n/AIPLAY-Studio - локальная студия: музыка, обложки, видео, DAW, композитор, MCP для агентов huggingface.co/ChrisColeTech/minimax-music3-GGUF/tree/main/split/text_encoders - текстовый энкодер GGUF #text2music #gguf VK | MAX
Обзор инструментов и обновлений для MiniMax Music 3

MiniMax Music 3 Latent Refiner v0.10 от Terminus Research

Н@GreenNeuralRobotsAI-инженер
2 мес
MiniMax Music 3 Latent Refiner v0.10 (Terminus Research) Аудио-рефайнер для генератора песен MiniMax Music 3. Берет повреждённую музыку и восстанавливает чистую версию, сохраняя исполнение, тайминг, вокал и аранжировку - Восстанавливает испорченные треки: шум, сжатие битрейта, обрезка, редуцированный bandwidth - 137M (0.1B) - Окно: 30 секунд (обучен на 30-сек окнах, вывод по умолчанию с перекрытием) #audiorestotation #music2music VK | MAX

MiniMax выпустил открытую модель генерации музыки с вокалом Music 3

MiniMax опубликовал веса Music 3 — open-source модель, которая по текстовому промпту создаёт полноценные песни с вокалом, инструментами и структурой (куплет-припев) за один проход, длительностью до 5 минут (по данным одного источника — до 10 минут). Модель уже интегрирована в ComfyUIi, HuggingFace Diffusers и SGLang, работает локально и не требует топового железа.

В отличие от типичных audio-token генераторов, MiniMax использует гибридную архитектуру из двух LLM плюс модуль Flow Matching и Flow-VAEi, что даёт более гибкий контроль над структурой трека, вокалом и аранжировкой через отдельные seed и CFG для разных уровней генерации.

24 GBминимум VRAM для полной точности
8Bразмер Global LLM (Qwen3-8B)
32 kHzчастота дискретизации выходного аудио

Полный разбор →

Alibaba представила HappyShrimp 1.0 для генерации песен

М@cgeventAI-инженер
2 мес

Обзор обновлений в генеративном аудио и видео: MiniMax, Suno, Pika, Sand AI и Lightricks

Б@boris_againAI-инженер
2 мес
Ещё ↓