Создание анимационного ролика с помощью нейросетей: опыт и пайплайн
М@cgeventAI-инженер
2 мес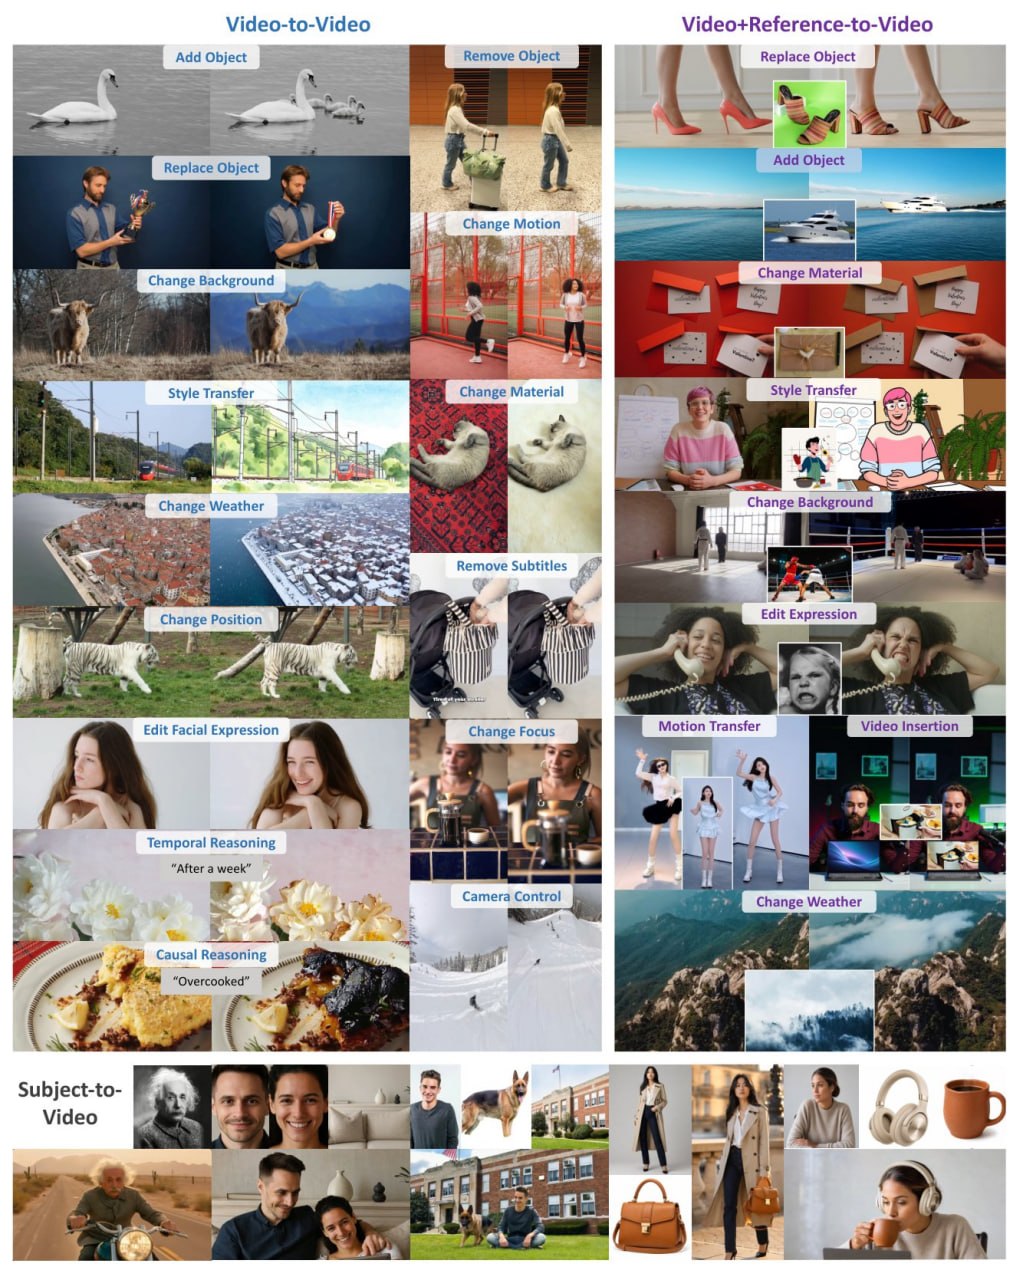
31 июля 2026 года ByteDance официально запустила Seedance 2.5 — новую версию своей модели генерации видео, впервые показавшую себя в закрытом доступе (CPPi) двумя днями ранее. Модель доступна в Dreamina (глобально), Jimeng AI и Doubao Pro (Китай), позже подключились агрегаторы Runway, KIE, WaveSpeed, Atlas Cloud и fal — хотя полноценный публичный API BytePlus ModelArk на момент запуска ещё не открыли.
Ключевое обновление — рост длины ролика с 15 до 30 секунд одним непрерывным проходом (без склейки из коротких кусков), до 50 мультимодальных референсов (30 изображений, 10 видео, 10 аудио), точечное редактирование по таймкодам без перегенерации всего клипа, а также бета-режим генерации до 180 секунд. Отдельный акцент сделан на профессиональные пайплайны: поддержку 3D-болванок (white models), clay-рендерiов, гринскрина и грядущие плагины для Blender и Maya — это превращает Seedance в инструмент для «виртуальных съёмок», а не просто генератор роликов.
Компания LTX внезапно анонсировала и в тот же день (веса — в 21:00 по Москве) выпустила обновление своего видеогенератора — LTX-2.5i, открытую 22B video/audio world model. Релиз позиционируется как ответ конкурентам (в частности MiniMax H3): модель полностью open weights, работает локально от 16 GB VRAM, поддерживает ComfyUIi с первого дня и бесплатна для использования при ARRi до $10 млн.
Главные заявленные фишки — нативное 4K HDR видео, RAW workflow, точное редактирование существующего видео и native multishot: генерация нескольких связанных кадров одной последовательностью с сохранением персонажа, окружения, света и голоса между склейками. LTX также опубликовал сравнительную таблицу с MiniMax H3, Seedance 2.5, Kling, Veo и Grok, где выигрывает у всех — но на Reddit эти цифры уже назвали нечестными («pathetic bullshit»), так как сравнивались разные режимы, железо и условия.
Alibaba запустила публичную бету новой модели генерации видео Wan 3.0. Модель умеет создавать ролики со звуком длительностью до 30 секунд в разрешениях 480p, 720p и 1080p, лучше сохраняет персонажей и сцену на длинной дистанции и поддерживает «омни-референсi» — на вход можно подавать не только текст и изображения, но и аудио, видео, документы и веб-страницы.
Это важно, потому что Wan 3.0 заметно расширяет возможности AI-видео: помимо обычного text-to-video и image-to-video, модель может продолжать уже готовый ролик, автоматически подбирать длительность и переносить в результат конкретные атрибуты — лицо, голос, одежду, логотипы, стиль — из референсных материалов, включая офисные файлы и презентации.
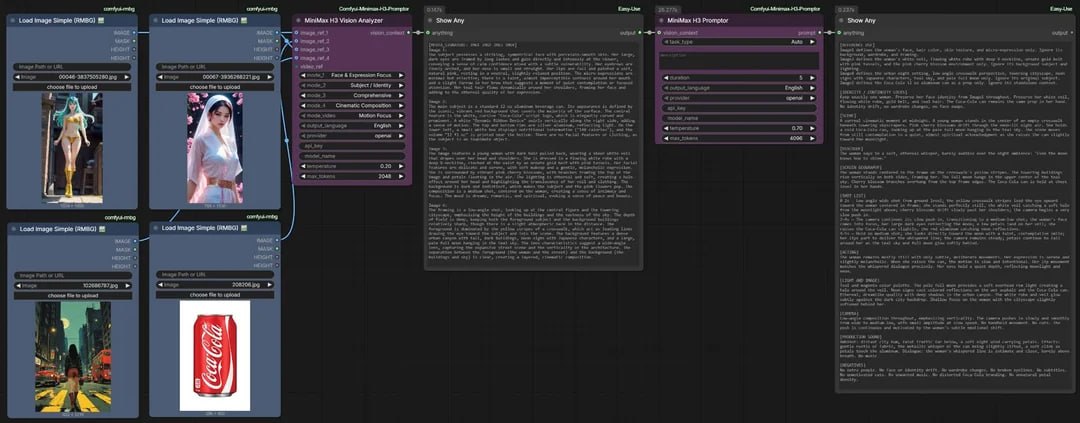
Шанхайский стартап MiniMax представил новое поколение видеогенератора Hailuo — H3, объединяющее в одной модели генерацию видео и звука, редактирование и режиссуру сцен. Модель официально запущена 31 июля 2026 года, а в течение недели компания действительно опубликовала веса на Hugging Face, чем удивила рынок: до этого лидерами открытого видео были в основном LTX и Wan.
H3 генерирует ролики длиной от 4-5 до 15 секунд в 2K с нативным стереозвуком, поддерживает мультимодальные референсы (изображения, видео, аудио), перенос движения и редактирование готового видео текстовыми командами. По заявлениям MiniMax, себестоимость генерации втрое ниже конкурентов от ByteDance (Seedance) и Kuaishou, а по рейтингу Artificial Analysis модель заняла 1-е место в редактировании видео, 2-е — в text-to-video и 3-е — в image-to-video.