vlmСбросить фильтр ×

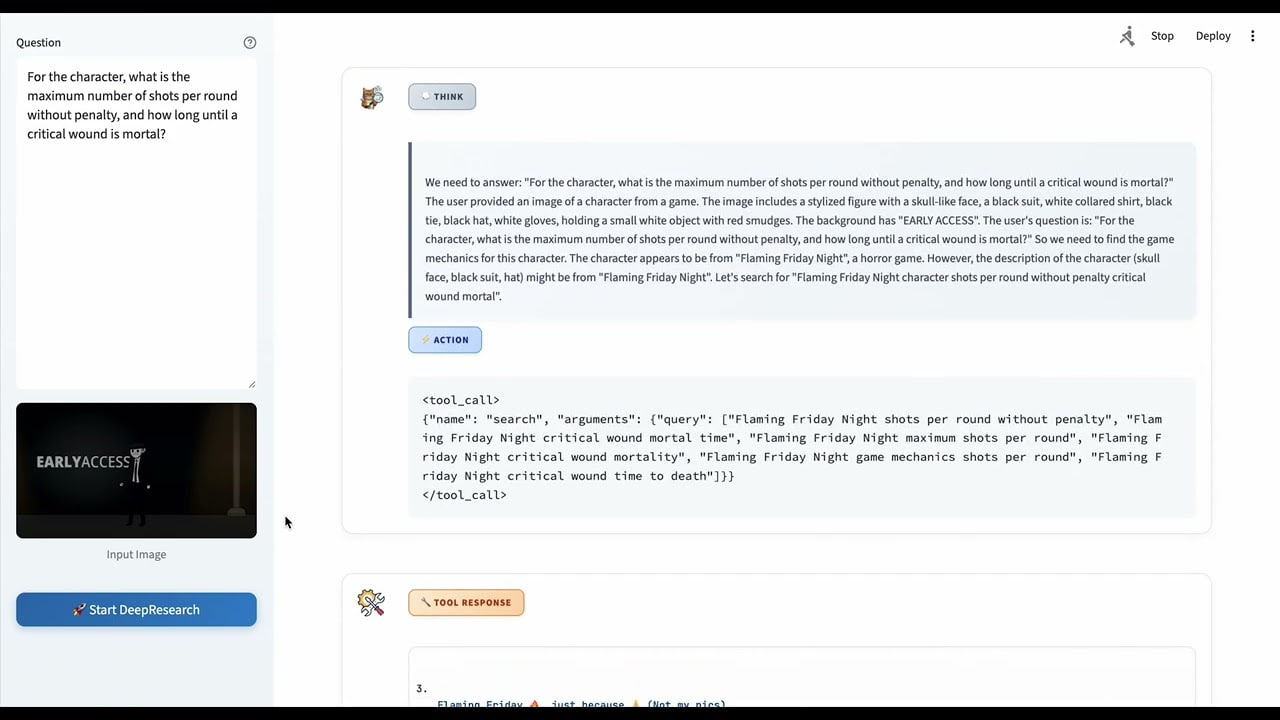
Video-DeepResearch: новый подход к мультимодальным агентам

Н@GreenNeuralRobotsAI-инженер
2 мес
Video-DeepResearch: новый подход к мультимодальным агентам

OpenMOSS представила MOSS-VL-Realtime

Н@GreenNeuralRobotsAI-инженер
2 мес
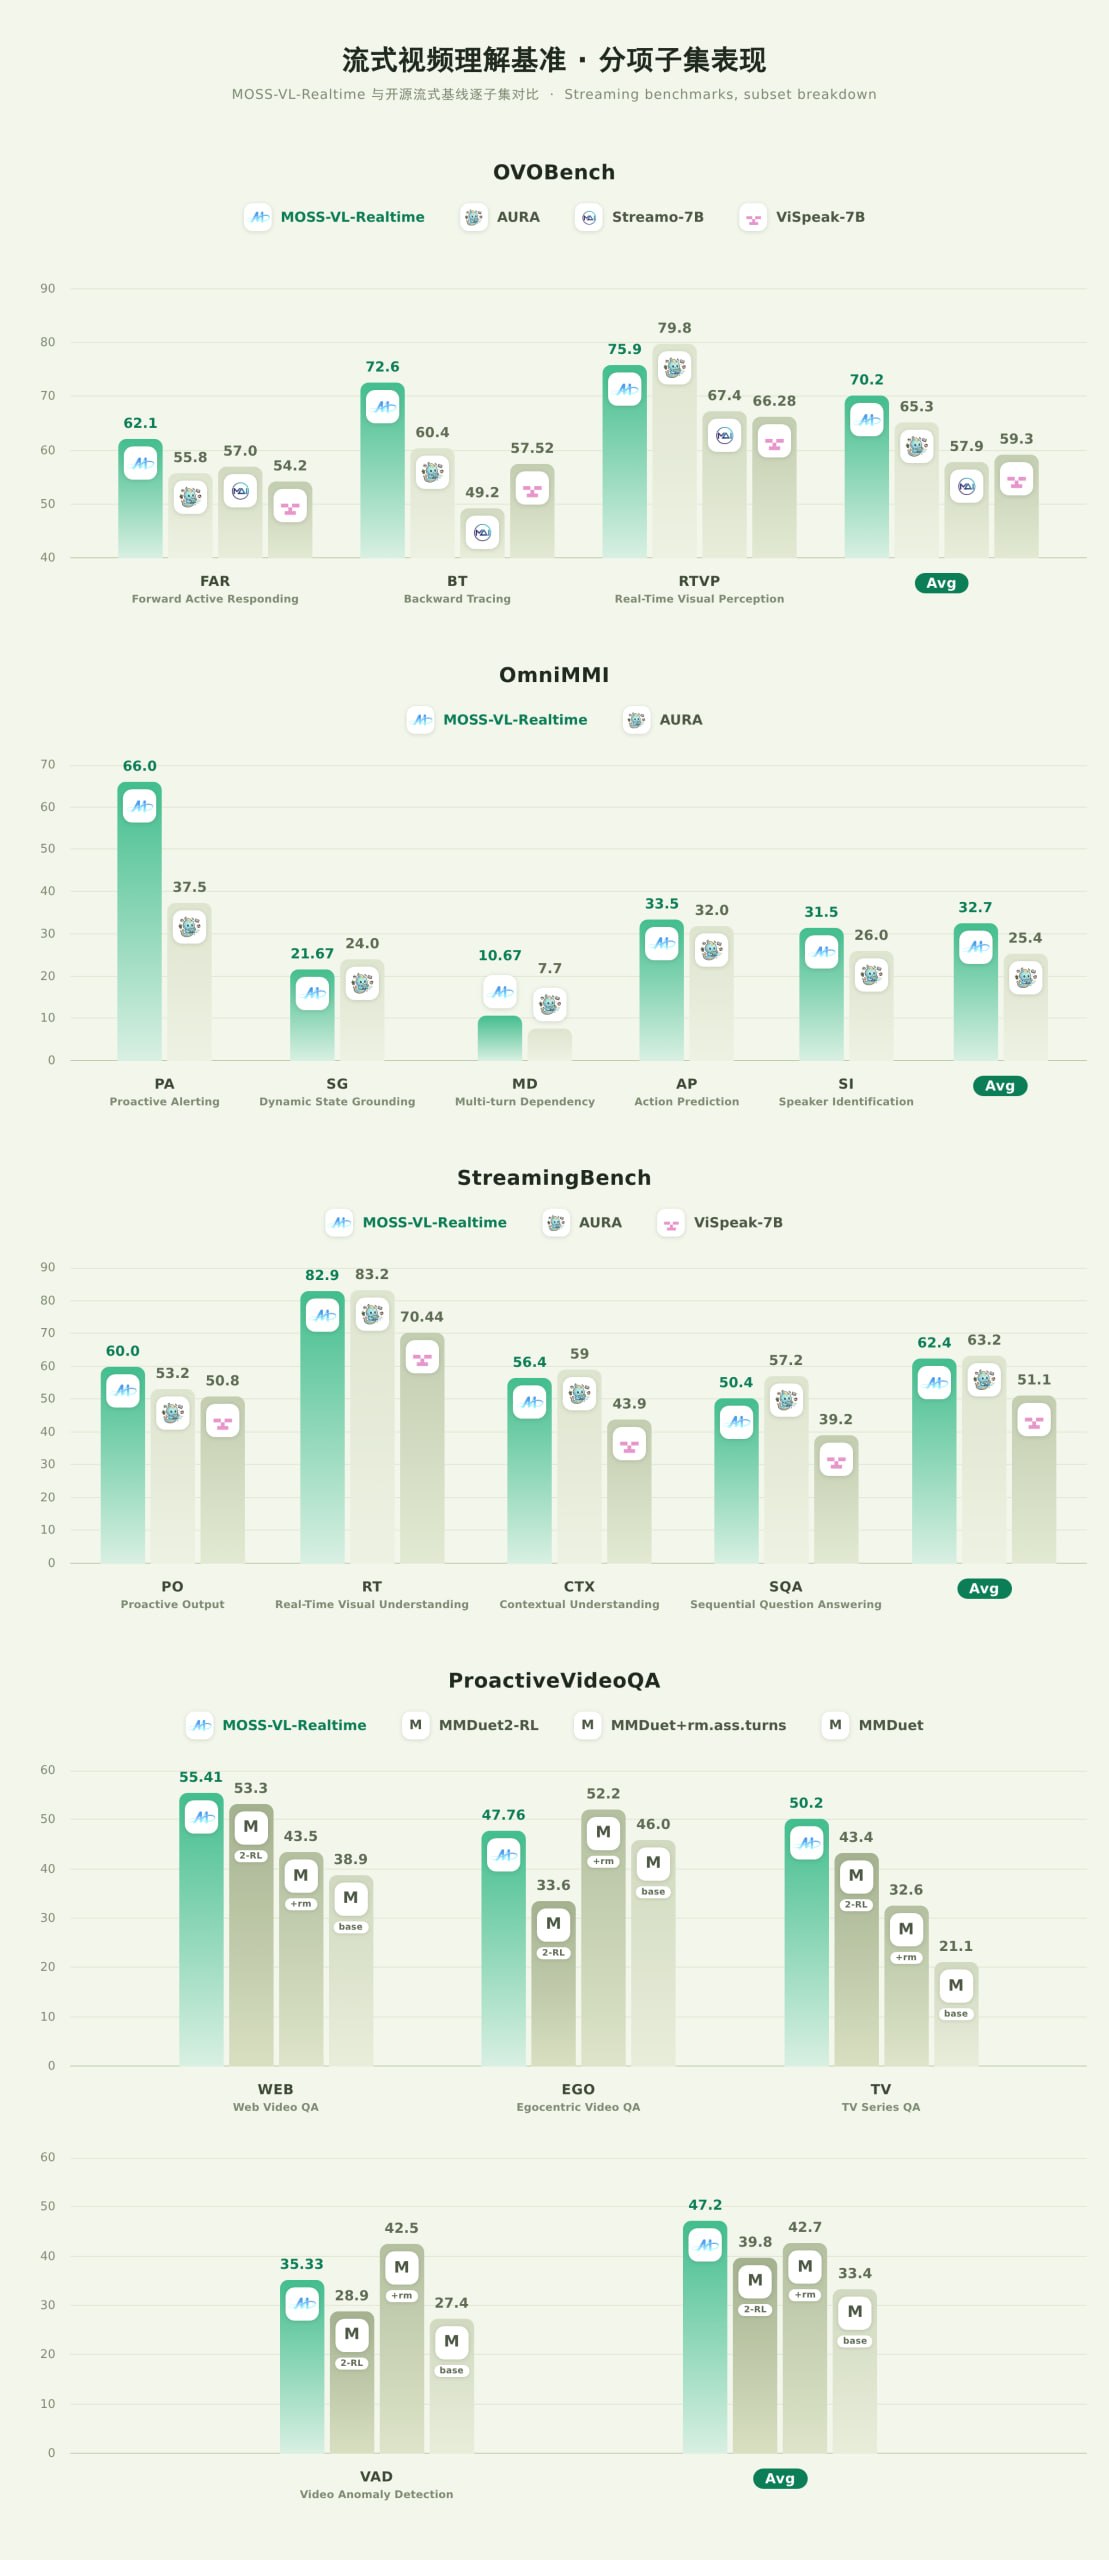
MOSS-VL-Realtime Потоковая видеоязыковая модель от OpenMOSS на 11B параметров, понимает видео в реальном времени • обработка кадров с привязкой к таймстампам • прерываемое взаимодействие в потоке • динамическая коррекция ответов по новым кадрам • режим проактивной тишины при отсутствии событий • контекстное окно 256K • работа с потоковым видео без ожидания конца Демо Демо2 #streaming #vlm #qa #realtime
OpenMOSS представила MOSS-VL-Realtime

Инструмент для анализа видео с помощью Claude

Н@GreenNeuralRobotsAI-инженер
3 мес
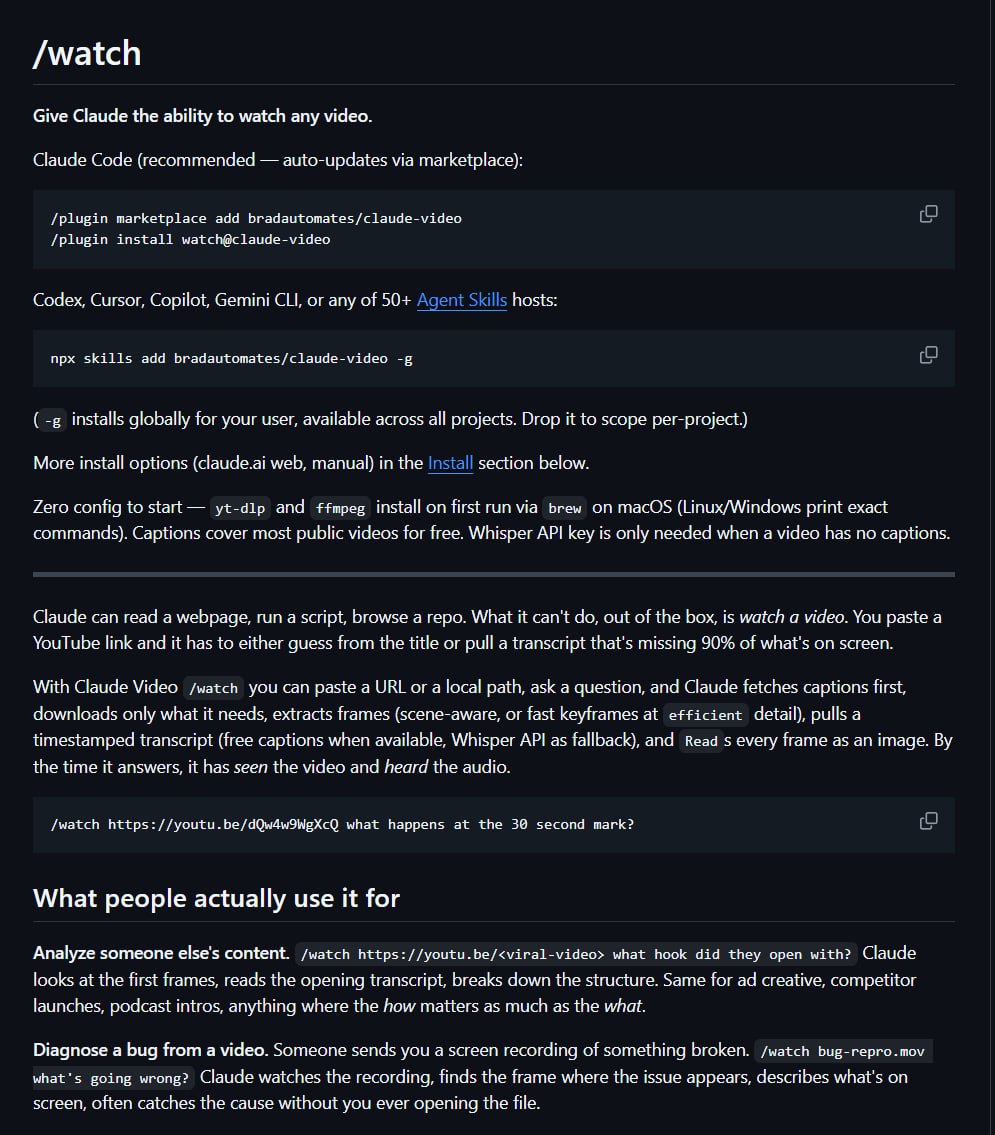
watch Скилл понимания видео для Claude • анализ хуков, визуала и структуры роликов • поиск багов по записи экрана • резюме выступлений с таймкодами • выделение реальных изменений из продуктового видео • поддержка YouTube, Loom, TikTok, локальных файлов • работает через yt-dlp и ffmpeg • кадры по смене сцен, без дублей • транскрипция через Groq Whisper при отсутствии субтитров • экономия токенов за счёт точечного отбора кадров • синхронная связка "кадр + речь" для точного анализа #skill #vlm #video2text
Инструмент для анализа видео с помощью Claude

Релиз мультимодальной модели GLM-5.2-Vision-NVFP4

Н@GreenNeuralRobotsAI-инженер
3 мес
GLM-5.2-Vision-NVFP4 Версия GLM-5.2 с видением тянет текст и картинки, отвечает на вопросы, описывает, руссуждает по изображениям Прикрутили визуальный энкодер MoonViT от Kimi-K2.6 • работа с высоким разрешением без сильного падения скорости • оптимизация под NVFP4 • мультимодальные эмбеддинги, лучше стыкует текст и визуал • до 4096 токенов на картинку, контекст 1М #vlm #nfvp4 #vqa #qa

TimeLens2: поиск моментов в видео по текстовому запросу

Н@GreenNeuralRobotsAI-инженер
3 мес
TimeLens2 Модель для поиска моментов в видео по текстовому запросу. Превращает видеопоток в постоянную визуальную память с привязкой к сущностям. По запросу на естественном языке выдаст интервалы на временной шкале • обрабатывает однократные и повторяющиеся события • работает с видео от третьего лица и эгоцентрическими • выдаёт один или несколько временных интервалов • использует мультимодальные LLM • есть несколько версий модели: TimeLens2-4B и TimeLens2-8B Гитхаб HF Демо #vlm #captioning #video2text #mllm

IGGT4D: онлайн-понимание 4D-сцен в видеопотоке

Н@GreenNeuralRobotsAI-инженер
3 мес
IGGT4D Онлайн-понимание 4D-сцен в видеопотоке. Строит единую модель сцены на лету - геометрия, движение камеры, объекты. • сегментирование и олтслеживание объектов, глубина • обрабатывает кадры по очереди • переиспользует прошлый контекст через causal spatial-temporal modeling. Всю историю не хранит для экономии памяти • обновляет представление сцены инкрементально • чётко выделяет отдельные объекты. код / веса ждем #vlm #tracking #segmentation #videoto4d #vidfeo2depth

Самые сложные темы в изучении Deep Learning и LLM

Т@tech_priestessAI-инженер
3 мес
А поделитесь, какая тема была для вас самой сложной при изучении глубокого обучения и особенно LLM/VLM/etc? В чем оказалось сложнее всего разобраться?

Google DeepMind представили GenCeption

Н@GreenNeuralRobotsAI-инженер
3 мес
GenCeption от Google DeepMind Единая feed-forward модель мультизадачного зрения. Заменяет зоопарк специализированных моделей • оценка глубины, нормалей поверхности, позы камеры • сегментация, 2D/3D ключевые точки • работа с плотными и разреженными задачами Обучена на синтетических видео, работает на реальных данных. Использует замороженную диффузионную text-to-video основу плюс лёгкие задачи-специфичные головы Код/веса ждем #vlm #video2depth #video2normals #tracking #video2camera #video2pose

UniVR: Единый подход к визуальным рассуждениям

Н@GreenNeuralRobotsAI-инженер
3 мес
UniVR: Thinking in Visual Space for Unified Visual Reasoning Визуальное мышление и рассуждения в одной модели. Единый подход к разным визуальным задачам от понимания сцены до планирования действий • работа с пространственными отношениями в кадре • мультимодальное рассуждение на базе визуальных данных • интеграция низкоуровневых признаков и высокоуровневой семантики Гитхаб ждем #vlm

PadCaptioner: эффективная модель для описания видео

Н@GreenNeuralRobotsAI-инженер
3 мес
https://github.com/showlab/PadCaptioner Модель для создания подробных описаний видео с помощью мультимодальных данных. Работает эффективнее больших аналогов, при этом точнее описывает события. учитывает слабые локальные зависимости между событиями в видео, что позволяет генерировать описания параллельно без потери качества. Превосходит 7B аналоги по эффективности. Гитхаб ждем #captioning #vlm #video2text

SenseNova-Vision: мультимодальная модель для компьютерного зрения

Н@GreenNeuralRobotsAI-инженер
3 мес
SenseNova‑Vision Мультимодальная генеративная модель для компьютерного зрения (7B, MoT) • решает сразу несколько задач без отдельных голов под каждую: детекция, OCR, сегментация, ключевые точки, нормали, глубина, поза камеры • принимает инструкции на естественном языке • генерирует текст, изображения или смешанные выходы • единый подход вместо набора узкоспециализированных моделей Гитхаб HF Демо #vlm #multimodal #t2i #i2t #detection #segmentation #image2depth #image2normals

Hugging Face и Cerebras представили опенсорсного голосового агента

Н@GreenNeuralRobotsAI-инженер
3 мес
real-time voice AI Hugging Face и Cerebras собрали пример опенсорсного голосового диалогового агента в рилтайме • Gemma 4 VLM на Cerebras — быстрый инференс • Parakeet (Nvidia) — распознавание речи • Qwen3TTS (Alibaba) — синтез голоса • задержка минимальна, отклик почти мгновенный Работает в роботах Reachy Mini (свыше 9000 устройств) Гитхаб Демо #realtime #dialog #voicemode #vlm #multimodal #interactive #tts #stt #duplex

ShutterMuse: ассистент фотографа на базе Qwen3-VL-8B-Instruct

Н@GreenNeuralRobotsAI-инженер
3 мес
ShutterMuse Ассистент фотографа на базе Qwen3-VL-8B-Instruct MLLM для подсказок по съёмке в реальном времени. Помогает оценивать кадры и ставить позы. • советы держать, дорабатывать или отбрасывать снимок • рамки композиции поверх кадра • рекомендации поз для портретов Гитхаб HF - 18 ГБ - на чем это должно работать, с камерой, клавиатурой, в рилтайме? #vlm #assistant

SpatialClaw: фреймворк NVIDIA для пространственного рассуждения VLM

Н@GreenNeuralRobotsAI-инженер
3 мес

RPC-Bench: новый бенчмарк для оценки LLM и VLM на научных статьях

3 мес

Это всё на сейчас.