квантованиеСбросить фильтр ×

Локальный инференс LLM: почему обещания «запустить триллионы параметров на слабом GPU» не работают

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 2 мес назад

Авторы каналов «Data, Stories and Languages» и «Сиолошная» разобрали популярные советы по запуску больших языковых моделей на локальном железе и показали, что все предлагаемые методы имеют серьёзные ограничения. Квантизацияi моделей до 1b заметно ухудшает качество, а использование более мелких моделей само по себе снижает результат.

Особое внимание уделено «хитрому стримингу» — методу, который якобы позволяет запускать гигантские модели на слабых видеокартах. На практике такой подход оказывается неюзабельным из-за экстремально низкой скорости.

2.8 триллионазаявленное число параметров модели Kimi K3
4GBобъём памяти GPU в заявлении
пять минут на токенреальная скорость инференса

Полный разбор →

Методика оценки качества квантованных моделей

T@extremecodeAI-инженер
2 мес
Методика оценки качества квантованных моделей

Вопрос о целесообразности использования LLM-as-a-judge для оценки квантованных моделей

T@extremecodeAI-инженер
3 мес
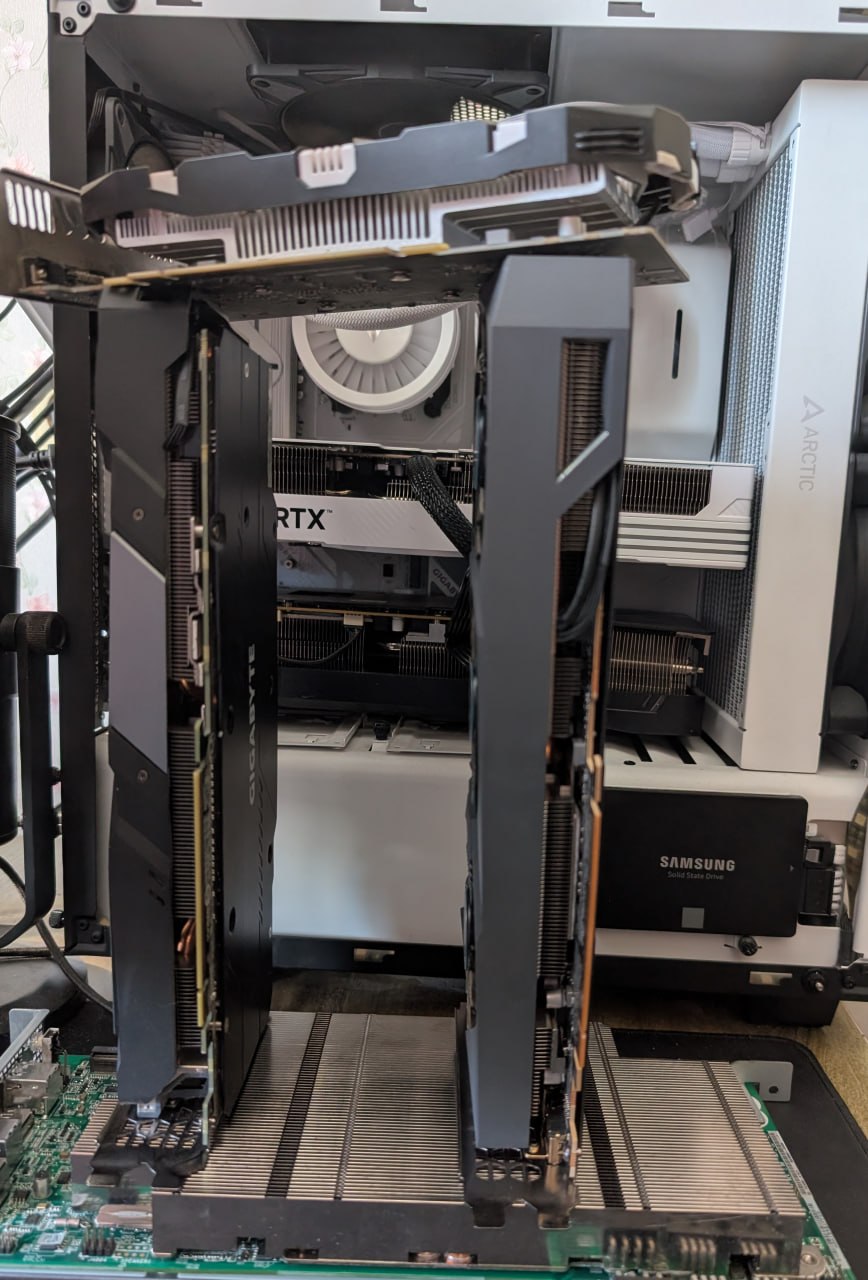
Шел 3814-ый день погружения в локальный нейрослоп. Одебилел окончательно, начал строить домики из видеокарт, до самих бенчмарков пока не добрался. Эксперты из каментов, стоит ли помимо перплексии делать простой тест на задачках из своего датасета в формате "llm as a judge"? Ну типа, я думаю нахрена на это время тратить, если разница в качестве между одной и той же квантованной моделью будет не такая сильная. Вот между Q8 и Q4 есть видимая разница. А вот между различными версиями Q4 хз как проверять. Короче, сложна.
Вопрос о целесообразности использования LLM-as-a-judge для оценки квантованных моделей

Gemma 4 31B и gpt-oss-120B на чипах Cerebras вышли на фронтир скорости LLM-бенчмарка

Автор канала @llm_under_hood (по совету @AigizK) протестировал модель Gemma 4 31B, запущенную на специализированных чипах Cerebrasi, на агентском бенчмарке под бизнес-задачи. С выключенным reasoning (он тормозит и спотыкается о structured outputs) модель сдвинула фронтир скорости бенчмарка и оказалась совсем рядом с GPT-5.4 mini по качеству и цене — при этом её, в отличие от закрытой GPT-5.4 mini, можно скачать и запускать локально.

Через два дня выяснилось, что эффект не ограничивается одной моделью: запуск gpt-oss-120B на том же железе Cerebras во всех трёх режимах reasoning (high, medium, low) тоже выводит её на speed frontier, а medium-режим дополнительно попадает на cost-фронтир по эффективности. Вывод автора — дело не столько в конкретной модели, сколько в самом железе Cerebras, которое команды уже используют для near-realtime AI-решений.

ВыводCerebras выпускает wafer-scale engines — чипы, которые примерно в 50 раз крупнее самых больших GPU, что делает железо дорогим и специализированным, но позволяет запускать небольшие модели на очень высоких скоростях

31Bразмер параметров Gemma 4
120Bразмер параметров gpt-oss
50во сколько раз чип Cerebras крупнее GPU

Полный разбор →

Обзор фреймворка Humming от InclusionAI

К@quant_prune_distillAI-инженер
3 мес

Bonsai: запуск 1-битной модели Qwen 27B на iPhone

N@neurohiveAI-инженер
3 мес

Влияние квантования на логические способности моделей

К@quant_prune_distillAI-инженер
3 мес
Extreme Low-Bit Inference in Reasoning Models: Failure Modes and Targeted Recovery 📄 Статья 💻 Код Вдогонку про влияние квантизации на ризонинг. Ребята из Brain Lab выпустили интересное исследование, показывающее, как ломается ризонинг у квантизованных моделей, а также пару стратегий, помогающих предотвратить зацикливание генерации.

Использование FP4 квантования в продакшене

L@lovedeathtransformersAI-инженер
3 мес
Годный блогпостик про использование FP4 квантизации в проде от провайдера Spheron. В частности, оценивается стоимость инференса при аренде конкретной GPU с учетом максимально достижимого throughput при использовании данного типа данных, а также вопросы качества и доступности в инференсных фреймворках.

PrismML выпустила Bonsai 27B — локальную LLM на 27 млрд параметров, работающую на iPhone

Стартап PrismML представил Bonsai 27B — мультимодальную языковую модель на базе Qwen3.6-27B, сжатую до размера, который помещается на смартфон. Обычно модель такого масштаба в 16-битном виде занимает около 54 ГБ, а даже после 4-битного квантования — порядка 18 ГБ, что всё равно не влезает на телефон. PrismML использовала технику Quantization-Aware Trainingi (QAT), при которой веса заранее обучаются адаптироваться к дискретным значениям, а не просто округляются постфактум — это позволило сжать модель в 9–14 раз при потере лишь 5–11% качества.

Вышло две версии: 1-битная на 3,9 ГБ (около 90% качества оригинала) и тернарнаяi (веса −1, 0, +1) на 5,9 ГБ (до 95% качества). Обе поддерживают мультимодальность, рассуждения, кодинг, вызов инструментов (tool calling) и агентные сценарии — то есть это не просто чат-бот, а основа для локальных ИИ-агентов на устройстве.

27Bпараметров в модели Bonsai
3,9 ГБразмер 1-битной версии
5,9 ГБразмер тернарной версии, 95% качества

Полный разбор →

Проблема утечки данных в тестах квантованных моделей

T@extremecodeAI-инженер
3 мес

Как измерить «отупение» модели после квантования — вопрос без ответа

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 3 мес назад

Автор канала The ExtremeCode Times поднял проблему: стандартные метрики (perplexityi, MMLUi) показывают лишь небольшую просадку у квантованных моделей по сравнению с оригинальными весами, но это плохо соотносится с реальным ощущением деградации при ручном тестировании. Методика, которая работает для выбора лучшей модели среди нескольких кандидатов (прогнать через бенчмарк и взять максимум баллов), не подходит для оценки, насколько именно «поглупела» модель после квантования.

Полный разбор →

Методы эффективного сжатия LLM для запуска на мобильных устройствах

К@quant_prune_distillAI-инженер
3 мес

OrbitQuant: метод калибровки без данных для квантования диффузионных моделей

Н@GreenNeuralRobotsAI-инженер
3 мес
OrbitQuant метод калибровки без данных (calibration‑free) для посттренировочной квантизации (PTQ) диффузионных генераторов изображений и видео • новая #SOTA на FLUX.1, Wan 2.1 и CogVideoX при W4A4 (4 бита для весов, 4 бита для активаций) • рабочие изображения на W2A4, где старые методы ломаются Код / веса не выложили пока #optimization #t2i #t2v #flux #wan21 #zimage

GitHub добавил поиск моделей по совместимости с железом

т@techn0danyaAI-инженер
3 мес
🤗 Ну на конец-то! Возможно вы об этом никогда не просили, но я очень доволен. На светлоликом гитхабе добавили функцию поиска моделей совместимых с вашими железками. Было бы круто еще перформанс заранее знать, но это уже сэкономит мне кучу времени на гугление нужного квантования и размера #AI @techn0danya

Это всё на сейчас.