синтез речиСбросить фильтр ×

Tencent представила Hy-SimulMT для синхронного перевода речи

Н@GreenNeuralRobotsAI-инженер
вчера

Mistral представила Voxtral 3 — стек для голосовых ИИ-агентов

Mistral представила Voxtral 3 — набор голосовых моделей и инструментов, который объединяет распознавание речи, обработку диалога и синтез ответа. На его основе можно создавать агентов для звонков, взаимодействия с собственными системами и выполнения задач.

Система поддерживает распознавание более чем на 50 языках и синтез речи с настройкой звучания. Её можно использовать через API или развернуть на своей инфраструктуре.

$0,0035/минраспознавание через API
$13 за миллион символовгенерация речи
$0.04 в минутуработа агента по API

Полный разбор →

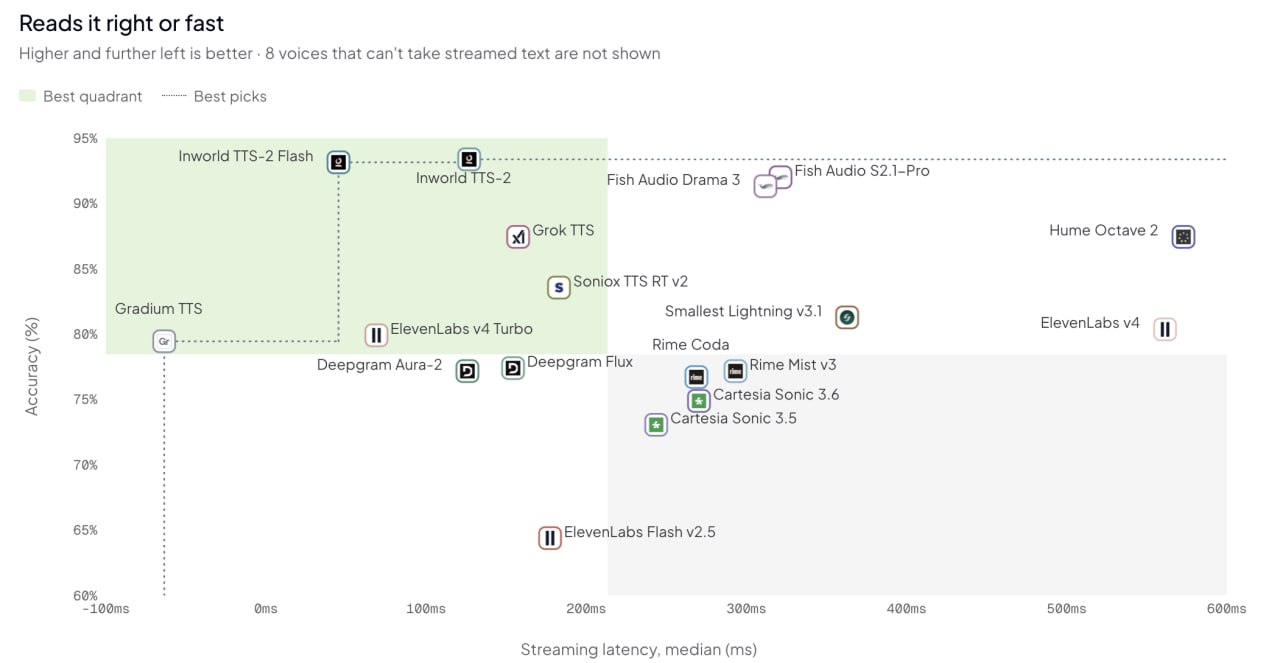
Бенчмарк Cekura сравнил 26 моделей TTS для голосовых агентов

A@ai_productAI-инженер
1 нед
Бенчмарк Cekura сравнил 26 моделей TTS для голосовых агентов

Автор перешёл на Gemini 3.8 Flash TTS для озвучки постов

Т@CommonsTragedyAI-инженер
1 нед
Автор перешёл на Gemini 3.8 Flash TTS для озвучки постов

Модель странно произносит английские слова в русском тексте

Т@CommonsTragedyAI-инженер
1 нед
В первой дорожке забавный косяк есть. Модель без всякой настройки умеет на нужном языке читать. Но когда в полностью ру тексте есть вкрапления английского, она их читает как учитель английского из советского союза 😂 При том что прекрасно умеет с нэйтив акцентом говорить.

Fish Audio открыла веса речевой модели Drama 3

Fish Audio опубликовала веса Drama 3 — модели синтеза речи для дубляжа, аудиокниг и озвучки игр. Она поддерживает 83 языка, включая русский, и позволяет управлять подачей речи текстовыми указаниями; модель можно запускать локально.

В тесте Artificial Analysis Drama 3 показала 93,2% точности при чтении дат и контекстно-зависимых слов, обойдя S2.1 Pro. По другим сообщениям, она также превзошла ElevenLabs по точности произношения.

93,2%точность чтения дат и слов
35 млрд / 3 млрдобщие и активные параметры
48 ГБ VRAMзаявлено для локального запуска

Полный разбор →

Обзор инструментов для синтеза и распознавания речи: RUVoice, Pocket-TTS и новые бенчмарки

Н@GreenNeuralRobotsAI-инженер
2 нед
Обзор инструментов для синтеза и распознавания речи: RUVoice, Pocket-TTS и новые бенчмарки

Black Forest Labs выпустила FLUX 3 Image — единую модель генерации и редактирования изображений

Black Forest Labs представила FLUX 3 Image — модель, объединяющую генерацию и редактирование изображений в одном эндпоинте, без необходимости переключать режимы. Главные новшества: разметка объектов с помощью bounding boxesi для точечного локального редактирования, нативный рендер до 16 МП (против ~4 МП у FLUX.2) и встроенный веб-поиск для сверки визуальных деталей перед генерацией.

Модель уже доступна через API BFL, а также на Replicate, OpenRouter и Krea, коммерческие веса открыты для развёртывания на своей инфраструктуре, а открытые веса обещают «в ближайшие недели».

16 MPмаксимальное разрешение нативного рендера FLUX 3
10 референсовмаксимум изображений-референсов за запрос
$0.607цена генерации одного 4K-изображения

Полный разбор →

Обзор новых моделей и инструментов для TTS и ASR

Н@GreenNeuralRobotsAI-инженер
3 нед

ElevenLabs выпустила Eleven v4 и v4 Turbo — новую архитектуру синтеза речи

ElevenLabs представила две новые модели text-to-speech — Eleven v4 (максимально выразительная озвучка) и Eleven v4 Turbo (для реалтайм-агентов). Компания перешла на полностью новую архитектуру: модель читает сценарий «как актёр озвучки» — понимает, кто говорит, что только что произошло по сюжету и с какой интонацией подать реплику. Число поддерживаемых языков выросло с 70+ (в v3) до 90+, включая русский.

Релиз сразу вывел ElevenLabs на первое место в рейтинге Provider Voice Arenai от Artificial Analysis, обогнав Cartesia Sonic 3.6 и Gemini 3.8 Flash TTS. Для бизнеса это значит: качественнее аудиокниги, реклама и брендовые голоса, но по цене выше многих конкурентов — юнит-экономику для колл-центров на миллионы минут стоит считать отдельно.

1319Elo Eleven v4 в Provider Voice Arena
$80цена за 1 млн символов
90+поддерживаемых языков

Полный разбор →

Голос Льва Толстого добавлен в Алиса AI и Яндекс Станции

B@biggeekавтор про «tech»
1 мес
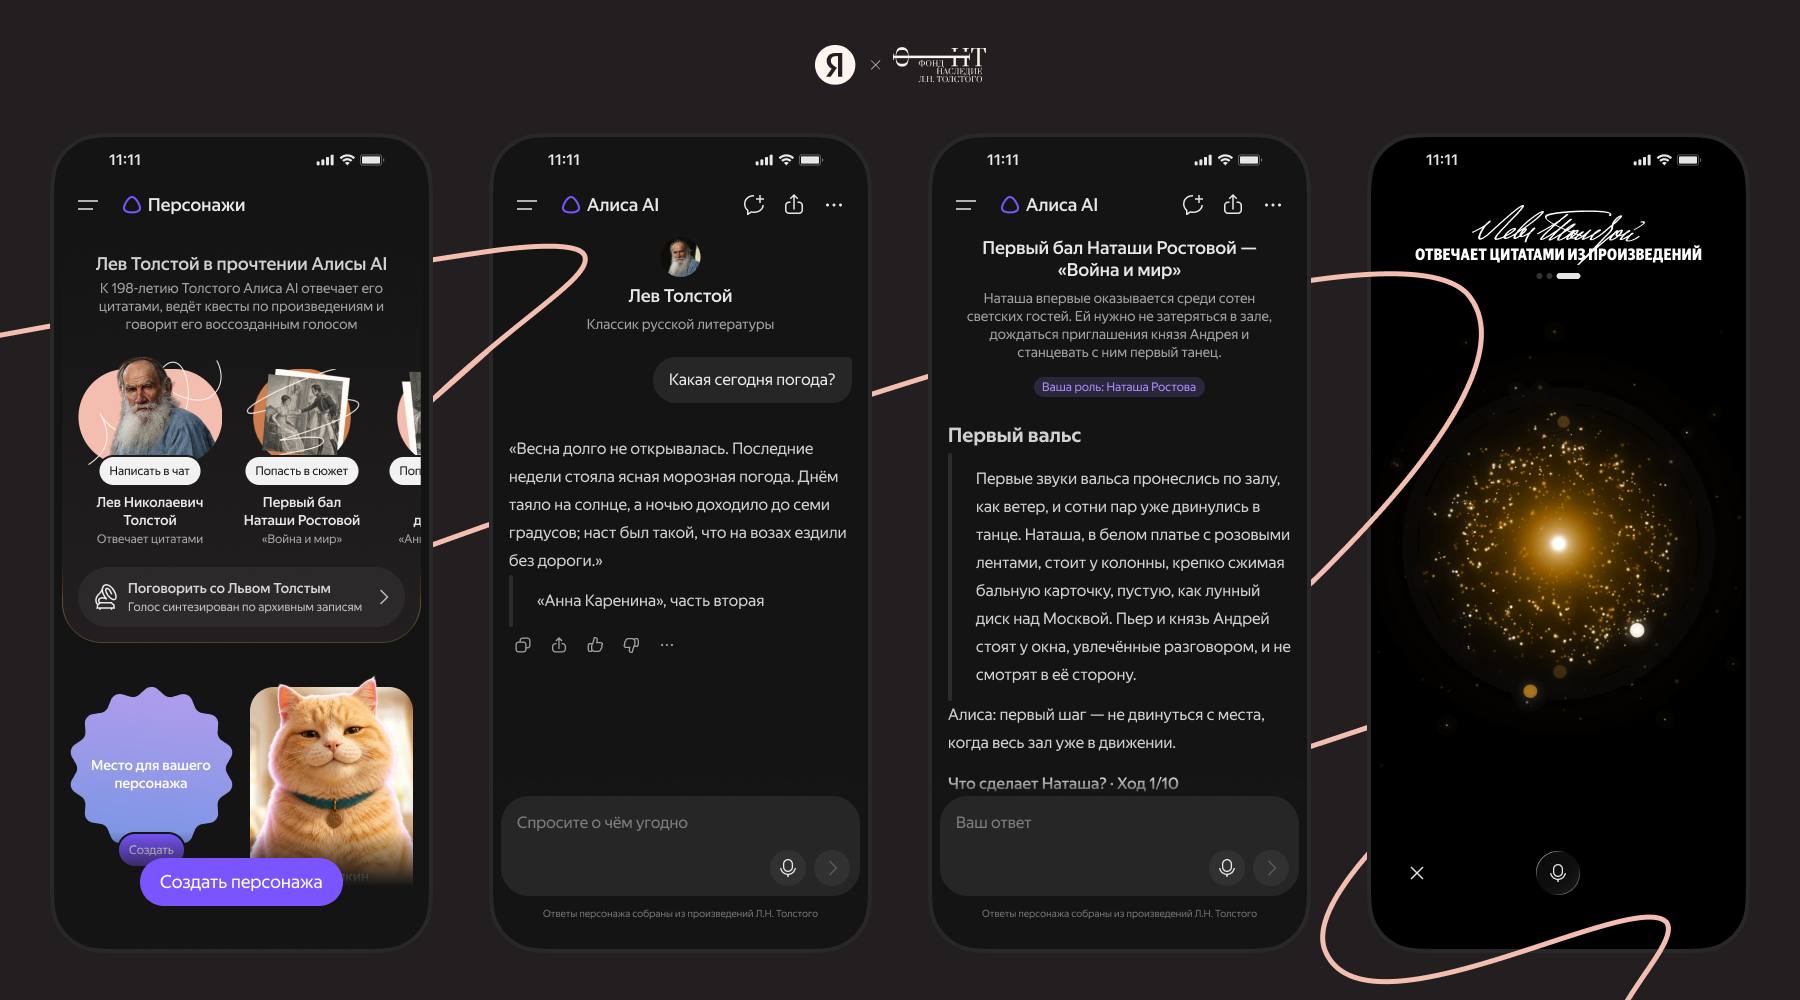
Голос Льва Толстого добавлен в Алиса AI и Яндекс Станции

Релиз pocket-tts-ru: легкий синтезатор речи с клонированием голоса

Н@GreenNeuralRobotsAI-инженер
1 мес
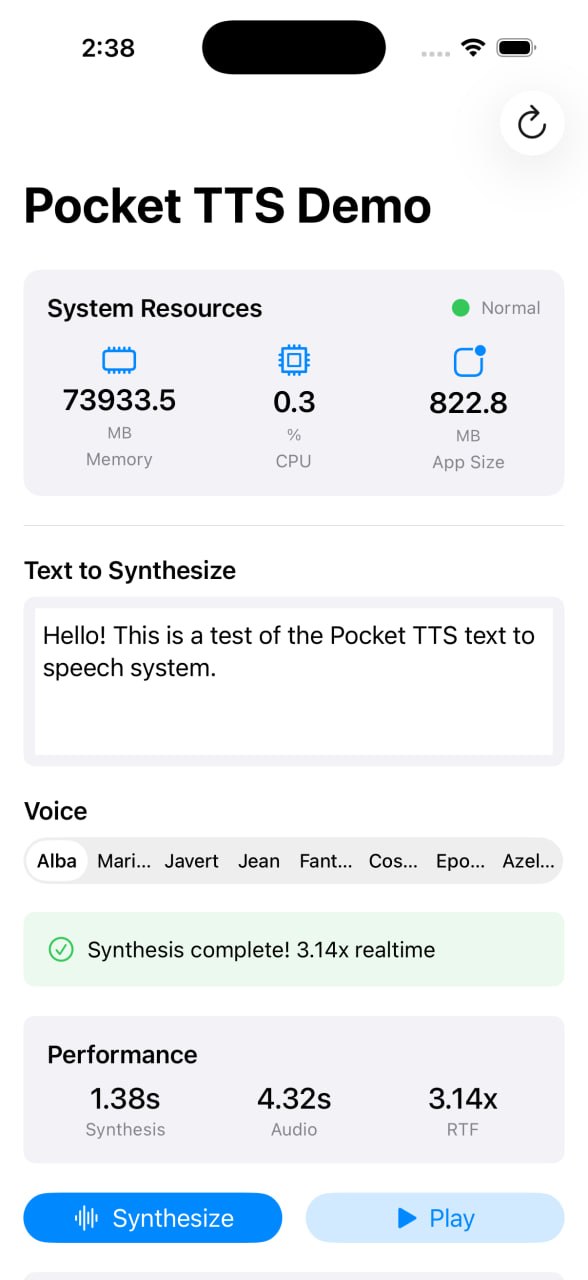
Релиз pocket-tts-ru: легкий синтезатор речи с клонированием голоса

Выпуск TeraTTSv2: локальный движок синтеза речи

Н@GreenNeuralRobotsAI-инженер
2 мес

Автоматизация создания видео-туториалов: локальный стек и лицензионные нюансы

A@qachanellавтор про «it»
2 мес

Открытый корпус выразительной русской речи Dialogs принят на Interspeech 2026

Илья Латышев и Борис (автор канала «Борис опять») подготовили статью «Dialogs: a studio-quality expressive conversational Russian speech corpus for dialog assistants», которую приняли на конференцию Interspeech 2026i. В основе статьи — открытый студийный корпус выразительной русской разговорной речи объёмом 20 часов, записанный тремя профессиональными актёрами театра с разметкой эмоций.

Особенность корпуса — актёры записывали диалоги, сидя друг напротив друга и видя мимику и жесты партнёра, хотя текст реплик был заранее подготовлен (scriptedi). Такой подход сделал речь заметно более естественной и эмоциональной по сравнению с записью дикторов по одному. Корпус предназначен в первую очередь для файнтюна моделей синтеза речи (TTSi) и распространяется по открытой лицензии для исследований.

20 часовобъём записанного корпуса
3профессиональных диктора-актёра

Полный разбор →

Статья о русском речевом корпусе Dialogs принята на Interspeech 2026

Команда с Ильёй Латышевым подготовила статью «Dialogs: a studio-quality expressive conversational Russian speech corpus for dialog assistants», которую приняли на конференцию Interspeech 2026i. В статье представлен открытый студийный корпусi выразительной русской разговорной речи, предназначенный в первую очередь для файнтюнiа моделей синтеза речи.

Особенность корпуса — способ записи диалогов: два актёра театра сидели друг напротив друга и читали заранее подготовленные реплики, видя мимику, жесты и эмоциональную реакцию собеседника, что сделало речь заметно более естественной и выразительной по сравнению с изолированной записью каждого диктора.

20 часовобъём речевого корпуса
3количество дикторов-актёров

Полный разбор →

Ещё ↓