#рецепт
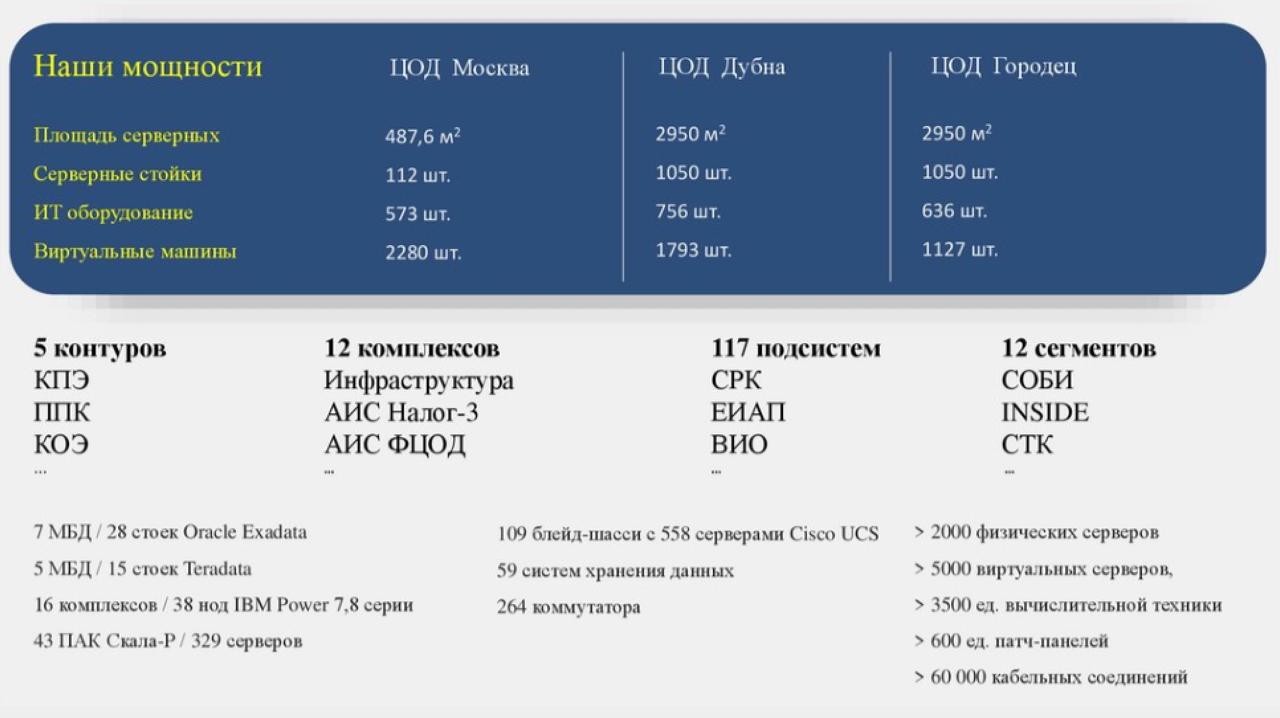
Что общего у ЦОДов Яндекса, концерта Канье и Cloudflare?
У катастроф в IT есть своя специфика. Давай размберем пальцах: пять зависимостей, о которых проджекту стоит спросить
Вендор-лок - не абстрактная архитектурная проблема. Если основной поставщик исчезнет, сможем ли мы принимать платежи, общаться с пользователями и поднять сервис?
1. Домен, DNS, сертификаты
У кого доступ к регистратору, DNS и ключам? Есть ли независимый DNS и путь перевыпустить сертификат, если панель основного CDN лежит?
2. Платежи
Есть ли второй банк или эквайер с договором и проверенной интеграцией? Если нет, кто уведомит клиентов и как сверять зависшие платежи, повторы, возвраты?
3. Связь
Где сообщать статус, если приложение, почта и основной мессенджер недоступны? Нужны независимый канал и ответственный за проверенные обновления
4. Серверы
Есть ли мощность на другой площадке и доступны ли вне основного облака образы, конфигурация, секреты и доступы? Два ЦОДа одной компании с общим управлением могут отказать вместе
5. Данные и БД. Копии лежат у другого провайдера? Рестор проверен? Дамп не течет, не избыточен, и мы можем поднять за адекватные сроки его?Правило
3-2-1 про три копии, два типа носителей, одна вне площадки появилось не просто так. Но бэкап своим существованием не доказывает, что БД восстановится до нужной точки и операции не задвоятся
6. Кто и где получает апдейты от поставщиков и контрагентов? Это должен быть не 1 человек и желательно дублирующийся канал. Компания должна сразу узнать например о блокировке Google Developer Console, а не обнаружить спустя пару дней из хейта в треадс, что у них перестали скачиваться сборки и смочь моментально среагировать
Проджекту не нужно проектировать всё самому. Нужные ответы часто за пределами его зоны ответственности: что реально работает, а что только нарисовано. Например
RTO и RPO, за сколько вернём сервис и сколько данных допустимо потерять. Ну и понимать что арифметку: 99,9% - примерно 43 минуты простоя за 30 дней, без обещания починить одну аварию за 43 минуты
Если вы C-lvl связанный с техничкой или фаундер. Хотя бы раз в год устройте учения: разверните критичный путь с нуля из доступных извне копий, лучше у другого провайдера; проверьте платежи, запись в БД, переключение и откат хотя бы на стейдже. Фактическое время и потери важнее красивой схемы.
AWS прямо рекомендует проверять восстановление практикой
Очень важна развилка: резерв с ценой и сроком в план на год или сознательно принимаем такой-то простой. Запишите цену часа простоя, владельца решения и дату пересмотра. "Все в курсе почему так исторически сложилось" не решение