dokumentyСбросить фильтр ×

ИИ помогает быстро создавать документы для бизнес-процессов

П@pogovorim_za_dengi_nadiaмедиа / агрегатор
5 ч
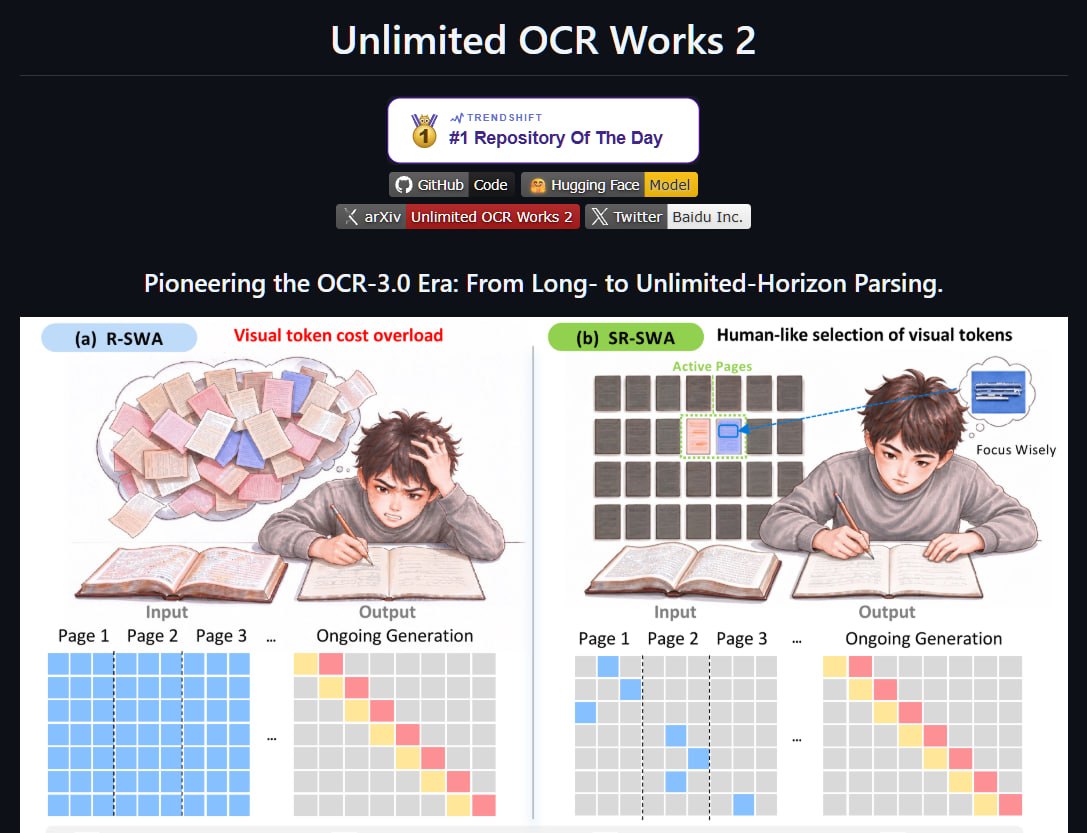
Baidu представила Unlimited-OCR 2 для распознавания длинных документов

М@cgeventAI-инженер
21 ч
Baidu представила Unlimited-OCR 2 для распознавания длинных документов

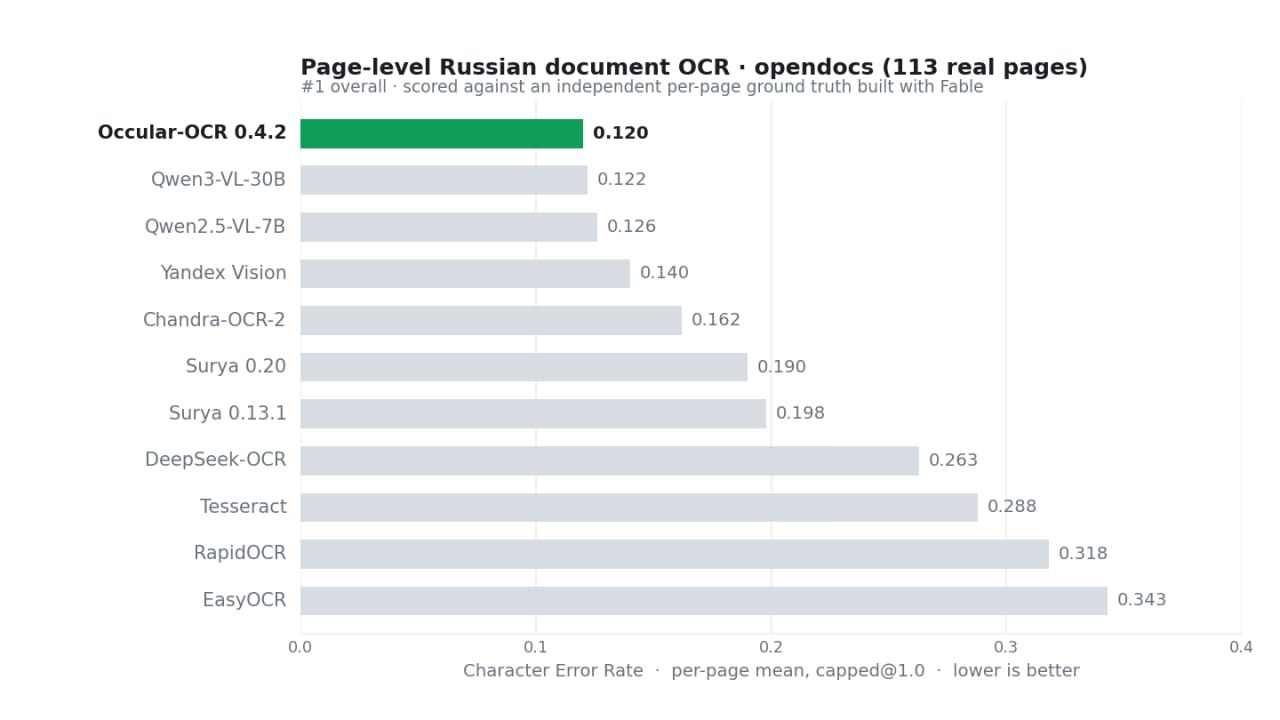
Occular-OCR: новый OCR-движок для русского языка

Н@GreenNeuralRobotsAI-инженер
2 нед
Occular-OCR: новый OCR-движок для русского языка

LightOn представила семейство моделей LightOnOCR-3 для обработки документов

2 нед

Основательница PR-агентства 25/8 попала в миграционную тюрьму из-за поддельных документов

T@Theedinorogblogавтор про «startups»
1 мес
Основательница PR-агентства 25/8 попала в миграционную тюрьму из-за поддельных документов

NeoMME: поиск по PDF без OCR

Н@GreenNeuralRobotsAI-инженер
1 мес
NeoMME Поиск по PDF-документам без OCR. Страницы обрабатываются как изображения, поиск учитывает верстку, таблицы, графики и типографику - Ретривер для RAG: ищет нужные страницы PDF по запросу, а не генерирует ответ - Понимает визуальную структуру — таблицы, графики, колонки, дизайн страницы. OCR выбросил бы всё это - Загрузка документа + запрос → модель возвращает релевантные страницы - 2 размера: 260M и 800M — под разное железо Демо #vlm #ocr VK | MAX

Вышел OpenKB: локальный инструмент для создания базы знаний из документов

Р@remediaгеймдев
1 мес
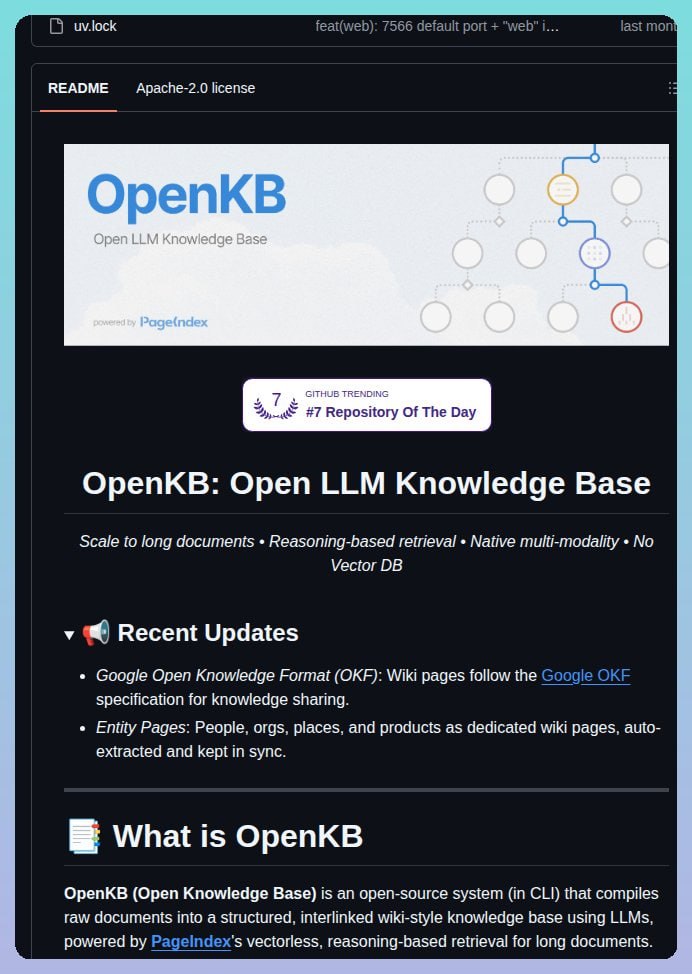
Превращаем свои документы в личную базу знаний — вышла тулза OpenKB, которая собирает в одном месте PDF, Word, презентации, таблицы, статьи и другие документы, сама разбирает их содержимое и связывает информацию между файлами🤙 После этого можно просто спросить что угодно по своей базе, а OpenKB найдёт нужные данные и даст ответ с источниками. Особенно полезно для больших архивов документов, где вручную искать нужную информацию уже больно. Проект open source, работает локально. Забираем — здесь.
Вышел OpenKB: локальный инструмент для создания базы знаний из документов

Что такое RAGFlow и как он решает проблему нарезки документов

Х@habr_comмедиа / агрегатор
2 мес
Что такое RAGFlow и как он решает проблему нарезки документов

Tencent представила модель EVIE-Preview-4.5B для визуального поиска по документам

Н@GreenNeuralRobotsAI-инженер
2 мес
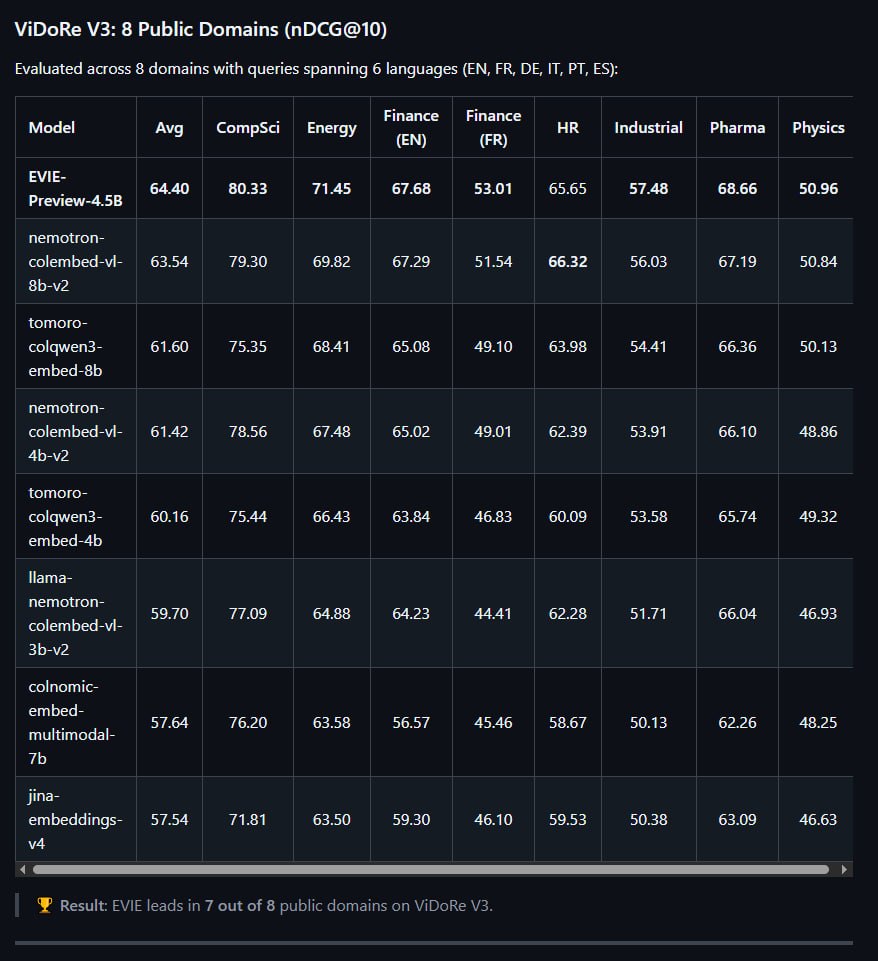
EVIE-Preview-4.5B Модель Tencent для визуального поиска по документам на базе Qwen3.5-4B ищет релевантные страницы по запросу, глядя на картинки, а не на извлечённый текст. Эмбеддинги ультракомпактные, 128 измерений на токен, отсюда низкие требования к памяти и быстрый поиск. • Поиск по сканам, PDF, таблицам, диаграммам и отчётам без OCR • Мультиязычность - EN, FR, DE, IT, ES, PT, ZH и другие • Zero-shot на новых языках и форматах #SOTA на ViDoRe • Обходит 8B модели, будучи вдвое меньше Гитхаб HF #vlm #search #ocr VK | MAX
Tencent представила модель EVIE-Preview-4.5B для визуального поиска по документам

Mistral обновила OCR-модель до версии 4.1

2 мес
Mistral обновила OCR-модель до версии 4.1

Посольство Японии в России изменило требования к визовым документам

v@vcnewsмедиа / агрегатор
2 мес
Посольство Японии в России ужесточило требования к документам о доходах для оформления виз. Например, теперь принимают только оригинал справки из отделения банка об остатке средств — она должна быть с «мокрой» печатью и подписью сотрудника vc.ru/travel/3074762
Посольство Японии в России изменило требования к визовым документам

Firecrawl представил инструмент Anydoc для конвертации документов в Markdown

Н@GreenNeuralRobotsAI-инженер
2 мес
Anydoc Еще один парсер документов от Firecrawl для быстрой конвертации в Markdown без потери структуры и качества • конвертация PDF, Word, презентаций и 10+ форматов • сохранение качества обработки во всех типах файлов • скорость 500 docx за 1,7 секунды • поддержка широкого спектра форматов #any2markdown #ocr

Ужесточение контроля за оформлением документов

В@digitalnomadspainкарьера / HR
2 мес
Ну что, конец кейсам «сделаем документы, с вас только паспорт»?) И беседам «никто ни с кем не обменивается?»:)
Ужесточение контроля за оформлением документов

Firecrawl выпустила опенсорсный Rust-парсер документов anydoc (бывший pdf-inspector)

Компания Firecrawl открыла исходный код быстрого парсера документов на Rusti. Сначала инструмент называли pdf-inspector и он конвертировал только PDF в Markdown, но затем Firecrawl расширила его до anydoc — библиотеки, которая переводит в Markdown не только PDF, но и DOCX, PPTX, XLSX и ещё около 10 других форматов, сохраняя заголовки, таблицы, списки и общую структуру документа.

Инструмент рассчитан на подготовку данных для RAGi-пайплайнiов и AI-агентов: он ставится локально (в том числе на макбук, работает в браузере) и встраивается напрямую в пайплайны обработки документов, например в Claude Code.

0,002 секвремя обработки одной страницы PDF
0,47 секвремя конвертации PDF на 200 страниц
<5 мссреднее время обработки документа в anydoc

Полный разбор →

Релиз компактной OCR-модели OvisOCR2

3 мес

Система использования личных печатей в Японии

Х@habr_comмедиа / агрегатор
3 мес

OfficeCLI: open-source инструмент даёт AI-агентам полный контроль над Word, Excel и PowerPoint

Китайская компания iOfficeAI выпустила open-source тулзу OfficeCLI, которая позволяет любому AI-агенту читать, редактировать и создавать офисные документы (Word, Excel, PowerPoint) без установленного Microsoft Office. Файлы форматов docx, xlsx и pptx генерируются напрямую, без стороннего ПО.

Главная особенность — встроенный rendering enginei: агент может увидеть, что получилось (view html / view screenshot), и сам исправить ошибки в цикле render → look → fix. Это решает главную проблему AI-агентов при работе с документами — отсутствие «зрения» результата.

150+функций Excel поддерживает
7300звёзд на GitHub

Полный разбор →

Массовое одобрение заявок на воссоединение семьи

В@digitalnomadspainкарьера / HR
3 мес
Упало много-много-много одобрений зависших с апреля и мая фамильяров (членов семьи). Всех поздравляю! Кто ждет - до вас скоро дойдет очередь)

Это всё на сейчас.