Обновление библиотеки видео в Плюсе
П@mflenovмедиа / агрегатор
3 нед💾 Изменения за неделю в плюсе.
🤩 Всего теперь доступно 405 видео или 208 часов. Список всех доступен здесь. Для удобства можно использовать Roadmap по видосам.
Американский блогер-инженер Ксандер Науменко столкнулся с проблемой — не с кем играть в аэрохоккейi — и решил её, автоматизировав игровой стол. Над полем установлена камера, которая отслеживает шайбу и считывает её траекторию, а биту двигают по столу четыре троса на электроприводах.
Ролик с демонстрацией робота набрал более 40 миллионов просмотров за несколько дней, а самому автору теперь поступают коммерческие предложения.
HeyGen представил собственную видеомодель HeyGen Video, которая построена на открытой foundation-модели MiniMax H3 и дополнительно дотренирована («post-trainedi») внутри компании под задачи консистентности, следования prompt, работы с продуктами и референсами и синхронного звука. Это, по мнению источника, знаменует новую фазу рынка AI-видео: раньше сервисы просто собирали у себя чужие модели (Kling, Veo, Seedance, MiniMax) под единым интерфейсом, теперь на базе открытых весов начинают строить и продавать как «свои».
Главная интрига — цена: HeyGen предлагает генерацию заметно дешевле, чем стоит API самой MiniMax H3, на которой построена их модель. Второй источник из той же медиагруппы иронично резюмирует: по сути это MiniMax, только без открытых весов.
Согласно новому видео каналов «Дизраптор» и «Фичизм», в конце прошлого века США передали Китаю одну из ключевых технологий современности. Китайские компании довели её до «космического уровня», а теперь ситуация перевернулась: американские фирмы покупают лицензии у китайских производителей и приглашают китайских специалистов, чтобы те помогли построить производство по китайским стандартам.
Историю о том, как так вышло, оба канала разбирают в совместном видеоролике на YouTube.
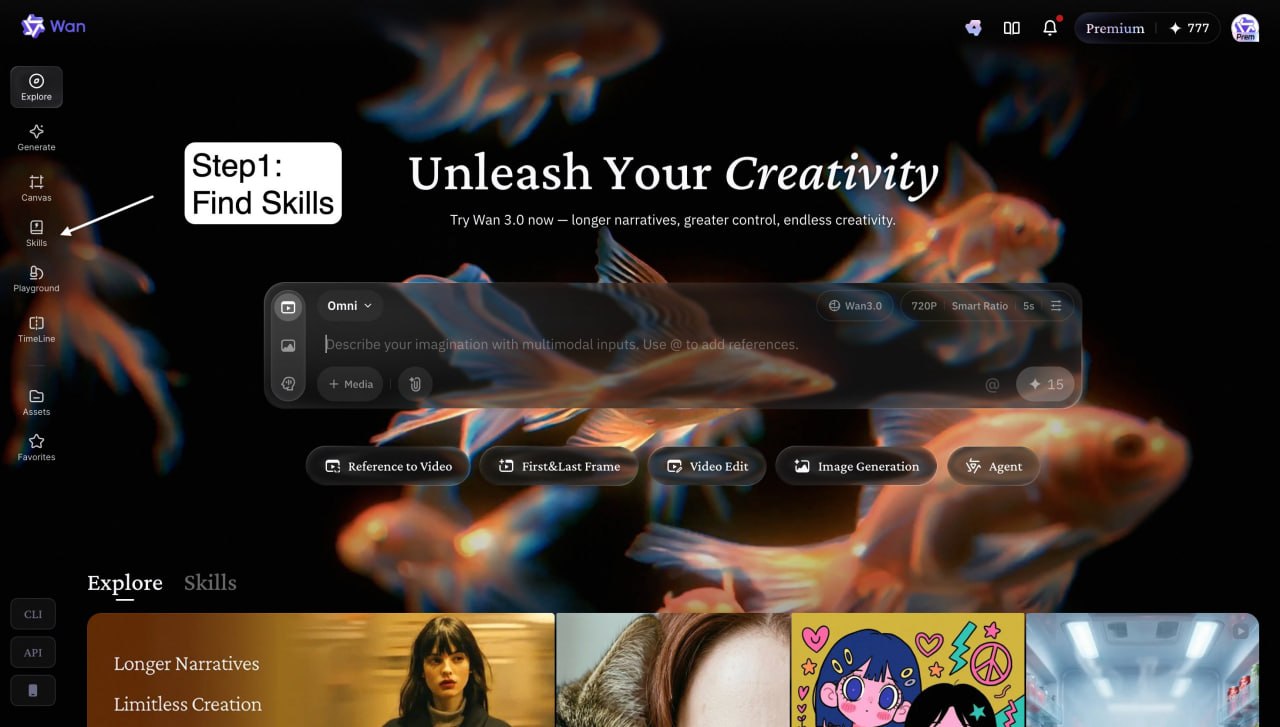
YouTube представил ИИ-ассистента для редактирования видео и Shorts, который работает через текстовые (голосовые) команды: убирает лишние паузы, переставляет сцены «для улучшения темпа» и генерирует обложки в стиле канала. Инструмент превращает монтаж в диалог с моделью — пользователь загружает исходники в Shorts или YouTube Createi и просит собрать черновик, а не двигает таймлайн руками.
По данным канала «Метаверсище и ИИще», в основе фичи лежит Gemini Omnii — модель, которая, в отличие от большинства конкурентов, реально понимает не только текст и картинки, но и аудио на входе. Автор уточняет, что ранее ошибочно называл мультимодальными многие модели (включая DeepSeek, Kimi и собственную Astra), хотя они принимают только текст и картинки; по-настоящему мультимодальными на аудио остаются Gemini и новый Qwen Omni.