нейросетиСбросить фильтр ×

Тест Qwen 3.8 27B на RTX 2080: рабочий день на боевых задачах

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 2 мес назад

Автор канала «Галера Морева» провёл целый рабочий день, прогоняя модель Qwen 3.8 27B через реальные агентские и разработческие задачи — не синтетические тесты, а боевые проекты.

По плану предполагалась эскалация мощностей: от одной RTX 2080 до пары 2080 и далее до двух RTX 3090, если слабое железо не справится. Но неожиданно все задачи решила самая базовая конфигурация — одна RTX 2080 с квантованием Q4_K_Mi.

27Bразмер модели Qwen 3.8
22 ГБобъём VRAM на RTX 2080
Полный разбор →

Обзор инструментов и оптимизаций для Minimax H3

Н@GreenNeuralRobotsAI-инженер
2 мес

Подборка инструментов и воркфлоу для Minimax H3

Н@GreenNeuralRobotsAI-инженер
2 мес

Релиз MiniMax-H3 Pruned Ref-Delta Fused

Н@GreenNeuralRobotsAI-инженер
2 мес
MiniMax-H3 Pruned Ref-Delta Fused r1024 Облегченная версия #MiniMaxH3, два отдельных чекпоинта склеены в один и сжаты Обычный H3 существует в двух вариантах: FL2VA и Ref2VA. ~33B параметров Здесь взяли обрезанную (pruned) версию FL2VA, вычислили разницу между Ref2VA и FL2VA, сжали эту разницу до аккуратного приближения (ранг 1024) и вшили прямо в веса. Получился один файл на ~20B параметров, который умеет и FL2VA, и Ref2VA без переключения чекпоинтов. + недавний апдейт - INT8 - еще компактнее версия для #ComfyUI Там есть #INT8 и INT8 #ConvRot #optimization VK | MAX

Perplexity представила инструмент для локального запуска ИИ-моделей Portable Computer

v@vcnewsмедиа / агрегатор
2 мес
Perplexity представила инструмент для локального запуска ИИ-моделей Portable Computer. Пока он работает на компьютерах Nvidia DGX Spark, но «вскоре» станет доступен и на ПК с видеокартами RTX vc.ru/ai/3097699

Alibaba тизерит Qwen3.8-Flash-Next — первую модель на архитектуре будущего Qwen-4

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 2 мес назад

Китайская платформа Model Scopei (аналог Hugging Face в Китае) запустила обратный отсчёт до релиза модели Qwen3.8-Flash-Next. Это будет первая модель, построенная на архитектуре следующего поколения, на которой в дальнейшем будет основан и сам Qwen-4.

Деталей пока немного, но известно, что изменения затронут механизм внимания, residual-связиi, эмбеддинг-слоиi и оптимизацию модели — то есть речь о довольно глубокой архитектурной перестройке, а не о косметическом обновлении.

Полный разбор →

Выход FireRedTTS3: новая модель для клонирования и редактирования голоса

Н@GreenNeuralRobotsAI-инженер
2 мес

Prime Flash MoE: оптимизированные кернелы для архитектуры Blackwell

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 2 мес назад

Компания Prime Intellect представила Prime Flash MoEi — специализированный fused-кернелi, предназначенный для ускорения работы моделей с архитектурой Mixture-of-Experts (MoE) на графических процессорах NVIDIA Blackwell.

Решение направлено на устранение узких мест при работе с памятью и синхронизацией потоков, что позволяет значительно повысить производительность вычислений по сравнению со стандартными методами PyTorch.

20%прирост скорости в формате bf16
2 разаускорение в формате mxfp8

Полный разбор →

Короткометражный фильм, созданный с помощью нейросетей

М@cgeventAI-инженер
2 мес
#Нейропрожарка Фильм сделан специально для участия в AAIFF Автор: Илья Никитин https://t.me/nikitin_films Графика: Midjourney 8, NanoBananaPro, Seedream 5, GPT Image 2 Анимация: Seedance 2/2.5, Kling 3.0, Minimax H3 Музыка: Suno 5.5 @cgevent

Alibaba запустила Wan 3.0 везде: видео до 30 секунд прямо из презентации или веб-страницы

24 августа Alibaba официально выпустила видеогенератор Wan 3.0 и сразу раскатала его по всем основным платформам: собственный сайт wan.video, Alibaba Cloud Model Studio, Qwen Cloud, а также сторонние сервисы fal.ai, Runware, Magnific и крупные агрегаторы. Модель умеет генерировать ролики длительностью до 30 секунд со звуком и принимает на вход не только текст и картинки, но и PDF, презентации, таблицы и даже ссылки на веб-страницы — то есть видео можно получить, просто «покормив» модель документом, без текстового промпта.

Цена делает Wan 3.0 заметно дешевле аналогов: 30 секунд в 1080p стоят $6, что, по оценке NEURO-AI Новости ИИ, вчетверо дешевле, чем у Veo от Google. При этом сама Alibaba признаёт слабое место — надписи в кадре пока получаются кривыми.

$6цена 30 сек в 1080p (Standard)
30%скидка на Standard до 23 сентября
30 секундмаксимальная длина одной генерации

Полный разбор →

Детализацию от Z-Image пересадили в видео-модели MiniMax-H3 и Joy-LTX 2.5

В сообществе Нейронавт показали технику переноса «чувства детализации» от Z-Imagei — компактной 6B image-модели, хорошо прорабатывающей текстуры, — в чекпоинты других видео-движков без переобучения и изменения архитектуры. Сначала приём применили к MiniMax-H3i, затем к Joy-LTX 2.5.

Результат: окружение, материалы и лица становятся заметно детальнее (краска, ржавчина, вода, солома, листва, кожа), при этом видео, звук и поведение базовой модели не меняются, а детализация не «плывёт» между кадрами при склейках.

6Bразмер модели Z-Image
21.5 GBобъём кванта Q8_0
11.5/19.9 GBобъём кванта Q4_0

Полный разбор →

Qwen3.8-27B-Uncensored: китайскую модель без цензуры выпустили под все платформы

На Hugging Face от аккаунта orcarouter появилось семейство сборок Qwen3.8-27B-Uncensored — версии китайской модели Qwen3.8-27B с ослабленными или снятыми встроенными ограничениями на выдачу контента. За неделю (18–25 августа) вышли варианты под все основные сценарии запуска: MLXi для Apple Silicon (квантование 2/4/6/8 бит), FP8, GGUFi и полная точность BF16, а также готовый API через OrcaRouter для тех, кто не хочет разворачивать модель самостоятельно.

Значимость истории в том, что мощная 27B-модель с рассуждениями, зрением и вызовом инструментов теперь запускается полностью локально, без серверных фильтров и внешнего API — то есть уровень ограничений определяется не платформой, а тем, какую сборку скачал пользователь и как её настроил.

27Bпараметров у модели
262Kтокенов максимальный контекст
2, 4, 6, 8-bitварианты квантования MLX-сборки

Полный разбор →

Выход модели Wan 3.0 Prime с ускоренной генерацией видео

М@cgeventAI-инженер
2 мес

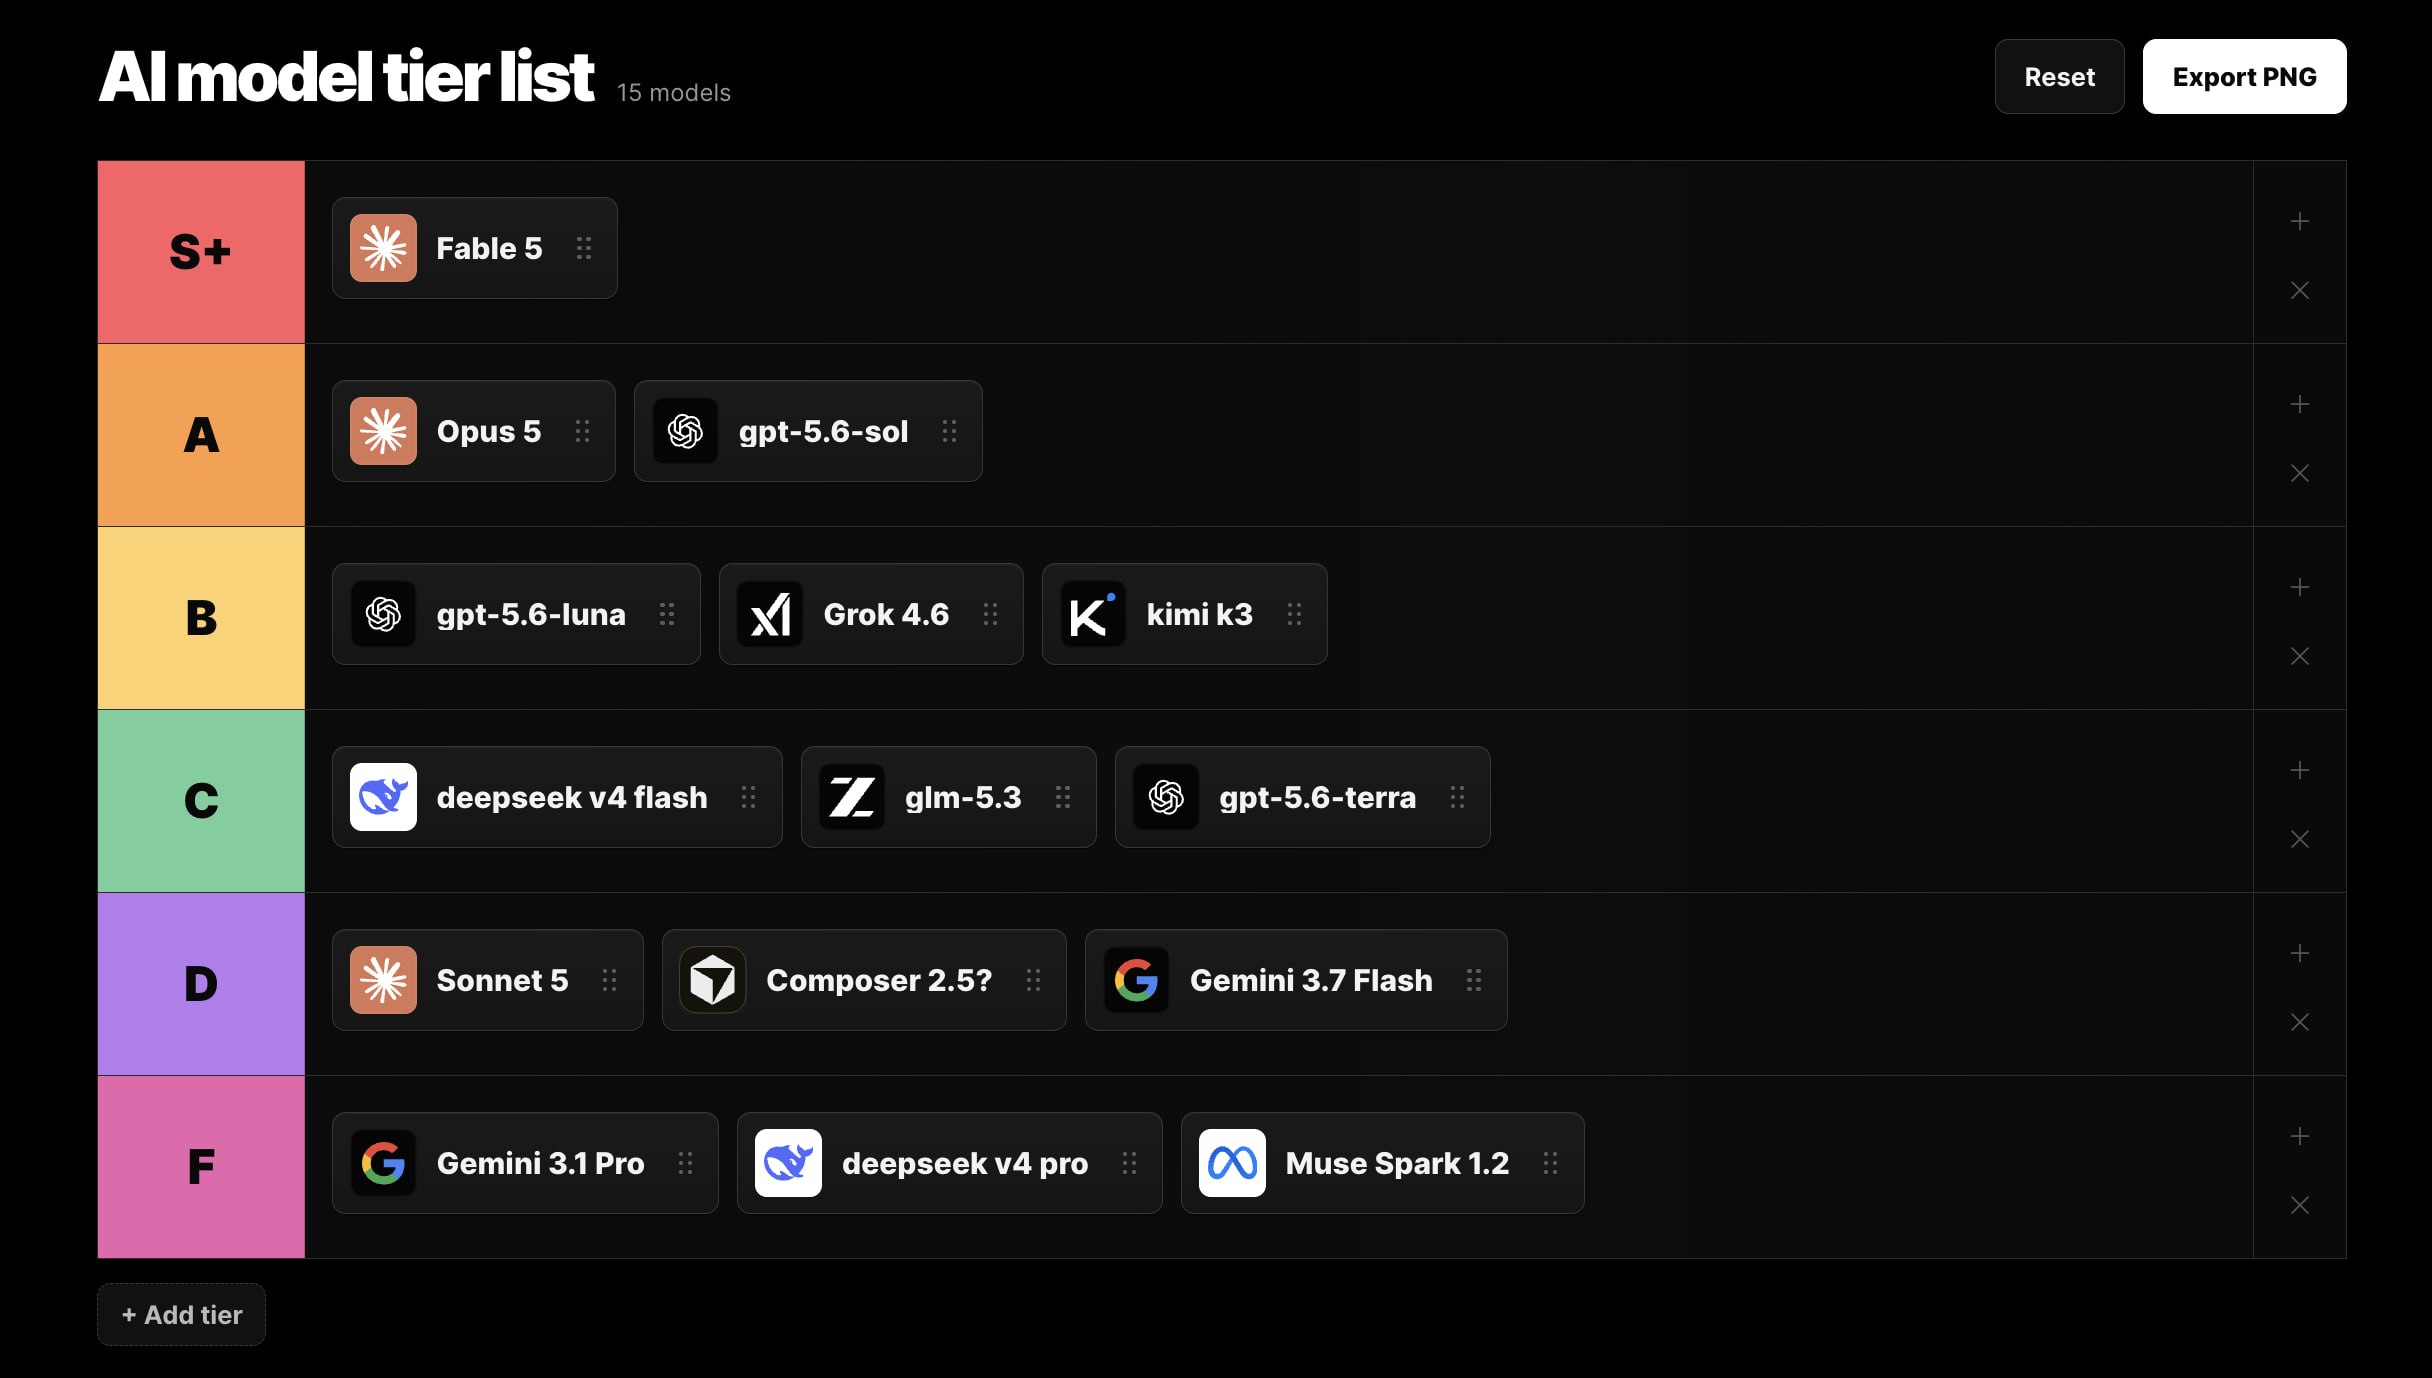
Сравнение способностей GPT и человека в решении IQ-тестов

Е@elnitskiyAI-инженер
2 мес
Сравнение способностей GPT и человека в решении IQ-тестов

InfinityEdit: инструмент для бесконечного редактирования видео

Н@GreenNeuralRobotsAI-инженер
2 мес
InfinityEdit Инструмент для бесконечного редактирования видео по текстовым командам, который не заканчивается, от Zhejiang University + Alibaba Group. Видео продолжает генерироваться, а команды накладываются на живой поток одна за другой - Правки по текстовым инструкциям - Поток не обрывается: каждая новая правка продолжает уже измененное видео, а не переписывает его заново - Генерация длинного видео с накоплением правок без потери качества - Работает поверх готового видеогенератора, сам инструмент легкий Замороженный бэкбоун - Helios-Distilled Гитхаб #streaming #videoediting VK | MAX
Ещё ↓