Keenable о методологии бенчмарка Artificial Analysis
С@senior_augurAI-инженер
2 мес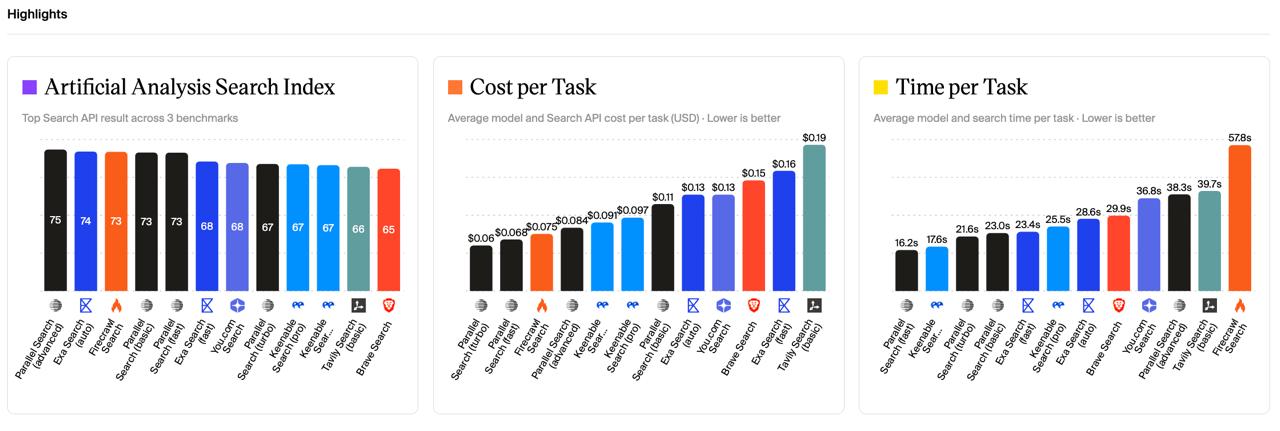
Компания Black Forest Labs (BFL) анонсировала FLUX 3 — не просто новый генератор картинок, а единую мультимодальную модель, которая работает с изображениями, видео, звуком и текстом в рамках одного «движка», понимающего сцену целиком: как выглядят объекты, как они двигаются и звучат. Модель умеет создавать и редактировать изображения, а также генерировать видео длиной до 20 секунд сразу с нативным звуком, поддерживает text-to-video, image-to-video, video-to-video, продолжение роликов, переходы между ключевыми кадрами и многоязычные диалоги.
Анонс получился смазанным: страница /models/flux-3 ненадолго появилась на сайте BFL и была удалена, но осталась в Wayback Machine. Затем глава BFL Робин Ромбах опубликовал загадочный тизер, а разработчик Machine Delusions заявил, что уже тестирует модель и «публика к ней не готова». Официально FLUX 3 Video запущен в ограниченном Early Accessi, доступ к FLUX 3 Image обещают открыть в ближайшие недели; открытые веса FLUX 3 Devi пока только запланированы.
Primate Labs представила новую версию бенчмарка Geekbenchi 7 для Windows, Linux и macOS. Пакет получил новые сценарии тестирования — от игровой физики до кодирования видео и распознавания речи — и новую точку отсчёта для расчёта баллов, из-за чего результаты нельзя сравнивать напрямую с предыдущей версией Geekbench 6.
По данным PRO Hi-Tech, релиз состоялся не по плану компании: дистрибутивы и документация оказались раньше времени выложены из-за утечки с серверов Primate Labs.
Автор канала @llm_under_hood (по совету @AigizK) протестировал модель Gemma 4 31B, запущенную на специализированных чипах Cerebrasi, на агентском бенчмарке под бизнес-задачи. С выключенным reasoning (он тормозит и спотыкается о structured outputs) модель сдвинула фронтир скорости бенчмарка и оказалась совсем рядом с GPT-5.4 mini по качеству и цене — при этом её, в отличие от закрытой GPT-5.4 mini, можно скачать и запускать локально.
Через два дня выяснилось, что эффект не ограничивается одной моделью: запуск gpt-oss-120B на том же железе Cerebras во всех трёх режимах reasoning (high, medium, low) тоже выводит её на speed frontier, а medium-режим дополнительно попадает на cost-фронтир по эффективности. Вывод автора — дело не столько в конкретной модели, сколько в самом железе Cerebras, которое команды уже используют для near-realtime AI-решений.
ВыводCerebras выпускает wafer-scale engines — чипы, которые примерно в 50 раз крупнее самых больших GPU, что делает железо дорогим и специализированным, но позволяет запускать небольшие модели на очень высоких скоростях