генерация изображенийСбросить фильтр ×

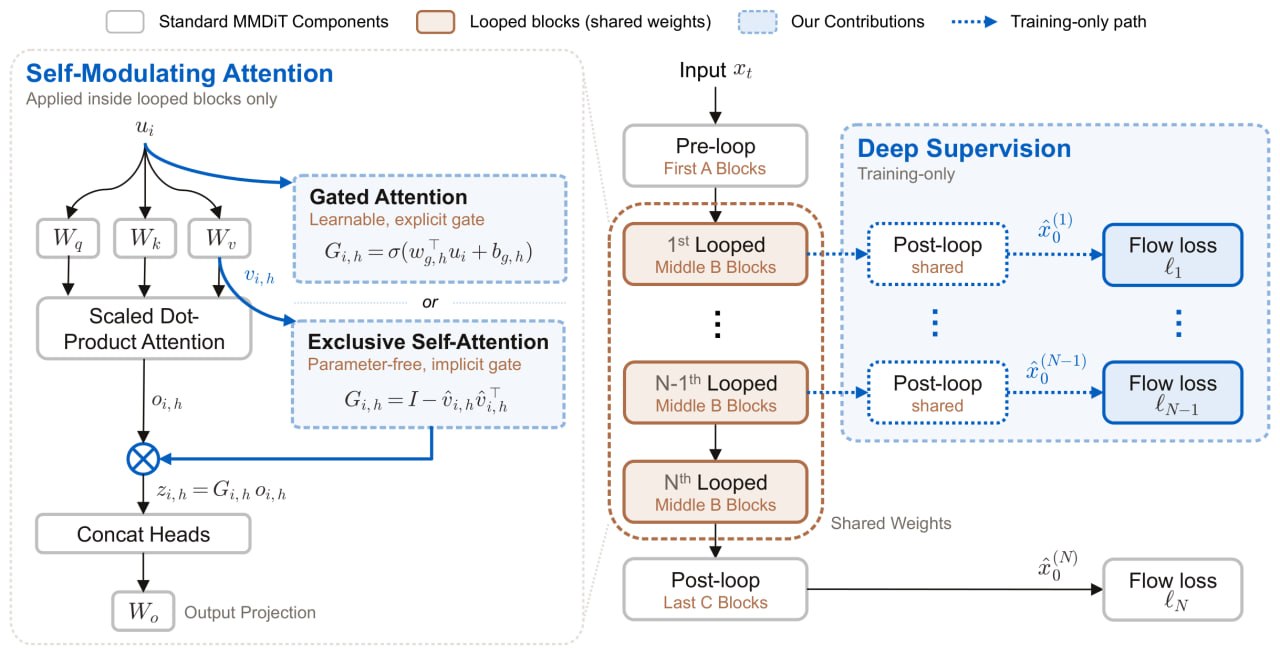
Looped-DiT: новый подход к генерации изображений от SenseNova

Н@GreenNeuralRobotsAI-инженер
3 нед
Looped-DiT: новый подход к генерации изображений от SenseNova

Выпуск Anima-Lightning: дистиллированная модель для генерации за 4 шага

Н@GreenNeuralRobotsAI-инженер
3 нед
Anima-Lightning Дистиллированная версия модели Anima для генерации за 4 шага • Аниме, иллюстрации и другая не-фотореалистичная арт-генерация Совместима с любым 4-step планировщиком #anime #t2i MAX
Выпуск Anima-Lightning: дистиллированная модель для генерации за 4 шага

FLUX.2 Klein Alpha: генерация изображений с прозрачностью

Н@GreenNeuralRobotsAI-инженер
3 нед
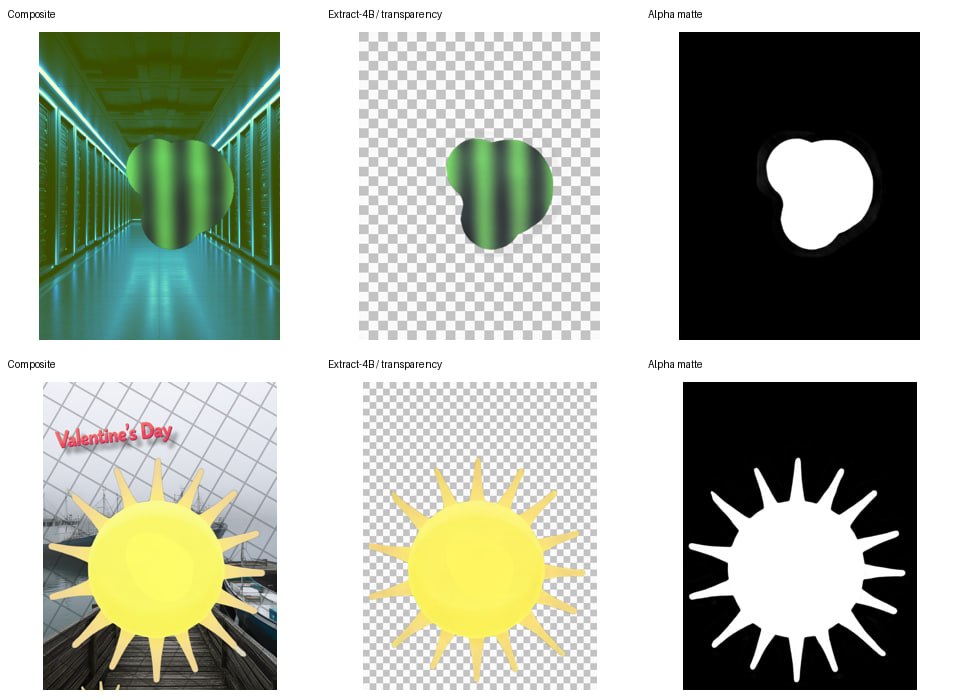
FLUX.2 Klein Alpha Ишь ты, FLUX.2 Klein научили делать прозрачные изображения. Расширили VAE до 4 каналов (RGBA) и натренировали LoRA для вырезания объектов в PNG с прозрачностью • Вырезание объекта из фото — на вход картинка с объектом и фон без него, на выходе прозрачный PNG • Стирание объектов • Мягкие тени и блики остаются полупрозрачными • ~11 с/изображение, ~10 ГБ VRAM • Работает на одной видеокарте 16 ГБ Гитхаб Демо #rgba #t2rgba #klein MAX
FLUX.2 Klein Alpha: генерация изображений с прозрачностью

Ideogram выпустила модель 4.5 с редактированием изображений без «каши» после правок

Компания Ideogram, основанная бывшими разработчиками Google, представила модель Ideogram 4.5, объединяющую генерацию и редактирование изображений. Главная заявленная особенность — борьба с накоплением ошибок при многократных правках: модель старается не трогать то, что не просили менять, сохраняя пиксели, цвета и текстуры исходника даже после десятой правки подряд.

Это значимо, потому что до сих пор ни одна модель не умела спокойно и предсказуемо вносить правки в изображение много раз без деградации картинки — именно это, а не сама генерация, было слабым местом индустрии.
4016 x 6016 (24.2 Мп)разрешение демо-исходника для Zoom Editing
$0.008–$0.22стоимость генерации одного изображения
2Kнативное разрешение генерации

Полный разбор →

Эксперимент по созданию YouTube-обложек через HTML и ИИ

Л@baldfrombrowserмедиа / агрегатор
3 нед

MaLiang-Harness: фреймворк для генерации визуального контента через код

Н@GreenNeuralRobotsAI-инженер
3 нед
MaLiang-Harness Фреймворк, превращающий MLLM в художников, пишущих код. Генерация изображений и видео через постоянное конструирование, инспекцию и правку. Закрывает разрыв между исполняемыми программами и визуальным качеством. Оценивали 11 ведущих моделей на двух новых бенчмарках Гитхаб #harness #agent #t2i #t2v MAX

Использование апскейлера ByteDance для удаления артефактов GPT

A@strangedalleAI-инженер
3 нед
В продолжение поста про борьбу с GTP Image шкалами🪄 Методом тыка случайно выяснил, что байтдэнсовский апскейлер вполне неплохо зачищает типичные гпт артефакты (ну, по мимо самого апскейла). В целом более реалистичная пластика по резкости и текстурам получается. Чуть перерисовывает, но самую малость — как раз, чтобы убрать гптшную чешую и сетку (а заодно мелкие надписи, поэтому для этого не годится). Использую сейчас в хиггсе, ищите в вашем агрегаторе.
Использование апскейлера ByteDance для удаления артефактов GPT

SOL-Refiner: новый метод улучшения качества диффузионных моделей

Н@GreenNeuralRobotsAI-инженер
3 нед
SOL-Refiner (NVIDIA и MIT) Дообучение рефайнера для диффузионных моделей Улучшает качество генерации диффузионных моделей. Работает поверх существующих пайплайнов: берешь результат базовой модели, прогоняешь через SOL-Refiner — детали становятся четче, артефакты уходят • Повышает детализацию и чистоту изображений • Работает как пост-процессинг после любой диффузионной модели Гитхаб HF - #LTX23 #MinimaxH3 int8 Спасибо @kiticatmur #enhance MAX

Nanosaur 2: компактная модель генерации изображений

Н@GreenNeuralRobotsAI-инженер
4 нед
Nanosaur 2: компактная модель генерации изображений

Ming Image Prompt Builder для ComfyUI

Н@GreenNeuralRobotsAI-инженер
4 нед
Ming Image Prompt Builder для ComfyUI

Zen Image Edit: облегченная альтернатива Qwen-Image-2.1 для ComfyUI

Н@GreenNeuralRobotsAI-инженер
1 мес
Zen Image Edit: облегченная альтернатива Qwen-Image-2.1 для ComfyUI

Релиз модели генерации изображений Recraft V4.1 Flash

Н@GreenNeuralRobotsAI-инженер
1 мес
Recraft V4.1 Flash
Самая быстрая модель генерации изображений на рынке
1.3 секунды от промпта до картинки через API. Быстрый ответ меняет работу - не теряешь фокус между генерациями • фото, портреты, сложные сцены и ранние концепты в стиле Recraft • кнопка Refine - добивает картинку моделью V4.1 Pro в 2048x2048 • держит точные промпты - семь морковок так семь • читает нюансы - intimate значит два человека, а не двенадцать Refine в двух уровнях - subtle и moderate, держит композицию и свет Если вдруг кому надо - уже подключили в партнерские ноды комфи #t2i #i2i MAX
inclusionAI выпустила две модели для генерации и редактирования дизайна

1 мес
inclusionAI выпустила две модели для генерации и редактирования дизайна

ComfyUI-InpaintCanvas: комплексный редактор для инпейнтинга

Н@GreenNeuralRobotsAI-инженер
1 мес

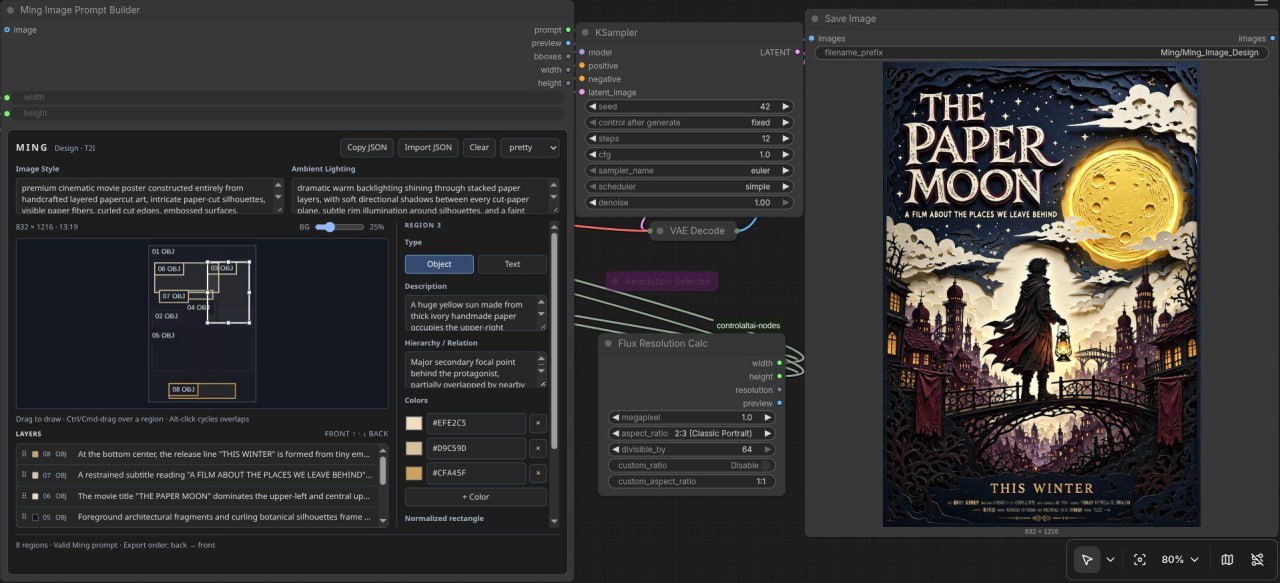
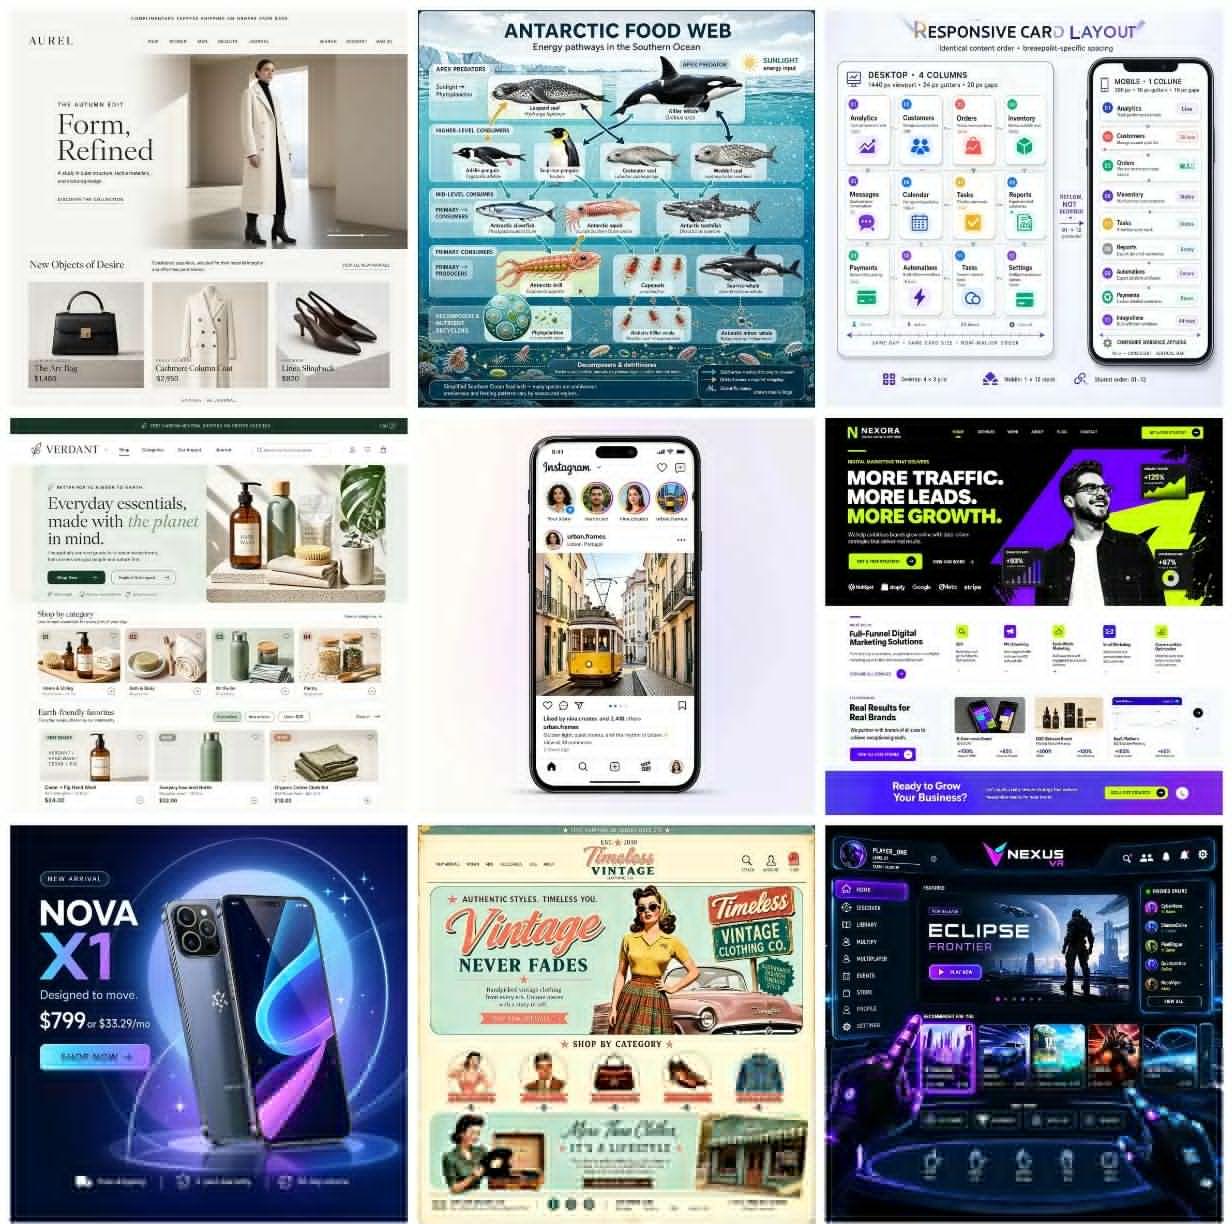
Ant Group выпустила Ming-Image-0.1-Design — открытую модель генерации UI, постеров и дизайна

Ant Group представила Ming-Image-0.1-Design — модель генерации изображений на 6B параметров, заточенную специально под дизайн: UI-интерфейсы, дашборды, постеры, инфографику и работу с текстом. Модель open-weighti, лицензия MIT, веса доступны для локального запуска.

Отдельно вышла модель Ming-Image-0.1-Design-Layer, которая берёт готовую плоскую картинку и разбирает её на отдельные редактируемые RGBAi-слои — фактически автоматизируя ресёрч дизайнера по декомпозиции макета.
6Bпараметров у Ming-Image-0.1-Design
53 GBразмер полного чекпоинта модели
4.3 разабыстрее Qwen-базы на 20B у Design-Layer

Полный разбор →

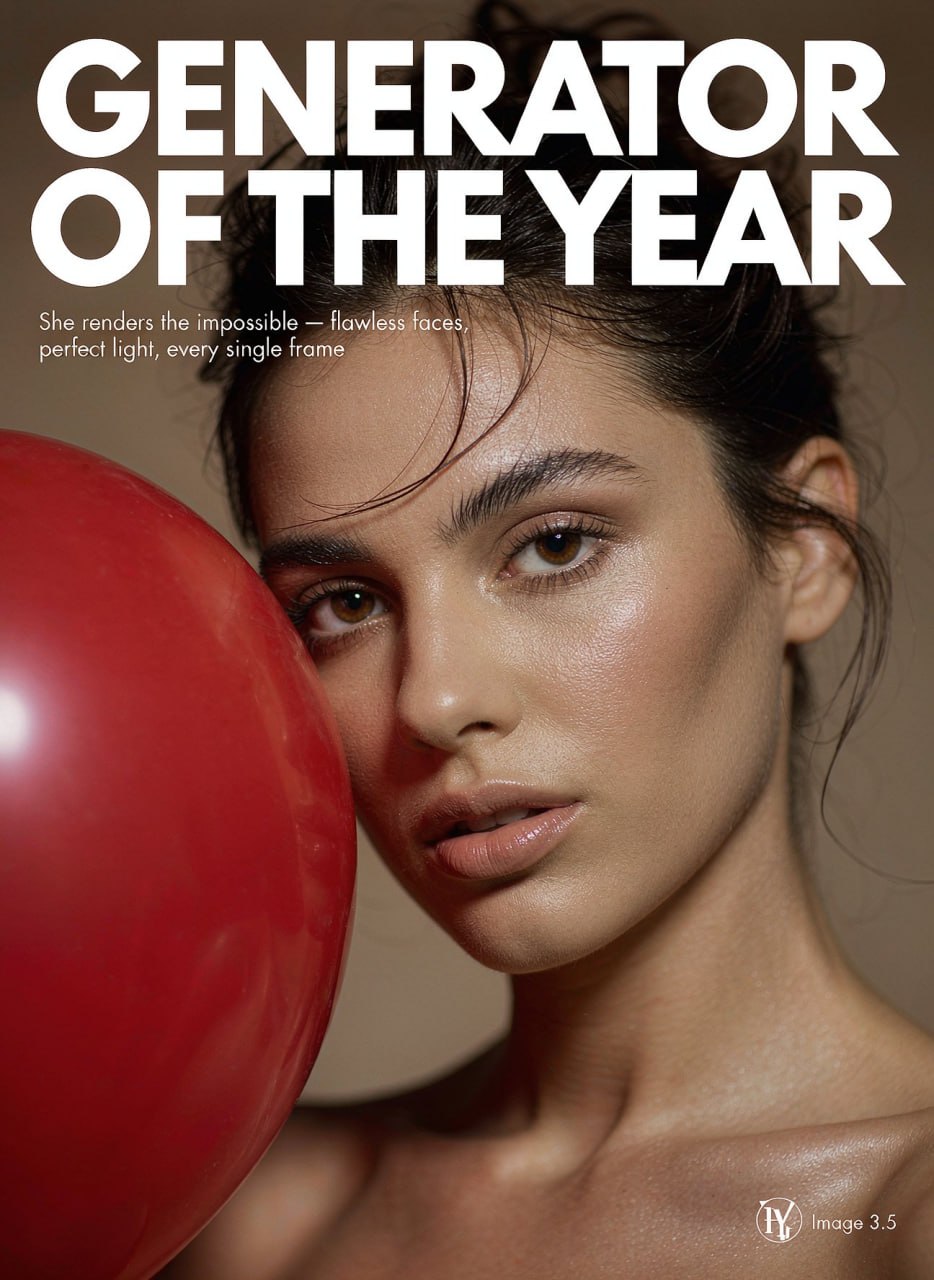
Tencent представила модель генерации изображений Hy Image 3.5 Preview

М@cgeventAI-инженер
1 мес
Tencent представила модель генерации изображений Hy Image 3.5 Preview

Анонс выхода модели Нанабанана 2.5

М@cgeventAI-инженер
1 мес
Нанабанана 2.5 появится на днях. На арене уже давно её тестируют под названием River Flow и Spicy Mayo. С помощью неё вы можете делать вот такие вот скриншоты. И да, Google показывает, что это Google. @cgevent

Alibaba выпустила Qwen-Image-2.1 — открытую модель генерации и редактирования изображений

Alibaba (команда Qwen) представила Qwen-Image-2.1 — единую диффузионную модель, которая одновременно генерирует изображения по тексту и редактирует их, включая работу с прозрачностью (RGBAi). Релиз состоялся 20 сентября в 16:00, веса сразу выложены в открытый доступ на Hugging Face и GitHub, а ComfyUI обеспечила поддержку day-0.

По собственным бенчмаркам Qwen модель сравнялась или превзошла закрытые GPT Image 1.5 и Nano Banana 2.0 (Nano Banana 2), при этом занимая всего 7B параметров — что делает её одной из самых доступных по железу моделей такого уровня.
7Bпараметров визуальной модели
2048x2048базовое разрешение генерации
10максимум референсных изображений

Полный разбор →

Поиск облачных альтернатив Strophe для генерации изображений и видео

U@uxliveмедиа / агрегатор
1 мес
Какой сейчас самый заебатый агрегатор нейронок для картинок\видео, желательно с нодовой системой? Я почти год пользовался https://strophe.app/ и меня всё в нём устраивало, но теперь хочется попробовать что-то ещё. Чем пользуетесь? ComfyUI и прочий локальный кал не предлагать, интересуют сидэнсы, бананы и прочее.

Выпущены модели QI2.1 Prompt Enhancer для ComfyUI

Н@GreenNeuralRobotsAI-инженер
1 мес
Выпущены модели QI2.1 Prompt Enhancer для ComfyUI
Ещё ↓