audioСбросить фильтр ×

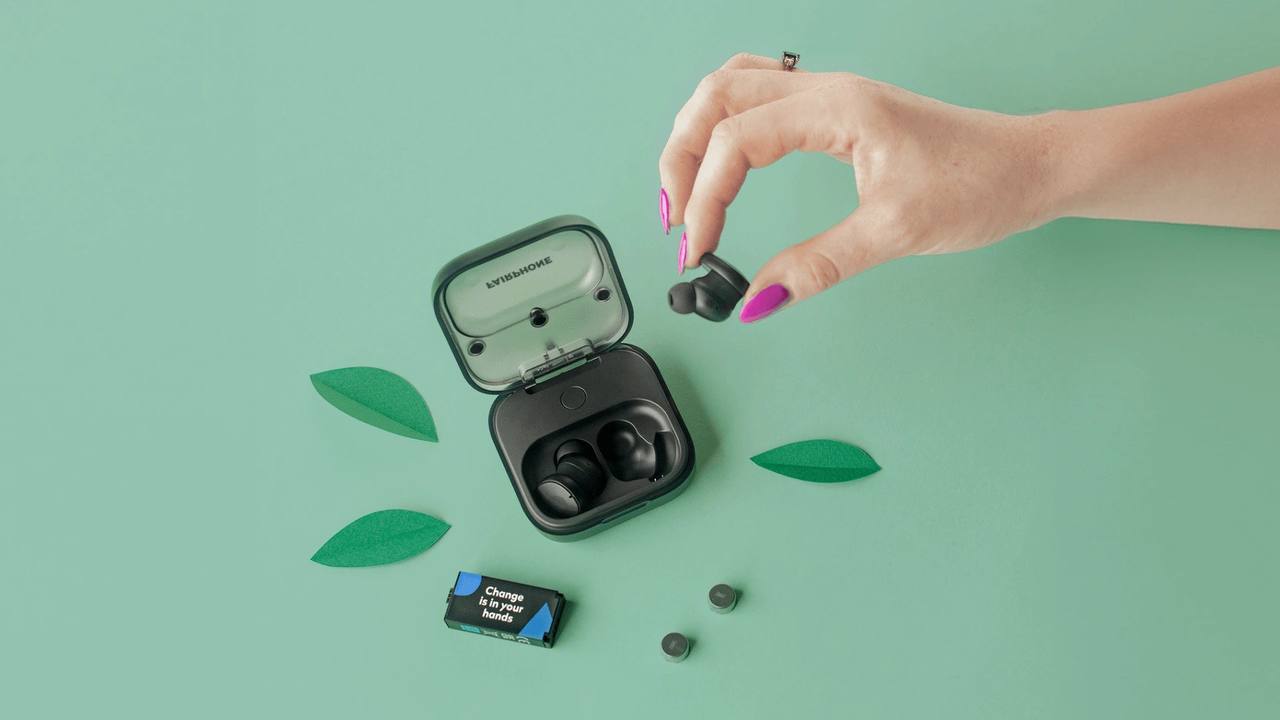
Fairphone анонсировала наушники Fairbuds 2

B@biggeekавтор про «tech»
3 нед
Fairphone представит Fairbuds 2 с заменяемыми деталями По заявлению бренда, в конструкции модели предусмотрено семь заменяемых компонентов, включая аккумуляторы, а отдельно теперь можно будет купить один наушник вместо пары. Новинка также получит поддержку кодека Sony LDAC для передачи аудио высокого разрешения. У первого поколения были только SBC и AAC. В Европе Fairbuds 2 выйдут 14 октября по цене €119 (~11 200 ₽), позже наушники появятся в США за $119 (~9 900 ₽).
Fairphone анонсировала наушники Fairbuds 2

Engram: сэмплер на базе ИИ-галлюцинаций

D@droidergramавтор про «tech»
4 нед

TrackGleam: автоматический мастеринг звука в браузере

N@notboring_techAI-инженер
4 нед
🎶 Нашёл новую тулзу, которая делает автоматический мастеринг треков — TrackGleam прямо в браузере выдаёт чистый и насыщенный звук, как после обработки в студии. Что делает: • Исправляет частотный баланс, уменьшает резкость и многое другое. • Отдельно контролирует низкие, средние и высокие частоты. • Добавляет громкость и плотность звука. • С помощью режимов AI Fix Gentle и Strong удаляет артефакты музыки от ИИ. • Результат можно скачать в формате WAV. • Без регистрации и водяных знаков. • Вся обработка происходит локально, файлы не уходят на сервер. Ваша личная студия звукозаписи в браузере — тут. @notboring_tech

VoiceChat-TTS: модель синтеза речи с низкой задержкой для интерактивных агентов

g@grokaem_sebyмедиа / агрегатор
4 нед

Apple открыла концертный зал Apple Music Hall в Лондоне и обновляет Apple Music

Apple открыла собственный концертный зал Apple Music Halli в культовом здании бывшей угольной электростанции «Баттерси» на юге Лондона. В тот же день сервис Apple Music получил новый, более жирный и броский логотип, а компания объявила первую волну артистов, которые выступят в новом зале — все концерты будут транслироваться через сервис.

Параллельно Apple будет транслировать фестиваль электронной музыки Head Tripi 10–11 октября, а на первые числа октября ожидается презентация новой приставки Apple TV 4K и колонок HomePod, изображения которых уже утекли в сеть. Вместе эти шаги выглядят как подготовка Apple к превращению Apple Music и своих устройств в единую платформу для просмотра живых концертов.

600мест в зале Apple Music Hall
48динамиков системы пространственного звука
16видеокамер для трансляций

Полный разбор →

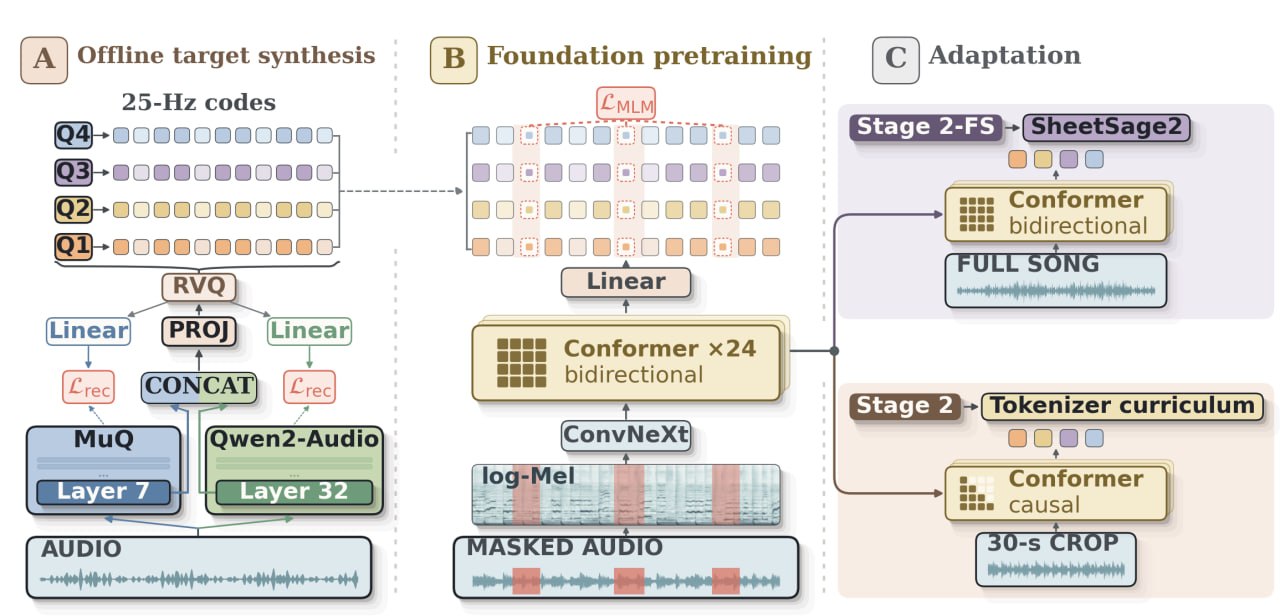
Выпущен MERT-v2-FullSong: музыкальный энкодер для анализа длинных композиций

Н@GreenNeuralRobotsAI-инженер
4 нед
MERT-v2-FullSong Музыкальный энкодер на 632M параметров, который понимает целую песню от 30 до 360 секунд. Продолжение MERT-v2-30s, bidirectional, дообучен на полных композициях • репрезентации на уровне кадров и всей записи • 24 кГц моно, 1024 измерения, 25 Гц • жанр, бит, тональность, эмоции, инструменты, аккорды • интерфейс как у классического MERT - работает через Transformers Место в экосистеме #YuE2: causal-ветка MERT2 токенизирует аудио для генератора песен, а FullSong закрывает эмбеддинги целых треков На бенчмарке MARBLE (15 задач понимания музыки) лучше всех байзлайнов в 13 из 15 метрик #encoder #music MAX
Выпущен MERT-v2-FullSong: музыкальный энкодер для анализа длинных композиций

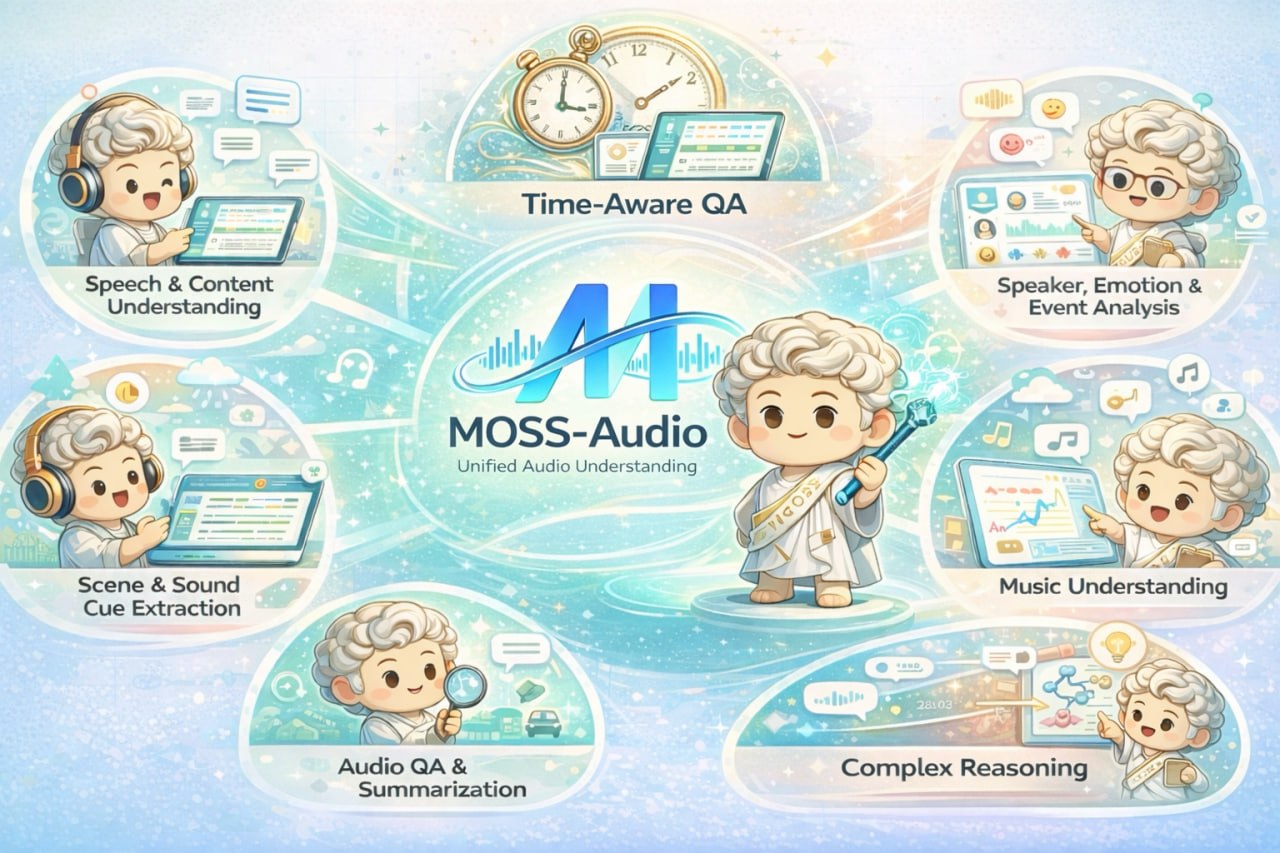
MOSS-Audio: открытая модель для анализа аудио

Н@GreenNeuralRobotsAI-инженер
4 нед
MOSS-Audio: открытая модель для анализа аудио

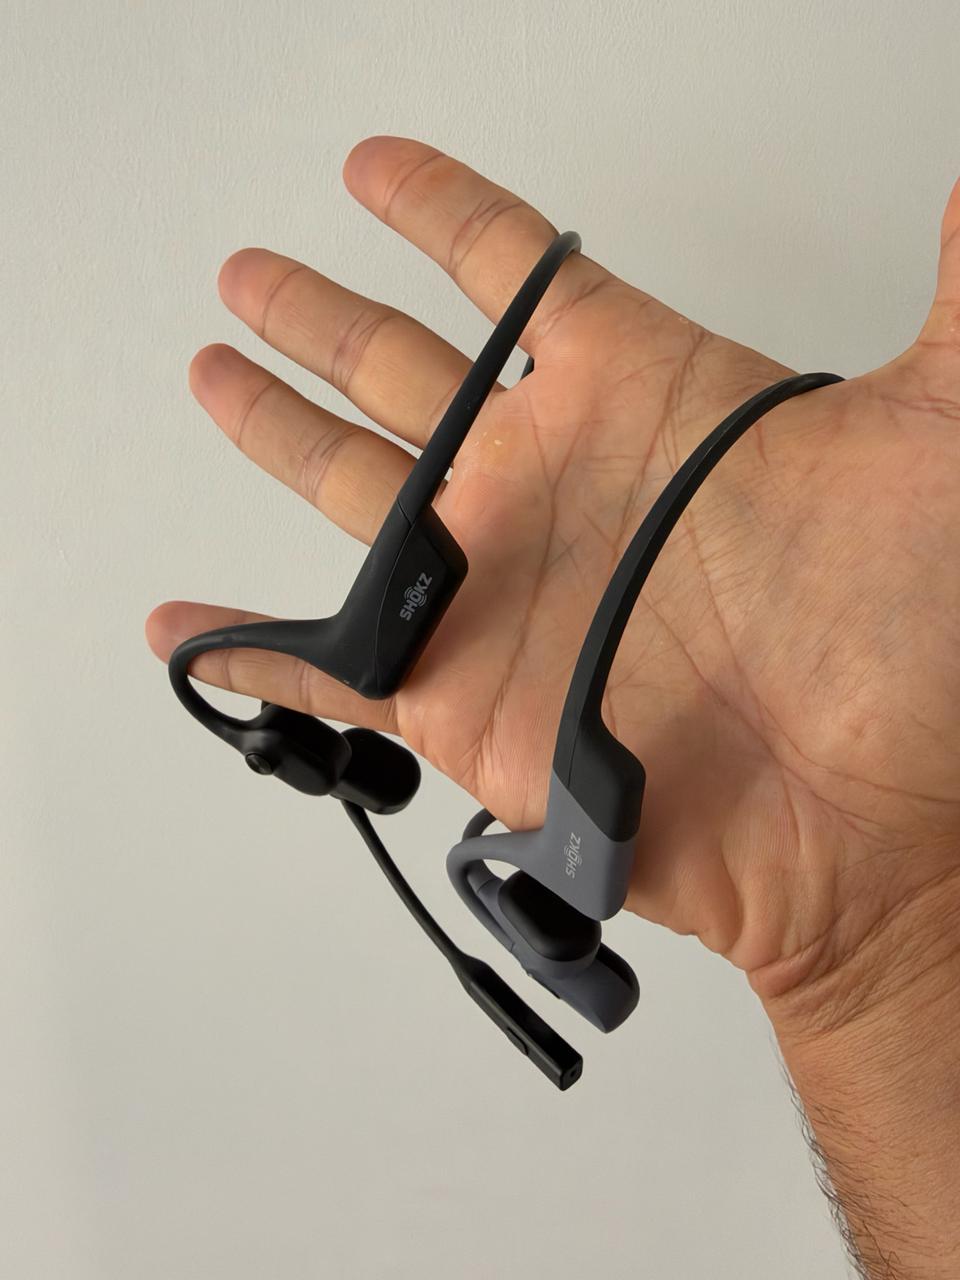
Обзор костных наушников Shokz

О@orgprogавтор про «it»
1 мес
Обзор костных наушников Shokz

Samsung Labs представила семейство аудиоязыковых моделей Samsone

Н@GreenNeuralRobotsAI-инженер
1 мес
Samsung Labs представила семейство аудиоязыковых моделей Samsone

Samsung представила Samsone — открытые аудиоязыковые модели для смартфонов

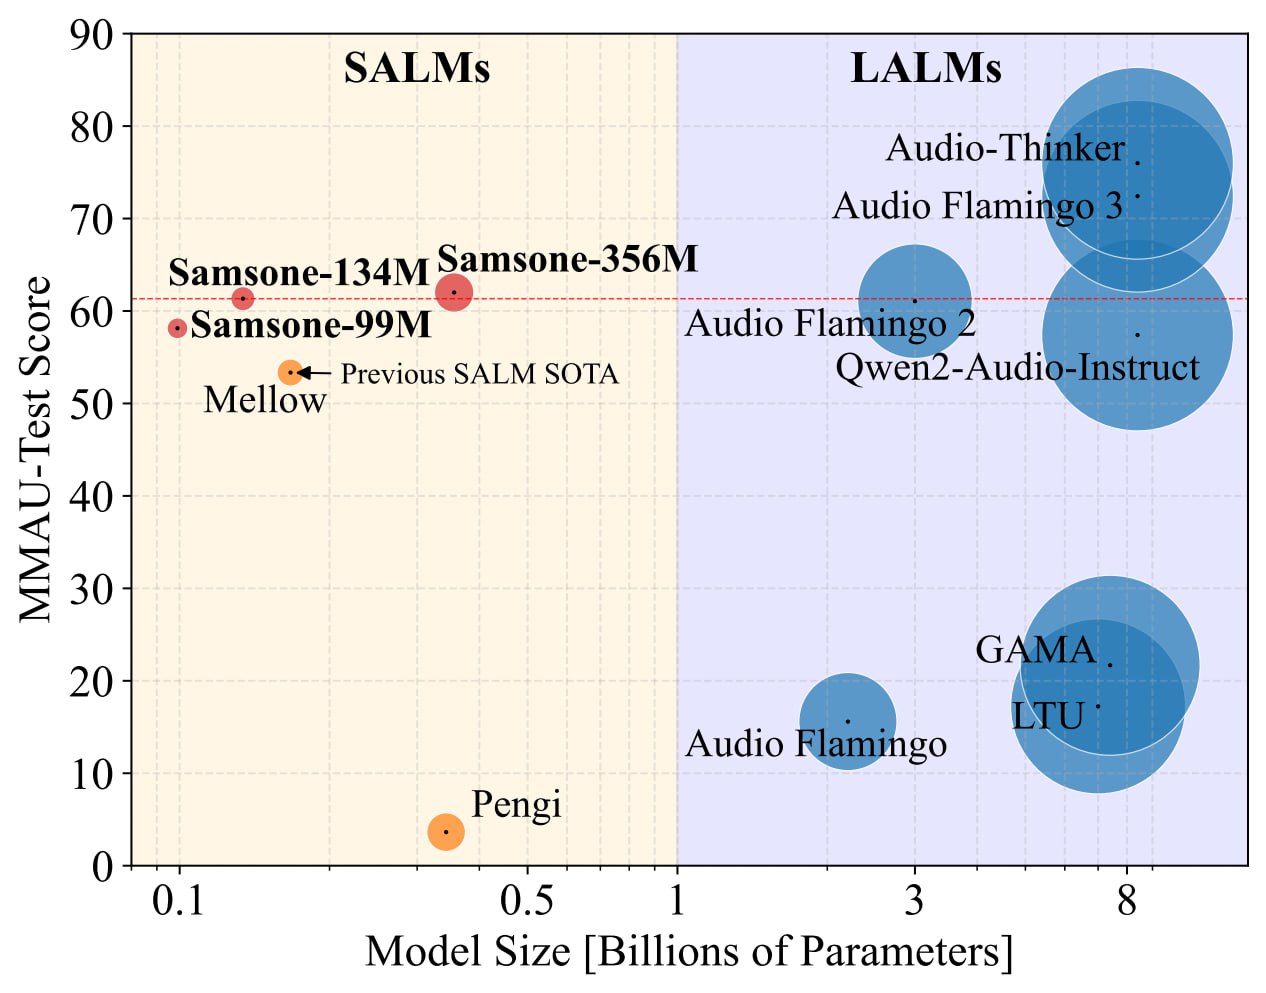
Samsung опубликовала Samsone — семейство из трёх компактных аудиоязыковых моделей (Samsone-99M, Samsone-134M, Samsone-356M), предназначенных для работы прямо на мобильных устройствах. Модели принимают аудиофрагменты вместе с текстовым запросом и отвечают текстом: описывают звук, отвечают на вопросы о записи, сравнивают клипы.

Проект будет представлен на конференции Interspeech 2026 (27 сентября — 1 октября, Сидней). Значимость в том, что небольшие модели (менее 400 млн параметров) на ряде тестов обгоняют модели-конкуренты в десятки раз крупнее, при этом работая офлайн на смартфоне с приемлемой скоростью генерации.

61,33%точность Samsone-134M на MMAU
125 токенов/секскорость Samsone-99M на Galaxy S25 Ultra
9 млнпараметры аудиоэнкодера Whisper-Tiny

Полный разбор →

Обзор инструментов для генерации музыки: MuLaCover и DiffSynth-Music

Н@GreenNeuralRobotsAI-инженер
1 мес

Запуск сервиса и API для Audio-to-MIDI Pro

М@cgeventAI-инженер
1 мес
Кому Audio-to-MIDI? Это MuScriptor от Кутай завернули в сервис и АПИ. Но код и веса по прежнему есть. Audio-to-MIDI Pro разделяет весь микс на редактируемые инструментальные партии и определяет окружающую их музыкальную структуру. Можно расшифровывать записи на сайте или интегрировать их в свой продукт через API. https://mirelo.ai/models/audio-to-midi @cgevent

Релиз семейства моделей StepAudio 3

Н@GreenNeuralRobotsAI-инженер
1 мес
StepAudio 3 Новые модели от Степана StepAudio 3 Realtime Полнодуплексная аудио-языковая модель. Говорит и слушает одновременно, размышляет вслух не замолкая китайский и английский StepAudio 3 Music Генерация песен: планирует структуру (куплеты, припев, бридж, аранжировку), создает 48-kHz стерео до 5м 30с язык задается описанием песни Помимо этого в семейство вошли говорилка с дизайном голоса Gen, TTS и ASR китайский, английский, японский, корейский, французский, испанский Voice Studio - пока только разговорная, музыка анонсирована #musicediting #dialog #asr #tts #voicedesign
Ещё ↓