нейросетиСбросить фильтр ×

Alibaba выпустила Wan Animate 2 — аниматор персонажей без скелетов и с текстовым управлением камерой

Alibaba представила Wan Animate 2 — новую версию модели для переноса движения на персонажей (motion transfer). Главное отличие от предыдущего подхода: модель теперь напрямую анализирует driving videoi (видео с образцом движения) без построения скелетов и промежуточных костылей, что снижает дрейф идентичности персонажа при сложных движениях. Модель передаёт мимику, движения рук и умеет работать с несколькими персонажами одновременно.

Ключевая новая фича — управление ракурсом камеры текстом, независимо от исходного видео: раньше камера была жёстко привязана к driver-видео, теперь её можно отвязать и задавать словами, не ломая при этом движение персонажа. По смыслу Wan Animate 2 сравнивают с конкурентом SCAIL-2: SCAIL-2 пока обкатаннее в задачах replacement и сложных multi-character сценах, а Wan Animate 2 выигрывает именно как связка motion transfer + camera control.

24 fpsзаявленная скорость streaming Lite-версии
10-stepшагов у дистиллированной версии модели
14Bразмер модели (Wan2.2-Animate-2-14B)

Полный разбор →

OpenAI сделала бесплатный ChatGPT безлимитным на модели GPT-5.6 Luna

OpenAI обновила линейку ChatGPT: бесплатные пользователи и подписчики Go получили модель GPT-5.6 Lunai по умолчанию (она заменила GPT-5.5 Instant) и безлимитные текстовые чаты — ранее дневной лимит составлял примерно 10–40 сообщений за несколько часов. Подписчики Plus и Pro получили обновлённую GPT-5.6 Soli, которая отвечает точнее, короче и реже соглашается с пользователем без оснований.

Флагманская модель линейки продолжает жить только за подпиской — безлимит распространяется исключительно на самую компактную модель Luna, что делает шаг OpenAI одновременно щедрым жестом и способом привлечь больше пользователей на бесплатный тариф.

62-68%снижение фактических ошибок у GPT-5.6 Sol
10–40 сообщенийпрежний лимит для бесплатных чатов за несколько часов

Полный разбор →

Опыт борьбы с нейроспамом в комментариях Telegram-канала

G@aiofthedayAI-инженер
2 мес
Опыт борьбы с нейроспамом в комментариях Telegram-канала

Рубрика Кейсосуббота: обмен опытом использования ИИ

S@serge_aiAI-инженер
2 мес
Рубрика Кейсосуббота: обмен опытом использования ИИ

Создание короткометражного AI-фильма «Lord of the Taiga»

М@cgeventAI-инженер
2 мес

Как десять лет назад в Яндексе создали альбом с помощью нейросети, обученной на поэзии Летова

ᴍ@acceleratethefutureмедиа / агрегатор
2 мес
Как десять лет назад в Яндексе создали альбом с помощью нейросети, обученной на поэзии Летова

Google демонстрирует новые возможности редактирования видео в Gemini Omni

М@cgeventAI-инженер
2 мес

Релиз MAGI-2: опенсорс-модель для генерации видео со звуком

Н@GreenNeuralRobotsAI-инженер
2 мес
MAGI-2 Preview Опенсорс модель для генерации видео со звуком Но... 114B параметров. Веса - я даже считать не буду сколько, >300ГБ Требуется 8 GPU NVIDIA Hopper, Python 3.2 и CUDA, ffmpeg • генерация видео из текста (T2V) • генерация видео из промта и изображения (I2V) • создание звука и его микширование с видео • два этапа генерации: денойз и рефайн • разрешение 1080p после рефайна • длительность клипов 10 секунд Гитхаб HF - выложили базовую. Ждем дистиллированную API #av #t2v #t2av #i2v #i2av #api

ByteDance разрабатывает ИИ-модель с 10 трлн параметров

v@vcnewsмедиа / агрегатор
2 мес
Китайская ByteDance начала разработку ИИ-модели, «сопоставимой» с Mythos 5, — у неё будет около 10 трлн параметров, узнало FT. Модель находится на стадии предварительного обучения — обычно этот этап занимает от трёх до шести месяцев vc.ru/ai/3067803
ByteDance разрабатывает ИИ-модель с 10 трлн параметров

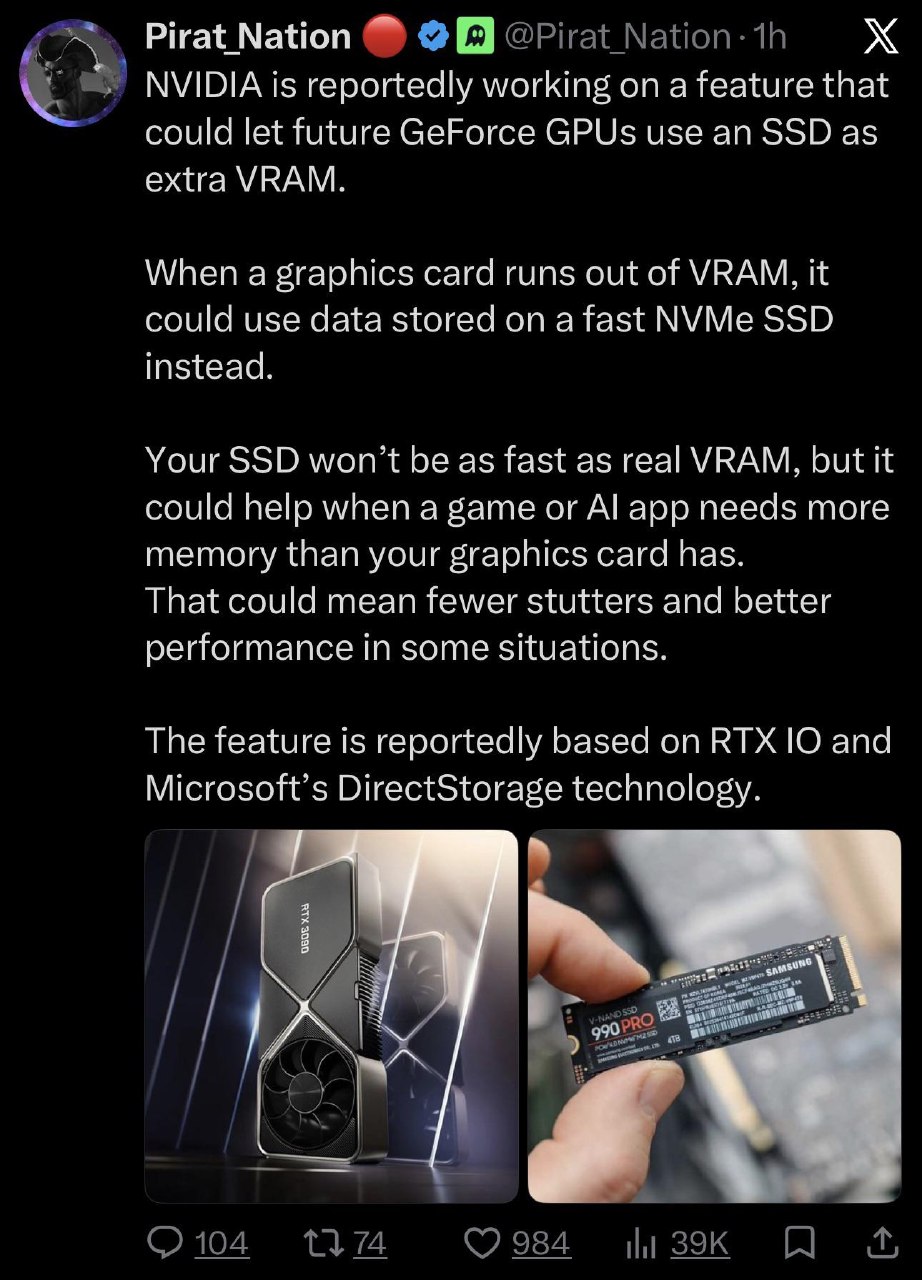
NVIDIA разрабатывает технологию расширения видеопамяти через SSD

Н@GreenNeuralRobotsAI-инженер
2 мес
По слухам, NVIDIA разрабатывает технологию использования SSD в качестве расширения видеопамяти. Это позволит запускать крупные нейросети на босяцких GPU Данные, не помещающиеся в основную GDDR7-память, будут храниться на SSD и подгружаться по требованию. Технология будет работать в связке с DirectStorage и RTX IO Энтузиасты уже создали подобный проект GreenBoost (на гитлабе адская процедура регистрации, я не осилил), который позволяет расширить память GPU за счёт SSD и RAM. Система автоматически распределяет данные: горячие слои остаются в VRAM, менее важные — в RAM, а самые редко используемые — на накопителе. #lowvram #gpu #news
NVIDIA разрабатывает технологию расширения видеопамяти через SSD

Alibaba планирует взимать комиссию с выручки за использование Qwen3.8-Max

v@vcnewsмедиа / агрегатор
2 мес
Alibaba планирует взимать долю выручки с крупных клиентов в качестве платы за использование модели Qwen3.8-Max, узнало Reuters. До этого компания брала плату только за использование своих моделей через собственную облачную платформу — большинство моделей с открытым исходным кодом клиенты могли разворачивать бесплатно vc.ru/ai/3067142
Alibaba планирует взимать комиссию с выручки за использование Qwen3.8-Max

Почему ИИ меняет мир не так, как мы ожидали

Т@yumaksавтор про «marketing»
2 мес
Почему ИИ меняет мир не так, как мы ожидали

Интеграция Scenema Audio в ComfyUI

Н@GreenNeuralRobotsAI-инженер
2 мес
ComfyUI-ScenemaAudio Авторы говорилки Scenema Audio прикрутили ее в ComfyUI • клонирование голоса без обучения • генерация речи с эмоциями и интонациями по описанию • поддержка подсказок в квадратных скобках для эффектов • минимум 8 ГБ VRAM • скорость до 2x реального времени • при первом запуске качает ~30 ГБ весов Standalone Docker/API HF ComfyUI #TTS #voicecloning #voicedesign #comfyui

Meta выпустила новую версию модели Llama

К@kratko_po_deluмедиа / агрегатор
2 мес
Пятничная версия пресс-релиза Meta, что и их модель опасная и очень умная, купите её, пожалуйста. Ждём заявлений от Grok и Mistral @kratko_po_delu P.S. Спасибо Петру Г. за вдохновение
Meta выпустила новую версию модели Llama

NVIDIA выпустила Nemotron VoiceChat — первую открытую голосовую модель с вызовом инструментов в реальном времени

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 2 мес назад

NVIDIA представила Nemotron VoiceChat — полнодуплексную речевую модель на 11B параметров, которая ведёт живой разговор без пауз и умеет вызывать внешние инструменты прямо во время диалога (поиск в интернете, календарь и другие). По данным источников, это первая открытая модель такого класса с поддержкой tool calling.

Модель позиционируется как универсальный голосовой ИИ-агент: она поддерживает естественное чередование реплик, перебивание пользователем, эмоциональную окраску речи и мультимодальные сценарии взаимодействия, а также допускает файнтюн под разные стили голоса.

11Bпараметров модели
480 мсзадержка при перебивании
550 000 часовобъём обучающей речи

Полный разбор →

Ещё ↓