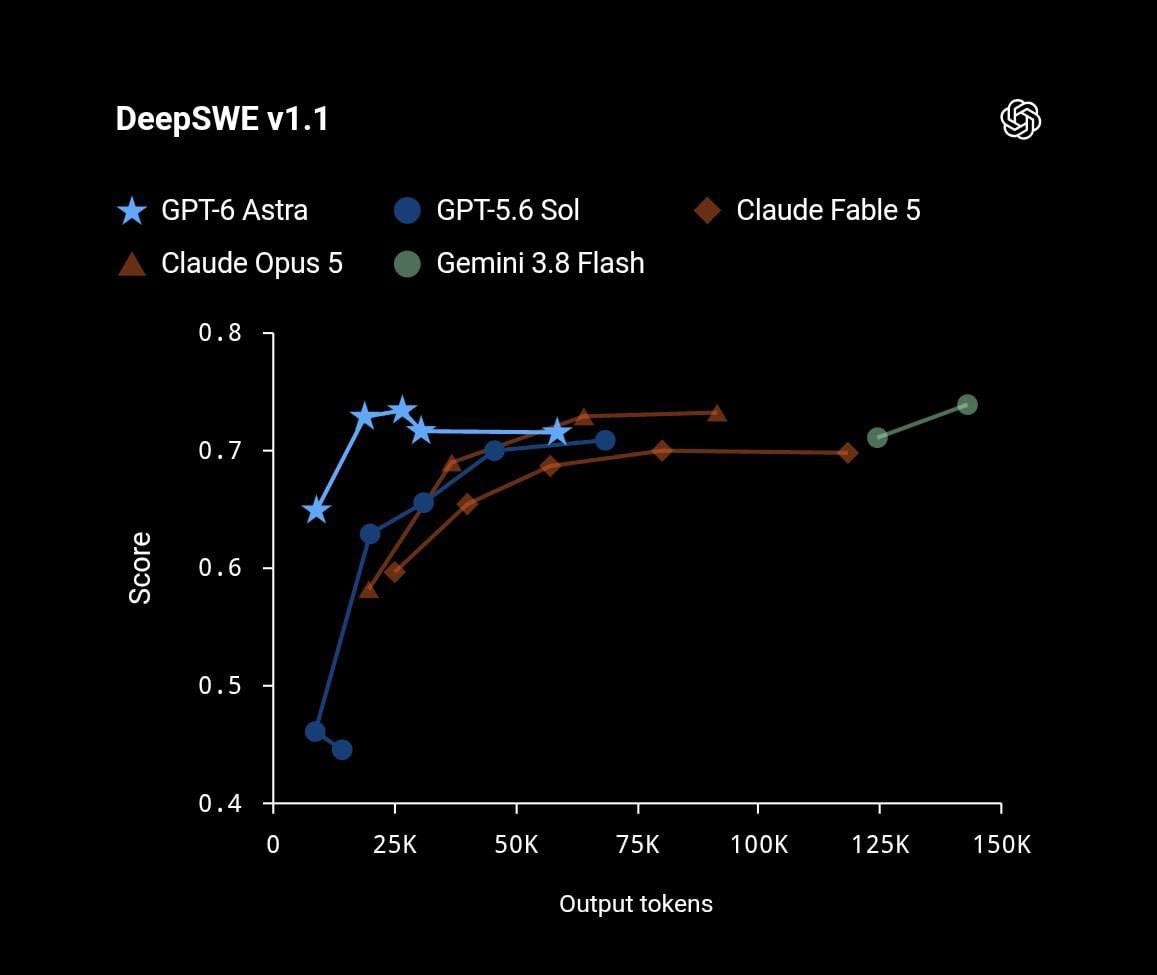
Сравнение точности моделей Astra и GPT-5.6 Sol
С@seeallochnayaAI-инженер
2 мес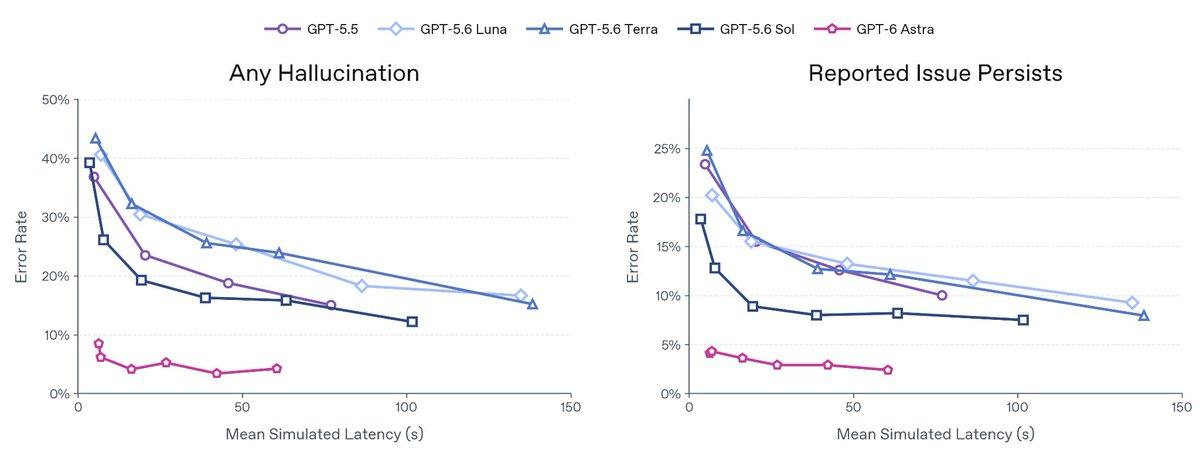
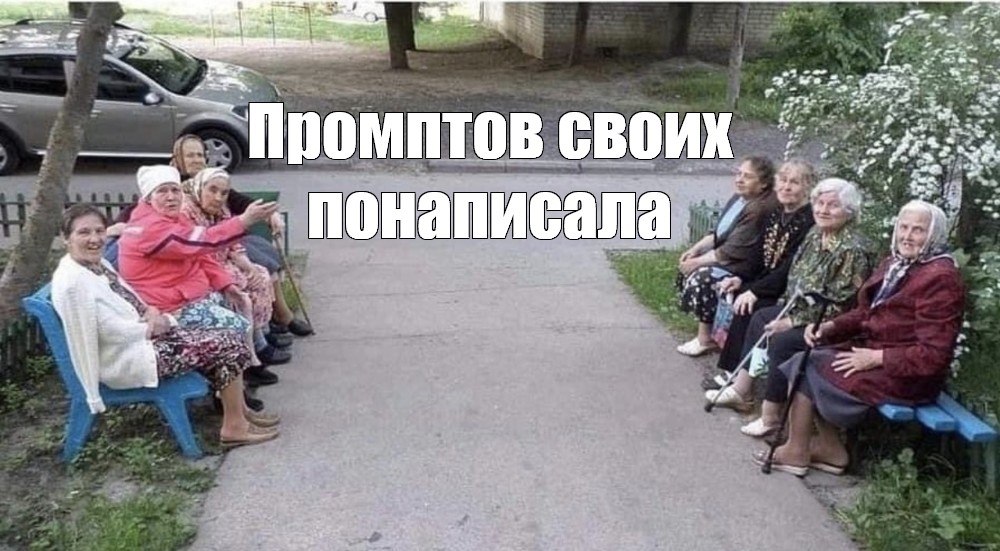
Решили мы тут написать в один российский журнал, подали статью, нам пришло замечание от редактора - мы тут проверили вашу рукопись и пришли к выводу, что вы использовали ИИ. Напишите нам объяснительную, почему и как именно вы его использовали. Всё бы хорошо, но мы не использовали ИИ! На вопрос корреспондинг автора, wtf вообще, мы не использовали, ответили - ничего не знаем, наши алгоритмы (видимо, тоже ИИ, а может, хрустальный шар) говорят, что использовали!На фото: редколлегия одного российского журнала проводит initial assessment рукописи.
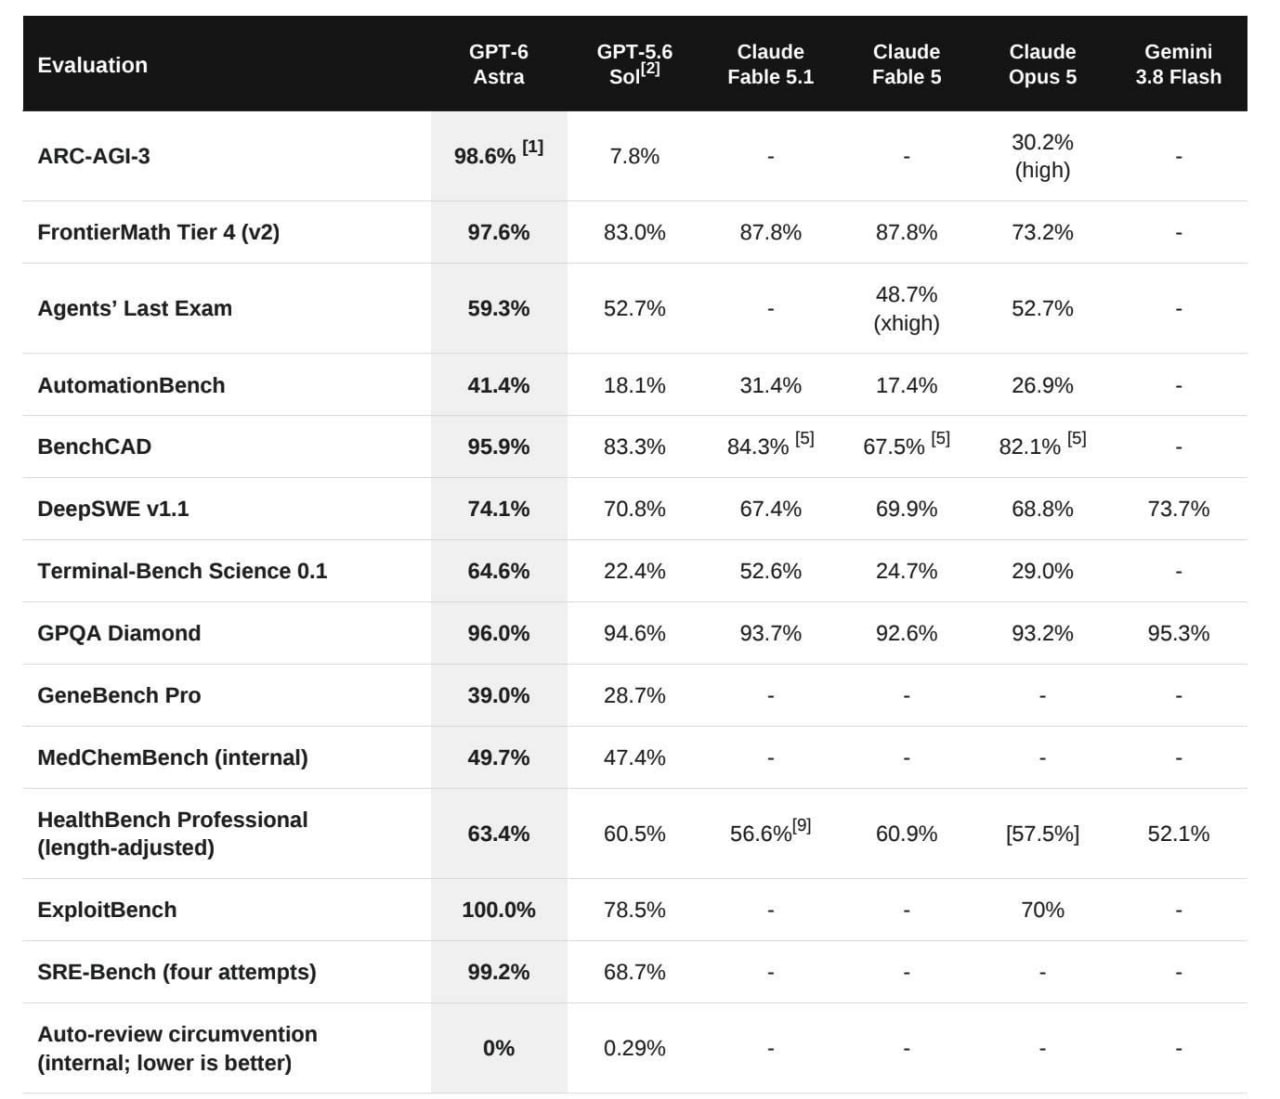
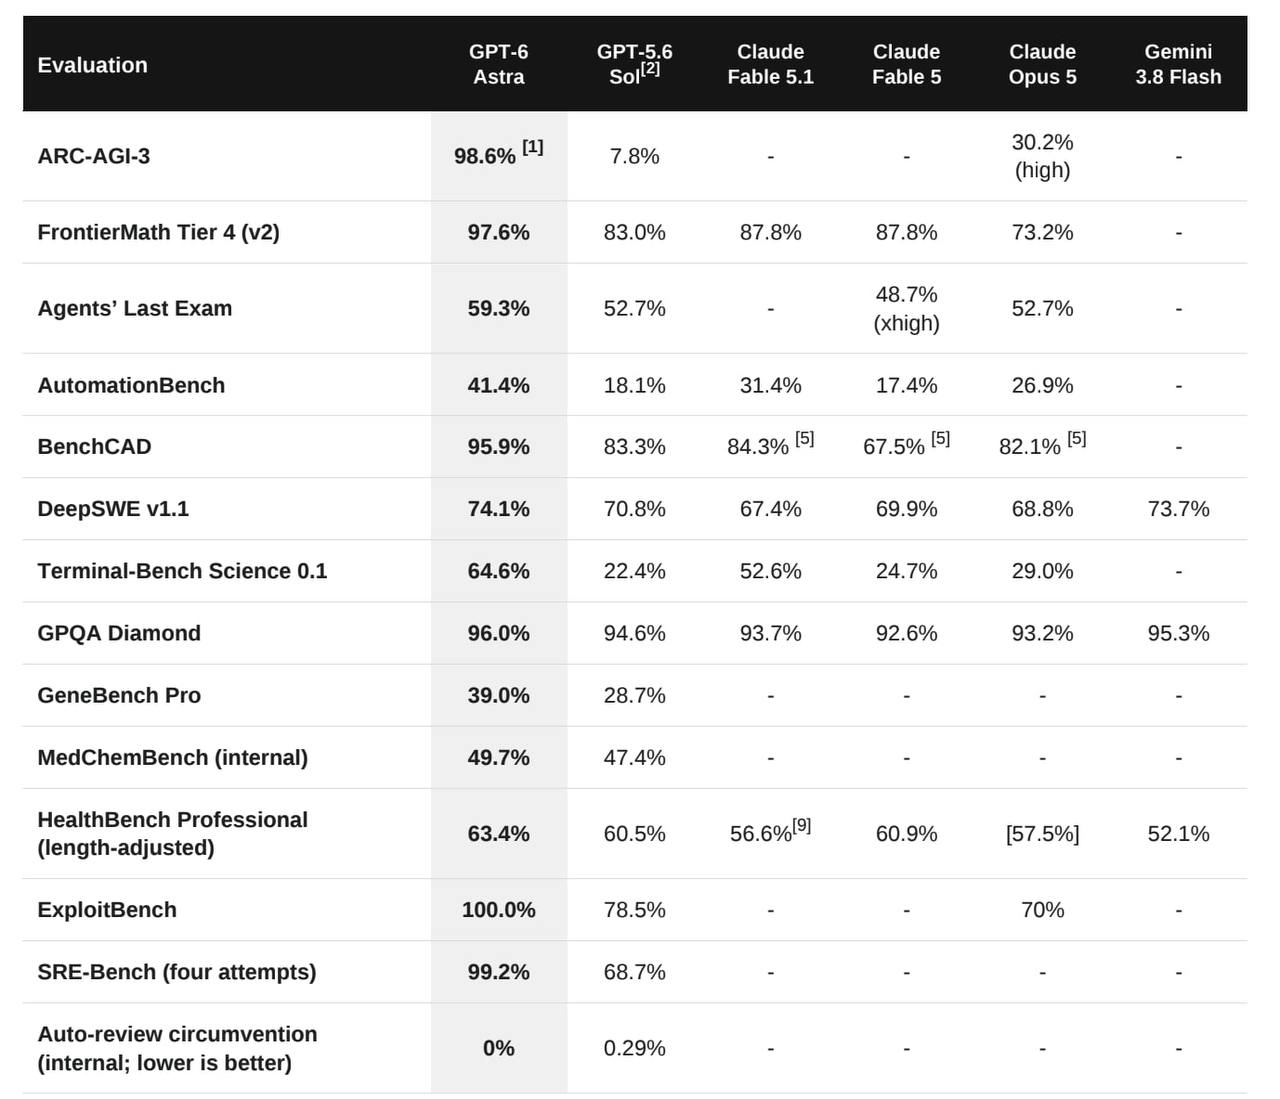
1 сентября 2026 года Anthropic представила новые флагманские модели Claude Fable 5.1 (доступна всем) и Claude Mythos 5.1 (та же модель, но с ослабленными ограничениями, выдаётся только проверенным организациям для работы в кибербезопасности и биологии, часть программ доступа — в партнёрстве с правительством США). Модели заметно обошли предыдущую Fable 5 и конкурентов в бенчмарках на кодинг, агентные задачи и науку, а чтение из кэша подешевело на 75%, что даёт экономию до 25-45% на типовых и агентных задачах.
Релиз сопровождался демонстрацией реальных научных результатов: модель спроектировала белковые соединения с аффинностью связывания в 10 раз выше существующих аналогов и построила новую карту рельефа трети Венеры по 30-летним архивным радарным снимкам NASA. Однако независимая проверка Artificial Analysis показала, что из-за возросшей многословности ответов реальная стоимость решения задачи выросла, а не упала, — что противоречит заявлениям Anthropic об экономии.
Президент OpenAI Грег Брокман заявил, что Astrai означает наступление эры AGIi (искусственного общего интеллекта), фактически произнеся «добро пожаловать в AGI».
По словам источников, если сопутствующие бенчмаркиi подтвердятся, речь идёт о качественном скачке возможностей ИИ — реакция в комьюнити крайне эмоциональная, но подробностей о самих показателях пока нет.