распознавание речиСбросить фильтр ×

Fluently выпустила бенчмарк распознавания английской речи с акцентом

R@rebrykblogAI-инженер
6 ч

Tencent представила Hy-SimulMT для синхронного перевода речи

Н@GreenNeuralRobotsAI-инженер
вчера

Mistral представила Voxtral 3 — стек для голосовых ИИ-агентов

Mistral представила Voxtral 3 — набор голосовых моделей и инструментов, который объединяет распознавание речи, обработку диалога и синтез ответа. На его основе можно создавать агентов для звонков, взаимодействия с собственными системами и выполнения задач.

Система поддерживает распознавание более чем на 50 языках и синтез речи с настройкой звучания. Её можно использовать через API или развернуть на своей инфраструктуре.

$0,0035/минраспознавание через API
$13 за миллион символовгенерация речи
$0.04 в минутуработа агента по API

Полный разбор →

Ming-3.0-audio: модели для понимания и генерации аудио

Н@GreenNeuralRobotsAI-инженер
1 нед

Татьяна Лихоманенко перешла из Apple в Anthropic

1 нед

Black Forest Labs выпустила FLUX 3 Image — единую модель генерации и редактирования изображений

Black Forest Labs представила FLUX 3 Image — модель, объединяющую генерацию и редактирование изображений в одном эндпоинте, без необходимости переключать режимы. Главные новшества: разметка объектов с помощью bounding boxesi для точечного локального редактирования, нативный рендер до 16 МП (против ~4 МП у FLUX.2) и встроенный веб-поиск для сверки визуальных деталей перед генерацией.

Модель уже доступна через API BFL, а также на Replicate, OpenRouter и Krea, коммерческие веса открыты для развёртывания на своей инфраструктуре, а открытые веса обещают «в ближайшие недели».

16 MPмаксимальное разрешение нативного рендера FLUX 3
10 референсовмаксимум изображений-референсов за запрос
$0.607цена генерации одного 4K-изображения

Полный разбор →

Обзор новых моделей и инструментов для TTS и ASR

Н@GreenNeuralRobotsAI-инженер
3 нед

LipFlow: приложение для диктовки текста по движению губ без звука

Разработчица (по данным одного из источников — Эми) создала приложение LipFlowi, которое позволяет диктовать текст без единого звука — используя только камеру, фиксирующую движения губ. Идея родилась из желания печатать текст голосом в коворкингах и библиотеках, не мешая окружающим; потенциально это может быть полезно и людям, потерявшим голос.

Приложение распознаёт беззвучную артикуляцию и переводит её в текст с помощью локальной нейросети, без отправки данных на сервер. Пока работает только на Apple Siliconi и с английской речью, доступно бесплатно на GitHub.

24 фразынужно произнести для обучения
8 минутвремя обучения модели на лице
50 на 50точность распознавания по губам

Полный разбор →

Audio8 ASR Infinite: нативная стриминговая модель распознавания речи

Н@GreenNeuralRobotsAI-инженер
3 нед
Audio8 ASR Infinite Нативная стриминговая модель распознавания речи. Декодирует 12.5 раз в секунду, память и задержка постоянны даже при 24/7 работе • Неограниченная длина аудио без дрейфа через адаптированный vLLM • Выбор аудио-часов: 80/120/160 мс, задержка 240–560 мс • Китайский и английский Гитхаб HF Демо HuggingChat #ASR MAX

Nvidia выложила в открытый доступ модель диаризации речи Nemotron 3 Diarization

Nvidia открыла веса Nemotron 3 Diarization — модели на 100 млн параметров, которая размечает аудиозаписи по говорящим: определяет, кто и когда говорил, включая моменты, когда участники перебивают друг друга. Модель работает как с готовыми записями, так и в потоковом режиме, различая до восьми собеседников — вдвое больше, чем предыдущая модель компании Streaming Sortformer.

В связке с ASRi (распознаванием речи) это даёт полную расшифровку встреч, звонков и подкастов с указанием, кто что сказал. Метки говорящих анонимны — модель не определяет личность, а только выделяет каналы speaker_X с таймкодами; привязку имён и ролей к каналам нужно реализовывать логикой конкретного приложения.

100 млнпараметров модели
8максимум различаемых собеседников
14,72%DER модели в Diarization-Bench

Полный разбор →

CocktailASR-1 от Xiaomi: распознавание речи в шумной среде

Н@GreenNeuralRobotsAI-инженер
1 мес
CocktailASR-1 (Xiaomi) Распознавание речи, #sota на мультиспикер, заявлены английский и китайский В демо распознавание одного целевого говорящего в шумной обстановке. Сначала извлекает голос конкретного человека по короткому референсу потом расшифровывает его. Остальные голоса и шум игнорируются - Двухстадийная обработка: извлечение голоса цели по референсу + ASR на чистом сигнале - Работает в шуме с несколькими говорящими — фон и посторонние голоса не попадают в распознавание - Короткий референс голоса (до 3 секунд) достаточно чтобы выделить цель Гитхаб HF Демо Спасибо @m_franz #asr VK | MAX

Microsoft представила потоковую модель VibeVoice для распознавания речи

Н@GreenNeuralRobotsAI-инженер
1 мес
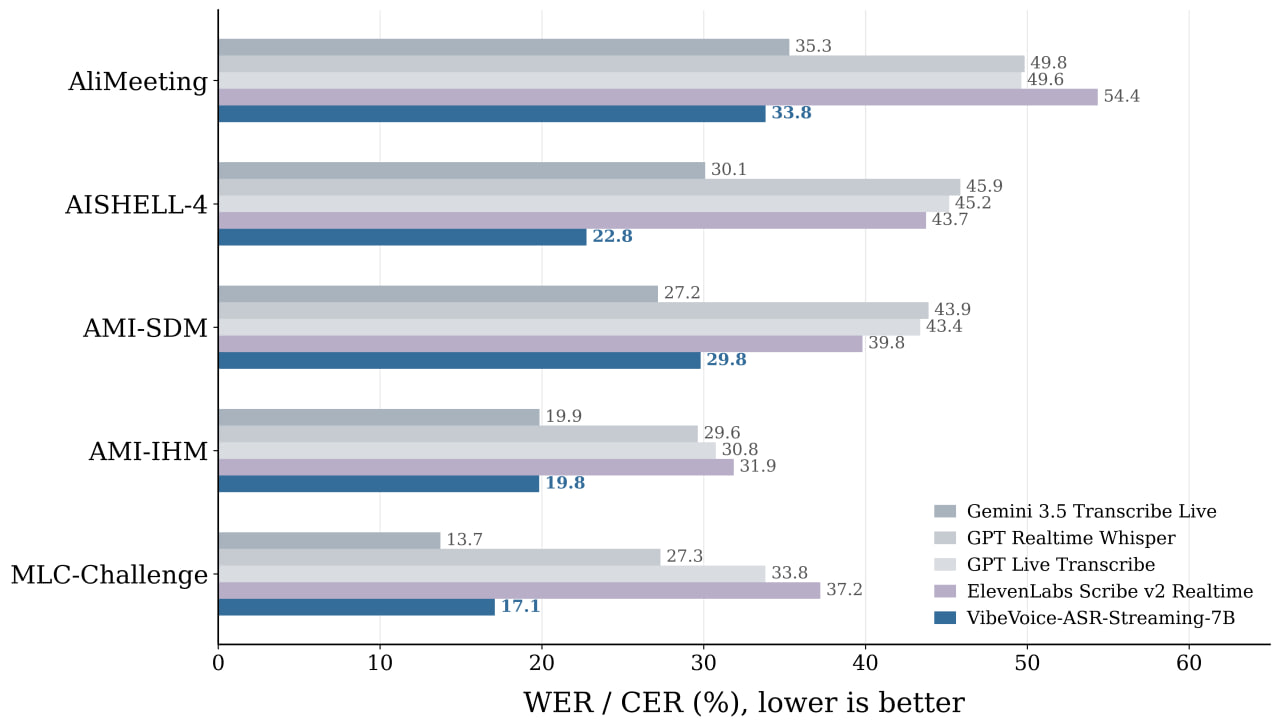
VibeVoice-Streaming ASR Потоковая модель от Microsoft транскрибирует речь по мере поступления аудио. Плюс сразу помечает, кто из спикеров что сказал. Из полезного - поддержка кастомных hotwords, то есть можно заранее задать слова и имена, которые модель должна распознавать точно (имена собственные, термины, названия компаний). Работает с 10 языками включая русский Гитхаб Попробовать #stt #asr #russian #streaming VK | MAX
Microsoft представила потоковую модель VibeVoice для распознавания речи

Meta выпустила Muse Voice Transcribe — модель для расшифровки речи в реальном времени

Meta (Superintelligence Labs) представила Muse Voice Transcribe — свою первую модель, которая распознаёт речь в реальном времени без задержек, сама разделяет говорящих (диаризацияi) и определяет конец реплики. Модель выдержала сложный тест: 20 человек в одной комнате перебивают друг друга, а кто-то переключается между языками посреди фразы.

Для разработчиков и бизнеса это означает готовое решение для транскрибации совещаний, звонков и многоязычных переговоров без сложных пайплайнов из отдельных STT- и диаризационных моделей — всё объединено в одну систему.

20говорящих в диаризации одновременно
70+языков, на которых обучена модель
25языков подтверждены на старте

Полный разбор →

ИИ-секретарь EMMA провалился в британских поликлиниках из-за акцентов

N@NeuralShitAI-инженер
2 мес

Обновление SpeakFlow 1.3.91: улучшение обработки ошибок и стабильности

S@speakfloпродакт / фаундер
2 мес

Релиз VibeVoice-ASR-BitNet для работы на CPU

Н@GreenNeuralRobotsAI-инженер
2 мес
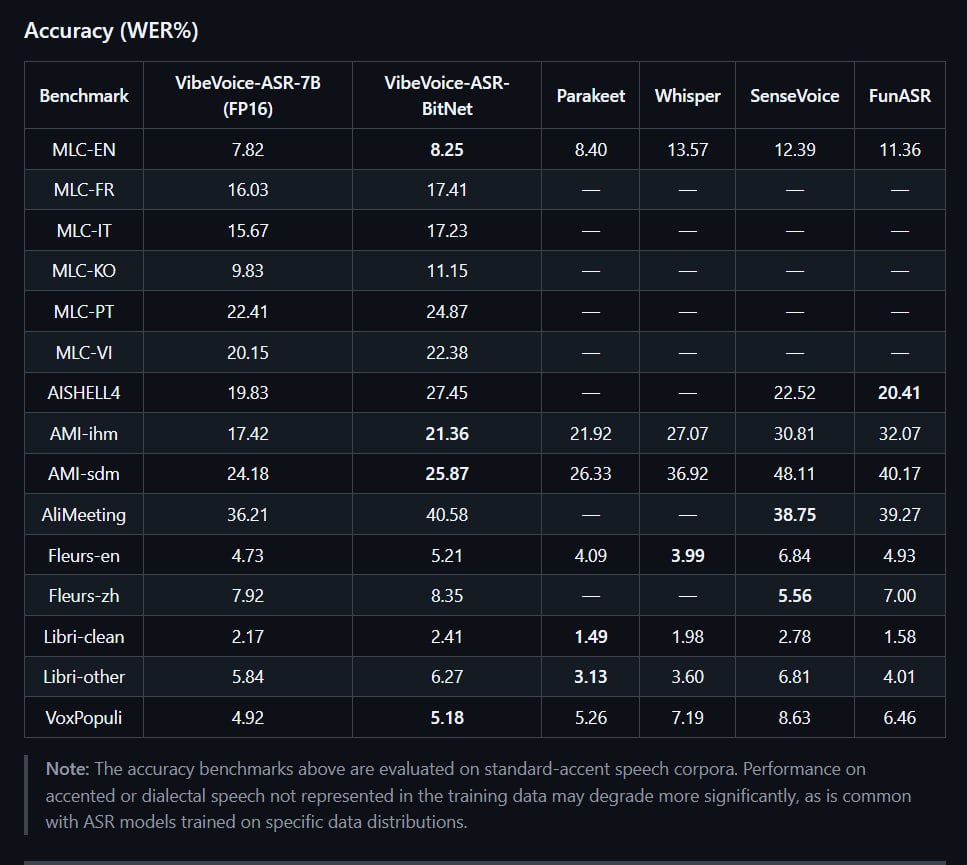
VibeVoice-ASR-BitNet Сжатая версия VibeVoice-ASR для рилтайма на CPU, не требует GPU качество ниже чем у VibeVoice-ASR-7B, зато легкий • работает на x86 (AVX2) и ARM (NEON) • поддерживает несколько языков • размер: 1.58 ГБ (сжато с 4.62 ГБ) • ускорение: в 1.6–2.3 раза быстрее Whisper.cpp Гитхаб HF Демо #asr #realtime #mobile
Релиз VibeVoice-ASR-BitNet для работы на CPU

Релиз модели Qwen-Audio-3.0-ASR-Flash

Н@GreenNeuralRobotsAI-инженер
2 мес
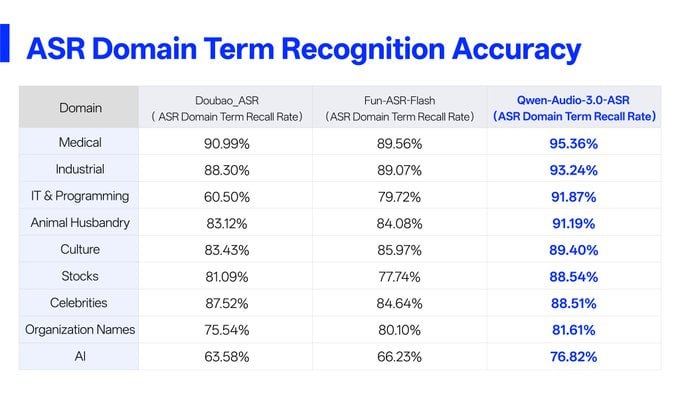
Qwen-Audio-3.0-ASR-Flash Новая коммерческая модель для распознавания речи с улучшенной контекстной осведомленностью и распознаванием терминов в разных доменах • Точное распознавание терминов в специфических областях • Поддержка пользовательских горячих слов Доступны версии: Qwen-Audio-3.0-ASR-Flash-Streaming - потоковое распознавание речи Qwen-Audio-3.0-ASR-Flash-Filetrans - распознавание записанной речи (HTTP API) Qwen-Audio-3.0-ASR-Flash - не потоковое распознавание #asr
Релиз модели Qwen-Audio-3.0-ASR-Flash

OpenAI представила модели GPT Transcribe и GPT Live Transcribe

2 мес
Ещё ↓