генерация речиСбросить фильтр ×

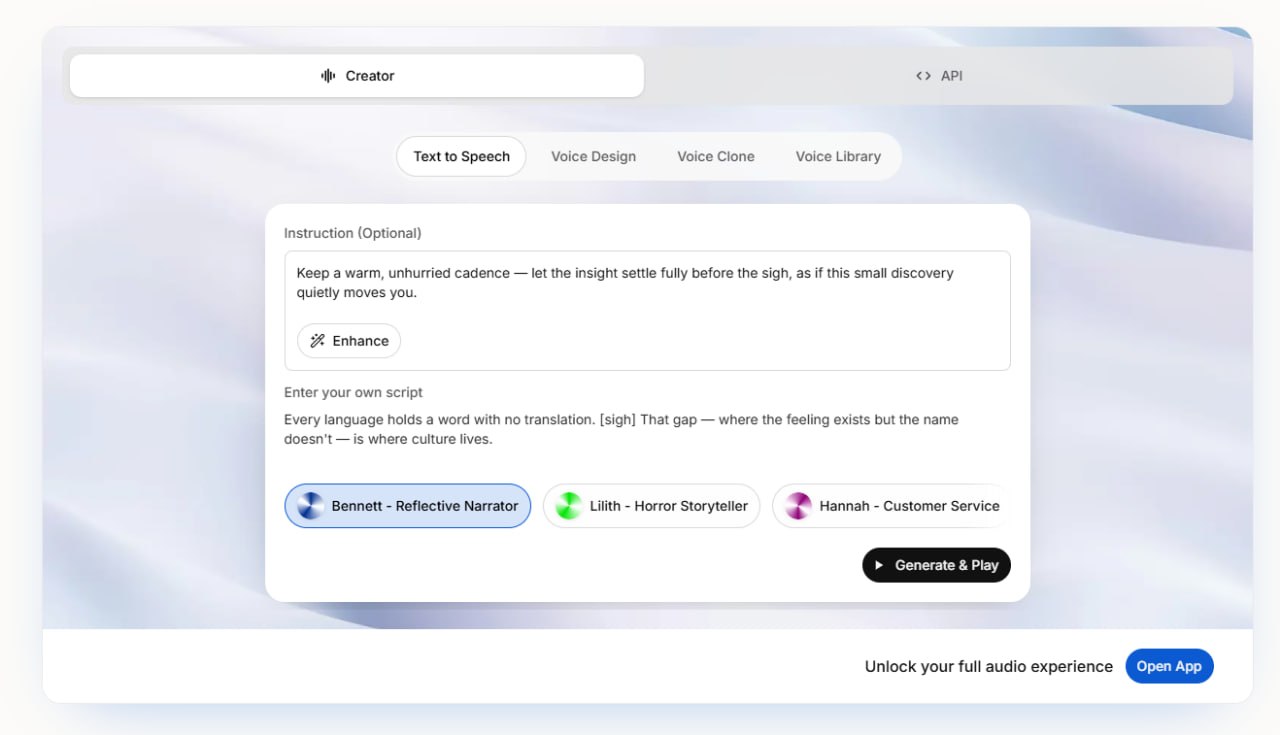
Fish Audio представила превью-модель Drama 3 для озвучки

Н@GreenNeuralRobotsAI-инженер
3 нед
Fish Audio Drama 3 Новая превью-модель от Fish Audio для речи и озвучки. Вместо жестких аудиотегов интонация, темп и характер персонажа описываются обычным текстом. • Перегенерация одного слова или фразы в готовой дорожке • Смена голоса прямо посреди предложения • Диалоги нескольких героев за один проход • Работает на русском Технически • Голос по id модели или zero-shot клонирование по референсам • Диалоги через теги <|speaker:0|>, <|speaker:1|> • Форматы: WAV/MP3/Opus, до 48 kHz Мульти-спикер-диалоги есть и в S2-семействе, не только в Drama 3 #tts #russian MAX
Suno запускает генерацию речи с фоновой музыкой

М@cgeventAI-инженер
3 нед

Google выпустила Gemini 3.8 Flash TTS и Flash-Lite TTS — модели синтеза речи с клонированием голоса

Google представила две новые модели преобразования текста в речь: Gemini 3.8 Flash TTS для творческой озвучки персонажей и Gemini 3.8 Flash-Lite TTS — более быструю и дешёвую версию для массового контента и голосовых агентов. Обе модели доступны с 23-24 сентября 2026 года через Gemini APIi, Google AI Studio и Gemini Notebook.

Главная новая функция — генерация голоса с нуля по текстовому описанию (характер, акцент, тембр) и клонирование голоса по 30-секундному образцу записи при наличии подтверждённого согласия владельца. Модели поддерживают более 100 языков и диалектов, включая русский, и содержат библиотеку из более чем 2000 готовых голосов с региональными вариантами (мексиканский испанский, квебекский французский, шотландский английский).

2000+готовых голосов в библиотеке
100+поддерживаемых языков и диалектов
30 секунднужный сэмпл для клонирования голоса

Полный разбор →

Tencent выпустила AuK — универсальную модель для генерации и редактирования речи

Tencent Hunyuan совместно с Шанхайским университетом опубликовали AuK — открытую базовую модель на 1,5 млрд параметров, которая через инструкции на естественном языке решает почти все задачи с аудио: синтез и клонирование голоса, точечную правку текста в записи (включая переписывание строк песни с сохранением мелодии), управление акустикой и эмоциями, шумоподавление, разделение голосов и извлечение вокала из музыки.

Значимость релиза в том, что вместо набора узких инструментов для TTS, voice cloning, denoising и разделения дорожек теперь предлагается одна модель с единым интерфейсом на естественном языке, доступная под MIT-лицензией с открытым кодом и весами.

1,5 млрдпараметров основной модели AuK
1,95 млн часовобъём обучающего аудио
4,5xускорение AuK-Flash относительно базовой модели

Полный разбор →

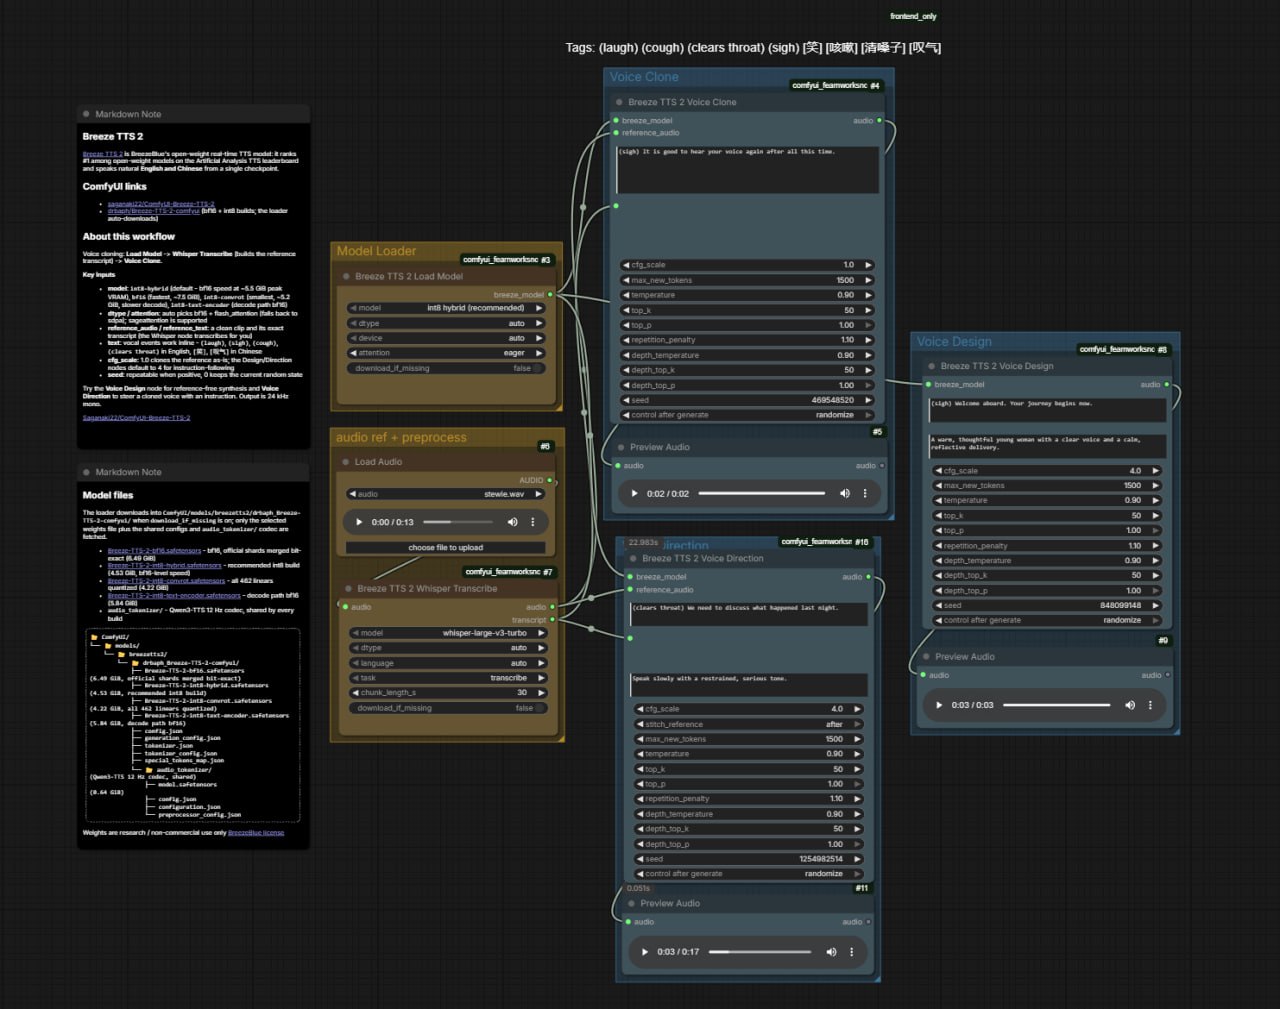
Релиз Breeze TTS 2: модель для клонирования голоса и генерации речи в реальном времени

Н@GreenNeuralRobotsAI-инженер
2 мес
Breeze TTS 2 Рилтайм говорилка - Клонирование голоса: пара секунд речи + точная расшифровка → сохранение тембра, ритма, эмоций - Дизайн голоса без референса по промпту - Voice Direction: "говори медленно, серьезно" - голос остается, подача меняется - Вокальные события в тексте: (laugh), (cough), (sigh) - Стриминг с задержкой менее 40 мс до первого аудио, генерация в 3 раза быстрее реального времени - 3B, ~7.7 GB VRAM, min 12 GB GPU - английский и китайский Гитхаб HF Попробовать Демо Спасибо @m_franz #TTS #VOICECLONING #VOICEDESIGN VK | MAX
Релиз Breeze TTS 2: модель для клонирования голоса и генерации речи в реальном времени

Интеграция Scenema Audio в ComfyUI

Н@GreenNeuralRobotsAI-инженер
2 мес
ComfyUI-ScenemaAudio Авторы говорилки Scenema Audio прикрутили ее в ComfyUI • клонирование голоса без обучения • генерация речи с эмоциями и интонациями по описанию • поддержка подсказок в квадратных скобках для эффектов • минимум 8 ГБ VRAM • скорость до 2x реального времени • при первом запуске качает ~30 ГБ весов Standalone Docker/API HF ComfyUI #TTS #voicecloning #voicedesign #comfyui

Это всё на сейчас.