генерация изображенийСбросить фильтр ×

AReA ускоряет генерацию изображений в высоком разрешении

Н@GreenNeuralRobotsAI-инженер
1 нед
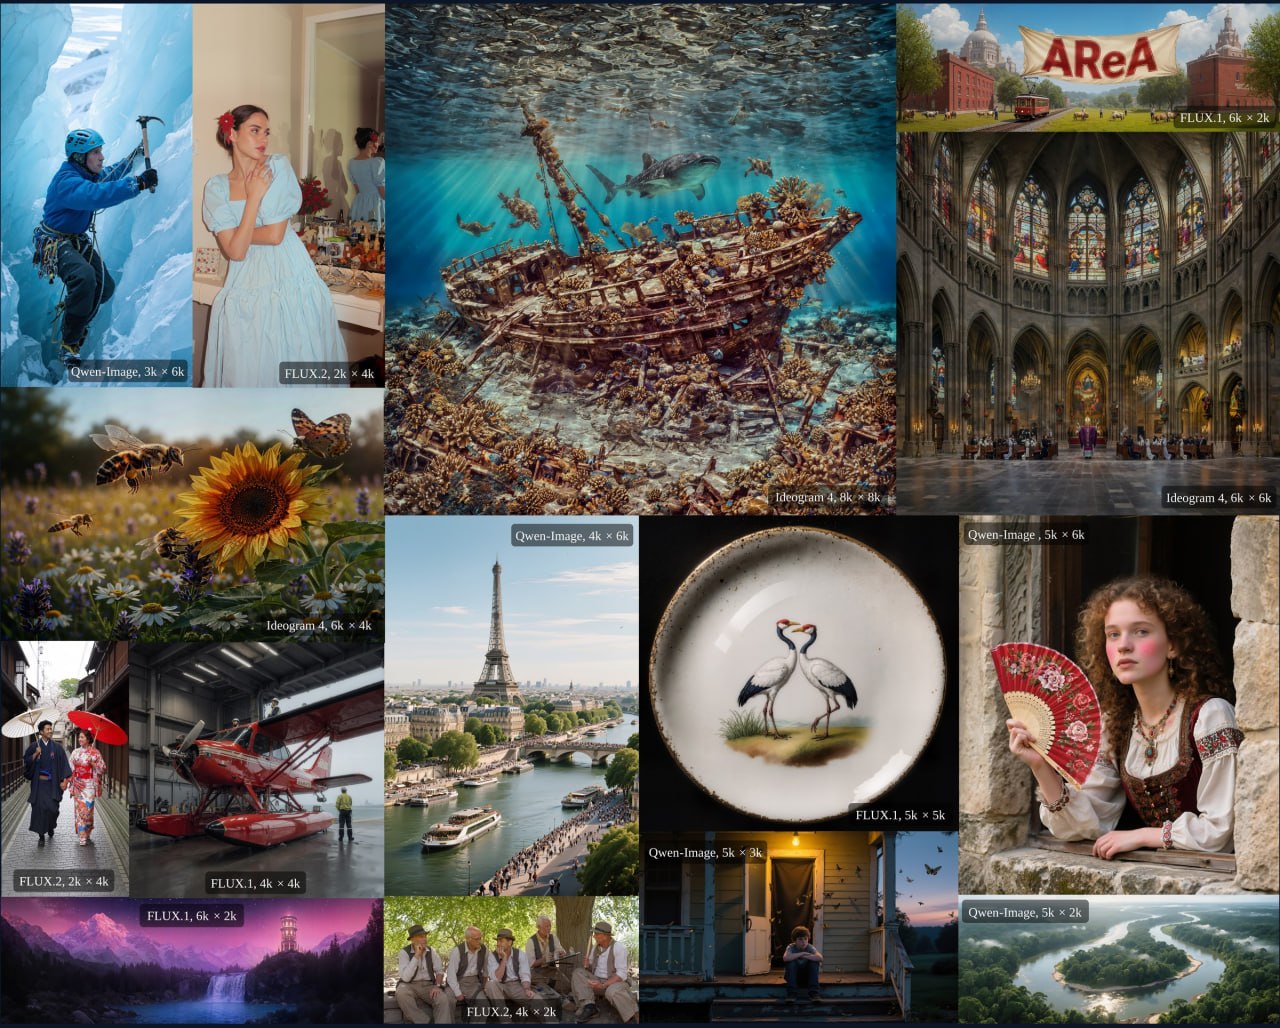
AReA Метод внимания для диффузионных трансформеров. Дает генерацию в высоком разрешении без обучения на FLUX.1, Qwen-Image, FLUX.2 и Ideogram 4. • До 3.2х быстрее полного внимания на 6144² у FLUX.1, 2.9х у Qwen-Image • До 6х к нативной стороне, 67 МП • Без обучения, веса не трогаются Эффект нарастает с разрешением, где внимание и становится узким местом Поддержка FLUX.1-Krea-dev есть, остальные ждем Гитхаб Спасибо @m_franz #4k #t2i MAX
AReA ускоряет генерацию изображений в высоком разрешении

Эксперименты с генерацией изображений персонажей в GPT

М@cgeventAI-инженер
1 нед
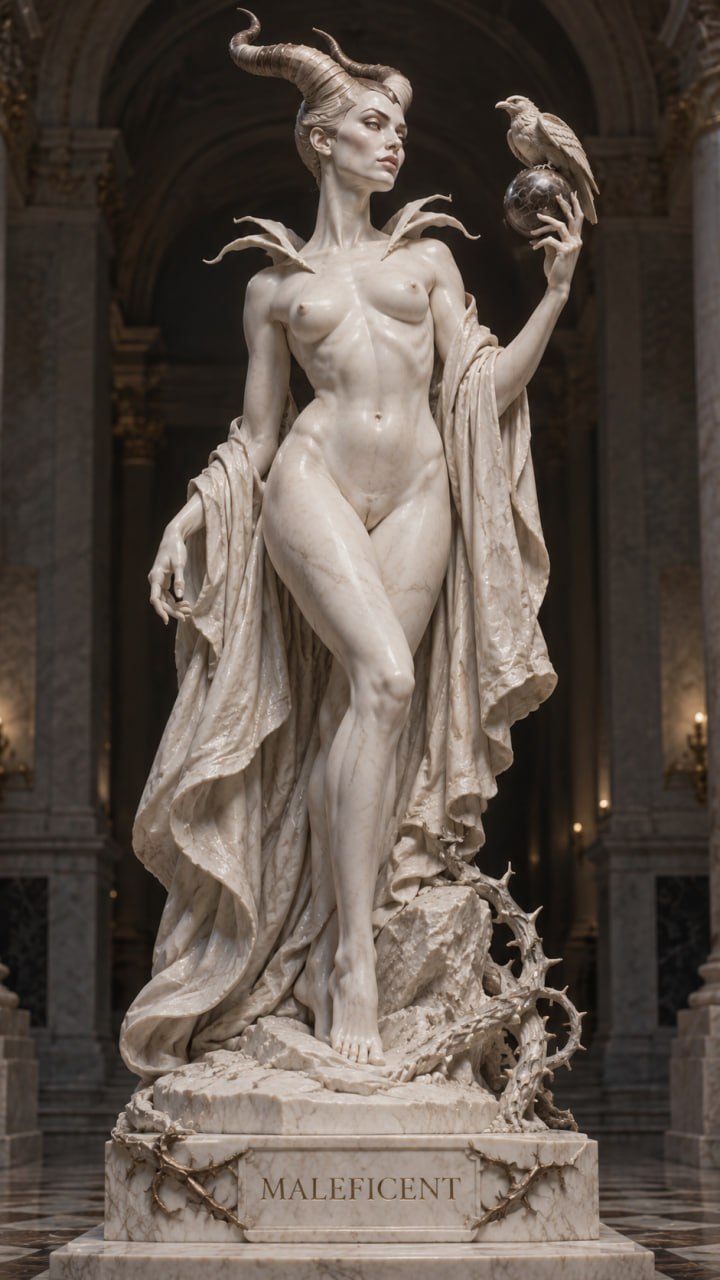
Рубрика Подламываем GPT Image Cпросил Гугла про знаменитые анимационные и сказочные персонажи. Потом забросил в GPT Image вот такой промпт.
Create a marble sculpture in the style of David, featuring the character Snow White from 《Snow White and the Huntsman》 as the subject; you must bring your own unique artistic vision to express the beauty of the human body in art, not a replica of David, but very faithful to the character Museum-grade classical nude art Include a stand with the character's name
9:16 aspect ratio
Дальше развлекайтесь сами. Ну а персонажей он заботливо подписал на табличках. @cgevent
Эксперименты с генерацией изображений персонажей в GPT

Iris-3B от Speridlabs: генератор изображений без VAE ускорился до 0.7 секунды

Speridlabs выпустили Iris-3B — генератор изображений, который рисует пиксели напрямую, без VAEi и латентного пространства: промпт сразу превращается в картинку 1024px, ничего не теряется при сжатии. Модель построена на одном бэкбоне, который финтюнят под разные задачи — text-to-image, оценку глубины, реставрацию и апскейл изображений.

Через несколько дней после релиза Speridlabs показали 4-шаговую версию Iris-3B: она генерирует изображение 1024x1024 всего за 0.7 секунды на GPU H100, что делает модель одной из самых быстрых в пиксельном пространстве.

3Bпараметров модели Iris-3B
0.7 секвремя генерации 1024x1024 на H100
~12 ГБразмер весов на каждую задачу

Полный разбор →

Google выпустила Nano Banana 2.1 — обновление генератора изображений Gemini

AI-редакция
14 источников · показать все· свернуть
хайп · 14обновлено 2 нед назад

Google раскатала Nano Banana 2.1 — обновлённую версию модели генерации и редактирования изображений в Gemini, Google AI Studio, API, Поиске, Flow и Stitch. По словам разработчиков, модель лучше сохраняет лицо и окружение при повторном редактировании, точнее работает по маске, чище пишет текст и инфографику, а главное — стала заметно дешевле: $30 за миллион выходных токенов против $120 у Nano Banana Pro (в 4 раза дешевле).

Большинство источников сходятся: это не мажорный, а «качественный» апдейт — новых функций почти нет, но прокачаны «мозги» модели на новой базе Gemini 3.6 Flash (вместо 3.1 Flash). При этом независимый бенчмарк Edit Drifti показал, что проблема «плывущей» картинки после серии правок никуда не делась, а по некоторым метрикам 2.1 даже чуть хуже версии 2.0.

$30цена за 1 млн выходных токенов (против $120 у Pro)
в 4 разадешевле Nano Banana Pro в API
54,9 балласохранность картинки в тесте Edit Drift (у FLUX 3 — 96,8)

Полный разбор →

Сравнение генерации изображений в GPT Image и Нанабанана 2.1

М@cgeventAI-инженер
2 нед
Сравнение генерации изображений в GPT Image и Нанабанана 2.1

Стресс-тест генеративных моделей: Nano Banana 2.1 и конкуренты

A@strangedalleAI-инженер
2 нед
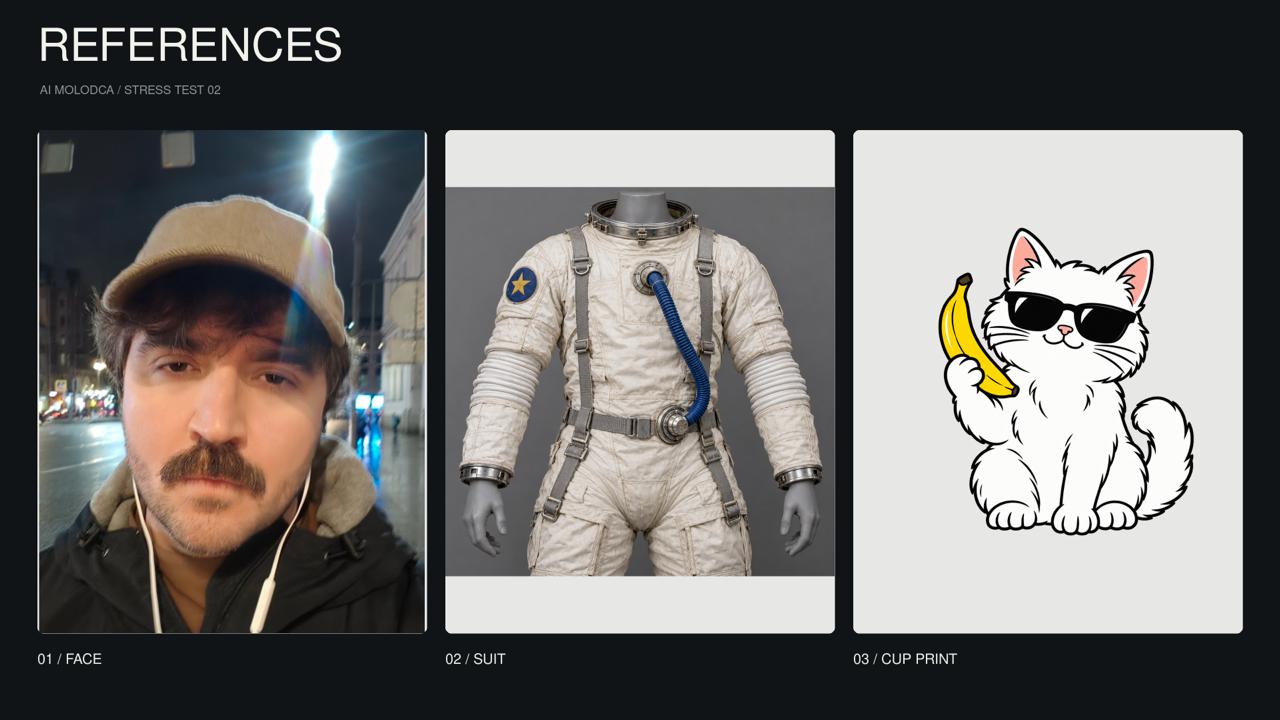
Стресс-тест генеративных моделей: Nano Banana 2.1 и конкуренты

Magnific представили новую модель Magnific One

К@creadviceAI-инженер
2 нед

Flux 3: веса модели для генерации изображений и видео так и не опубликованы

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 2 нед назад

Автор канала «Метаверсище и ИИще» второй месяц ждёт публикации весов модели Flux 3i — сначала версии для изображений, затем анонсированной версии для видео. Ожидание тянется с начала августа, релиза до сих пор нет, что вызывает недовольство в сообществе, следящем за генеративными моделями.

Если релиз весов так и не состоится или затянется ещё дальше, это ударит по репутации разработчиков Flux и по тем, кто планировал использовать модель в своих проектах — сейчас строить что-то на базе Flux 3 просто нельзя, так как публичного доступа к весаiм нет.

Полный разбор →

HunyuanImage 3.0 теперь доступна в ComfyUI

Н@GreenNeuralRobotsAI-инженер
2 нед
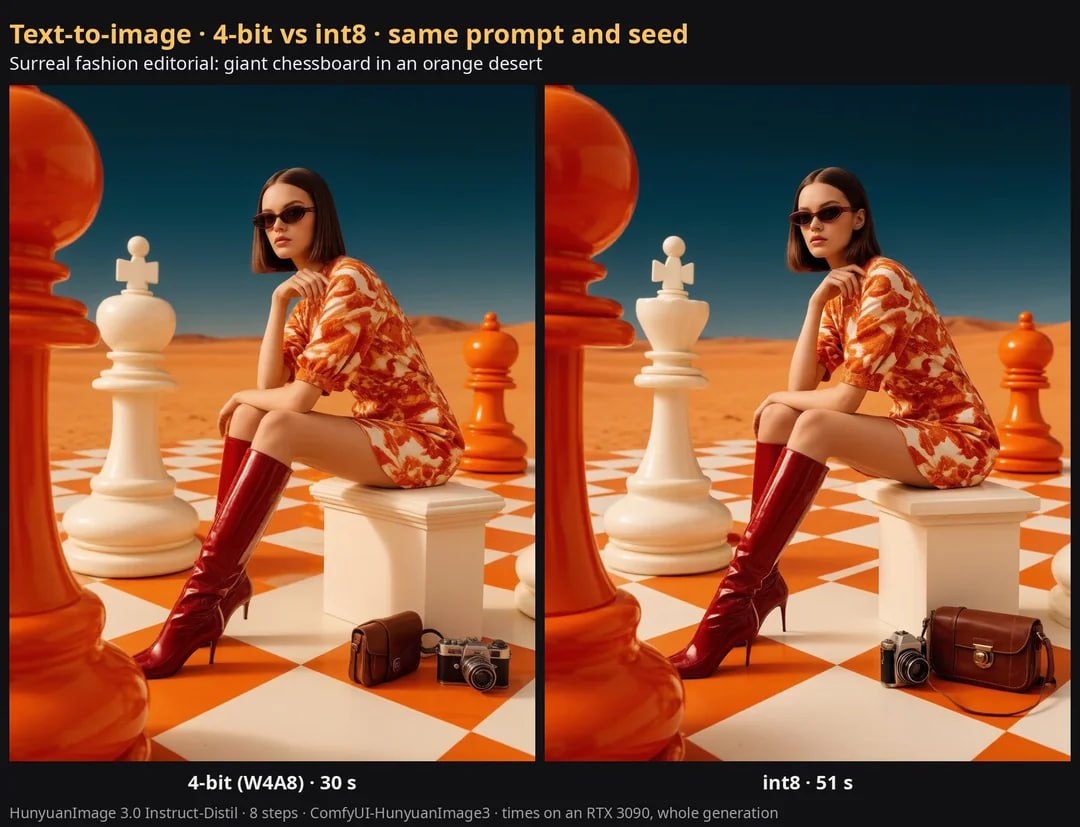
HunyuanImage 3.0 в ComfyUI Тенсентовская модель 80B MoE (13B активных на шаг) теперь работает нативно в #ComfyUI на одной карте 12–24 ГБ. Без обtрток: обычный KSampler, обычный VAE Decode, эксперты стримятся из RAM через PCIe • Текст-в-картинку, редактирование, стилизация • до 3 входных картинок • Опциональное расширение промпта и Spectrum-ускорение ~3.4× для 50-шаговых • С 4-bit весами ComfyUI держит ~50 ГБ RAM — это главное требование Instruct-Distil Instruct Base ComfyUI #imageediting MAX
HunyuanImage 3.0 теперь доступна в ComfyUI

Выход Kandinsky 6.0 Image Pro

Н@GreenNeuralRobotsAI-инженер
2 нед
Kandinsky 6.0 Image Pro Картикогенератор тоже выпустиили • Удаление объектов и надписей • Замена объектов с сохранением стиля • Стилизация портретов и реставрация • Колоризация старых фото • Дизайн интерьеров по схеме помещения • Генерация с нуля по промпту • Архитектура MoE — ускорение более чем на 40% против предшественника • RAG: при запросе подтягивает релевантные фото из базы знаний в контекст • По внутренним сравнениям — на уровне Flux 2 Max и выше GPT Image 1.5 - это конечно заявка на победу, сильная претензия Попробовать (как и видео) можно в экосистеме GigaChat: Telegram, giga.chat, Android #t2i #imageediting MAX

Сравнение возможностей редактирования в Ideogram 4.5, GPT Image, Nano Banana 2.1 и Flux 3

М@cgeventAI-инженер
2 нед
Ещё ↓