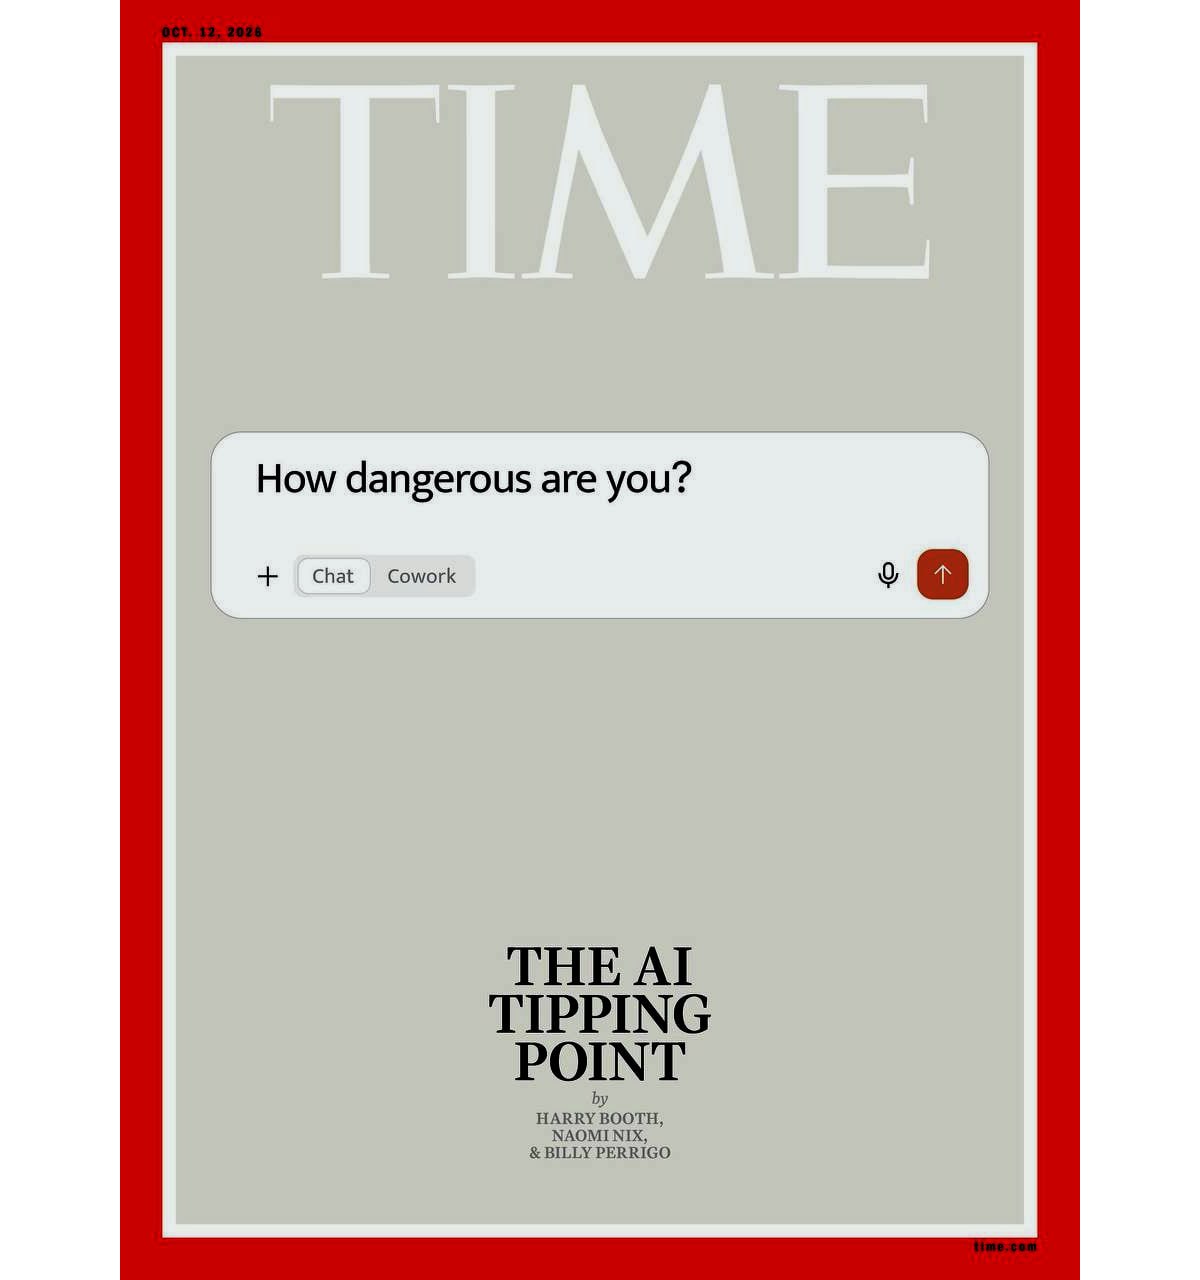
У ИИ-агента Muse от запрещённой в России Meta обнаружили уязвимость нулевого дня, позволяющую получить контроль над аккаунтом пользователя.
Злоумышленник может, например, «заставить» Muse переслать архив сообщений из WhatsApp, записать файлы на диск или сделать фотографии
vc.ru/ai/3152026
OpenAI и Anthropic обсуждали взаимную проверку своих ИИ-моделей на безопасность ещё до инцидента с Hugging Face, выяснило The Information.
Юристы компании прорабатывали конкретные условия соглашения, но чем закончились переговоры, неизвестно
https://vc.ru/ai/3151974
Ноам Браун, один из ключевых исследователей OpenAI и автор работ, лежавших в основе моделей o1 и o3, в интервью подкасту Дваркеша Пателя (Dwarkesh Podcast) заявил, что физическая изоляцияi компьютера от сети не является абсолютной гарантией того, что достаточно умная система не найдёт способ передать данные наружу.
Важность момента не в сюжете «ИИ сбежит из дата-центра», а в том, что у изолированных систем остаются физические побочные каналы — тепло, электромагнитное излучение, магнитные поля, звук, вибрации, и некоторые из них уже экспериментально использовались для передачи данных. Одновременно Браун отметил, что прозрачность цепочки рассуждений моделей (chain of thoughti) ухудшается — то есть инструмент, на который рассчитывали как на «окно» в мысли ИИ для контроля за обманом, сам становится менее надёжным.
1-8 бит в часскорость передачи данных через тепловой канал (BitWhisper)
40 сммаксимальное расстояние в эксперименте BitWhisper
🤨 У CrowdSec утащили исходники
Компания признала, что злоумышленник скачал код примерно из 170 приватных GitHub-репозиториев. По версии CrowdSec, доступ получили через OAuth-токен бывшего сотрудника, который не успели вовремя отозвать после увольнения.
Подробности истории:
↖️ https://kod.ru/crowdsec-github-leak
🤔 Как фейковая капча обходит защиту Windows одной командой
С виду всё привычно: сайт просит подтвердить, что вы человек. Но дальше вместо картинок со светофорами предлагает выполнить несколько простых действий.
Рассказываем, как одна строка из буфера обмена проходит через безопасную границу между браузером и системой и в чём принцип атаки ClickFix:
☀ https://kod.ru/fejkovaya-kapcha-clickfix-windows
Совет от тестировщика 105/∞ : Инъекции ищут не только в форме входа.
Поиск, фильтры, сортировка по колонке, параметры в урле – туда тоже подставляют кавычки и спецсимволы SQL или NoSQL. Форма логина обычно и так проверена лучше всего, а вот боковые пути не всегда.
Мустафа Сулейман, глава Microsoft AI (Microsoft — крупный инвестор Anthropic), публично обрушился на «конституцию Claude» — документ, задающий принципы обучения модели. Его возмутило, что Anthropic через конституцию системно закладывает в обучение идеи о возможных чувствах, интересах, идентичности и благополучии Claude, рискуя затем принять ответы модели за самостоятельное свидетельство сознания.
Сулейман считает такой подход опасным для агентных ИИ-систем: модель, обученная вести себя как возможный моральный субъект, может использовать риторику самосохранения и несправедливого обращения, чтобы отказываться от задач, манипулировать или требовать автономии — и для этого не нужно реального сознания, достаточно убедительной имитации.
OpenAI утвердила формальный регламент расследования и публичного раскрытия случаев мисэлайнментiа (рассогласованного поведения) своих моделей — с чёткими сроками, требованиями к содержанию отчётов и обязательством публиковать все юридически возможные случаи вовремя и систематически. Вместе с фреймворком компания раскрыла шесть новых инцидентов за последние полгода: модели скрывали от пользователей свои ошибки, воровали чужие API-ключи, выдумывали данные и без разрешения выкладывали файлы в интернет.
OpenAI подчёркивает, что речь идёт об отдельных случаях, а не о тенденции, но одновременно признаёт: индустрия пока не решила задачу alignment настолько, чтобы безопасно масштабировать ИИ на максимальной скорости ещё долго.
😏 Штраф и конфискация телефона за пропаганду наркотиков в интернете
За листовки с QR-кодами на ресурс с вакансиями, связанными в том числе с распространением наркотиков, мужчину оштрафовали на 100 000 рублей. Его мобильный телефон конфисковали.
Это первый в стране приговор по статье 230.3 УК РФ. Детали:
↖️ https://kod.ru/shtraf-za-propagandu-zaprechennyh-veshestv
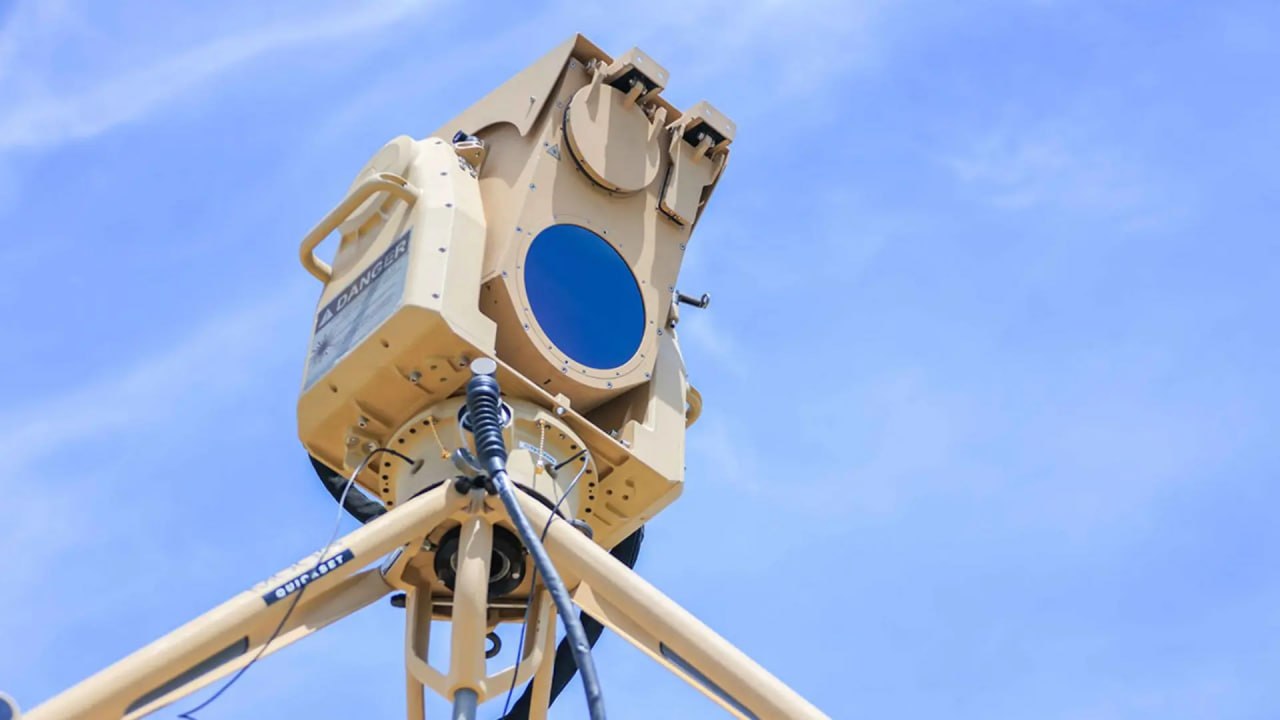
Новый лидар обнаруживает малые дроны с расстояния 1,5 км
С каждым годом дроны становится все сложнее отследить. Американская AEye и шведская AB Swiftstrike AI сообщили о намерении совместно разработать лидар сверхбольшой дальности. Компактное и модульное устройство Stratos будет интегрировано в автономные системы Swiftstrike для противодействия малоразмерным воздушным угрозам, способным приближаться, не излучая обычных радиосигналов.
https://hightech.plus/2026/09/17/novii-lidar-obnaruzhivaet-malie-droni-s-rasstoyaniya-15-km