🎦 Про сериалы
Ушла эпоха, Netflix перешел со своих мегамудреных рекомендательных алгоритмов на ллмки и предлагаю посмотреть почему — может быть вам отзовется для ваших проектов на работе.
Раньше ранжированием занималась классическая дискриминативная модель, которую годами обвешивали тысячами вручную сконструированных фичей, их кросс-взаимодействиями и отдельными архитектурами под каждую задачу, а теперь будет внутренняя ллм.
🤔Почему?
Старый стек перестал успевать за бизнесом. Чтобы добавить новый тип контента (игры, лайвы, подкасты) или новую поверхность в интерфейсе, приходилось переделывать фичи, архитектуру, инфру и заново гонять эксперименты. LLM же уже знает мир и умеет понимать контент, так что эти способности не нужно строить с нуля. Кроме того, рекомендациями можно управлять промптом, а не обучать под каждый кейс новую модель.
🇹🇱 Кратенько про архитектуру
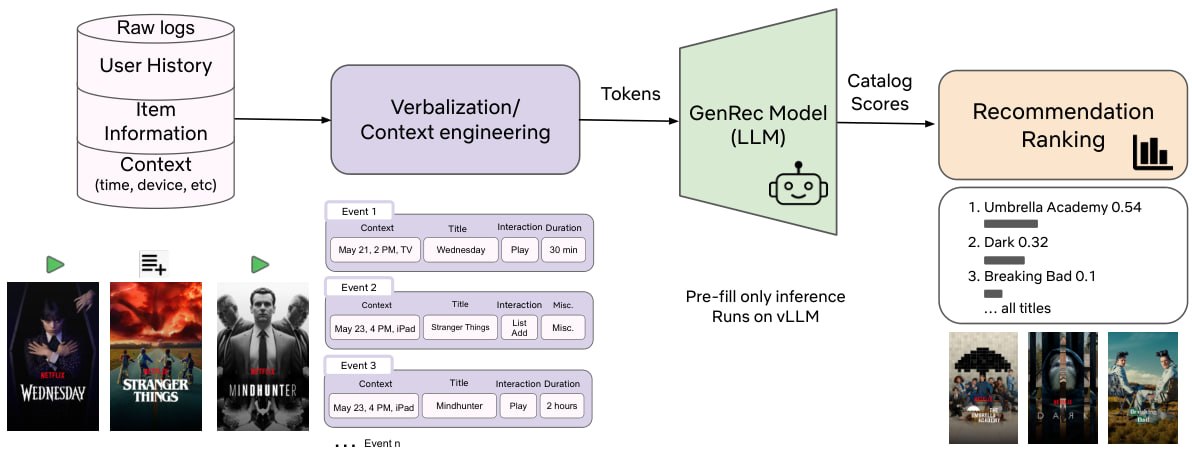
Обучение идёт в две фазы. Сначала open-source LLM дообучают на данных Netflix, и получается foundation-модель, которая понимает каталог и зрителей. Потом эту модель регулярно дообучают уже под ранжирование. На вход ей подаётся текст: история просмотров, метаданные тайтлов и контекст (устройство, время, страна), причём история оформлена как диалог пользователя с рекомендателем. Токены модель не генерирует. Вместо этого catalog-aware head за один forward pass выдаёт скоры сразу для всего каталога, поэтому выдумать несуществующий тайтл она не может в принципе. В проде это крутится на vLLM в режиме prefill-only, без декодинга и beam search. Чтобы модель думала о долгосрочном удержании и соблюдала баланс между фильмами, играми и лайвами, в лосс добавили веса от reward-моделей. GRPO тоже пробовали, и он давал прирост, но обучение с ним оказалось слишком дорогим.
🔢 Числа
GenRec обучали на данных Phase 2, которых примерно в 40 раз меньше, чем у прод-модели, и всё равно офлайн MRR вырос на 1.6%. A/B-тест шёл четыре недели на ~10% трафика и показал статзначимый рост как краткосрочных, так и долгосрочных метрик. Обе фазы вносят заметный вклад: Phase 1 даёт +10–20% к MRR по сравнению с обычной OSS-моделью, а Phase 2 добавляет сверху ещё 35–50%. Бэкбоны тестировали от ~1B до ~10B параметров, и качество монотонно росло и с объёмом данных, и с размером модели, так что скейлинг-законы работают и в рекомендациях. Отдельно поработали над контекстом: его ужали с ~5000 до ~1700 токенов почти без потери качества, и инференс подешевел примерно втрое.
Получается совсем не нужно было городить этот зоопарк фичей и эвристик, а можно было просто хорошо покрутить модельку. Думайте.
#AI
@techn0danya