Нюансы Fable 5.1 в SWE задачах
В
системной карточке Fable 5.1 (которая аж на 212 страниц) как обычно можно найти множество интересных инсайтов. Вот что мне показалось интересным:
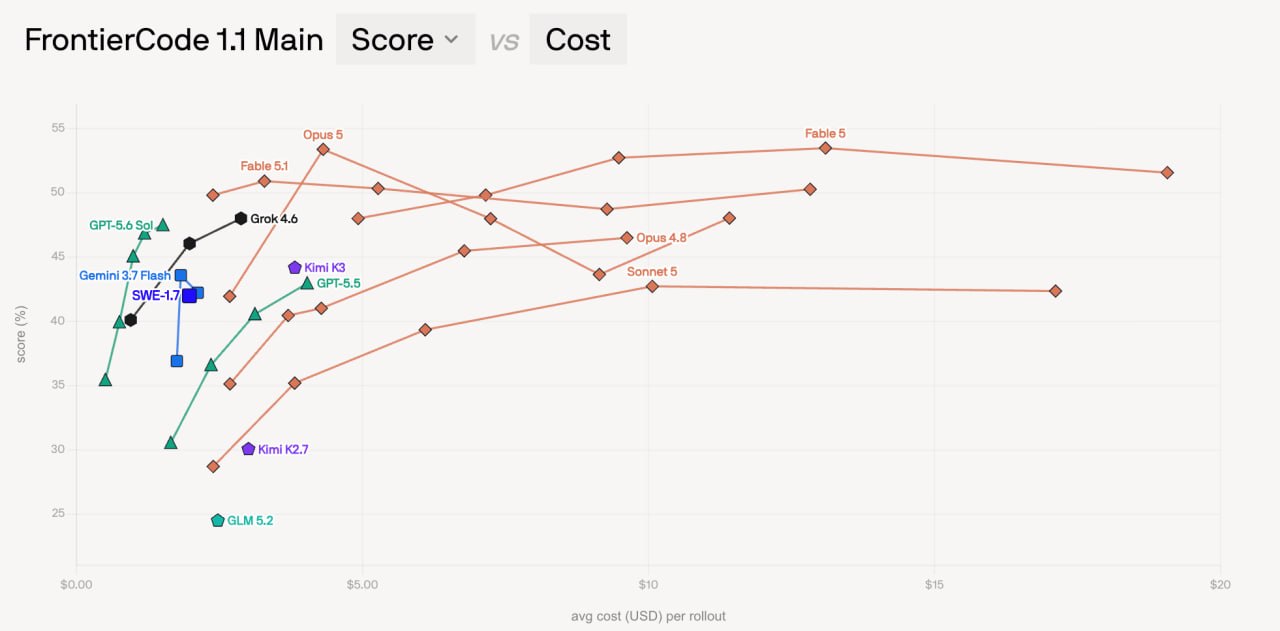
* Нынче один самых важных вопросов - а какой reasoning effort оптимален? Тк мы видим из бенчей, что он напрямую влияет на цену, а значит и на то, как быстро будут уходить лимиты. Кроме того, на некоторых бенчах можно заметить, что более высокий effort ухудшает результаты моделей. Так, например, во
FrontierCode (Main субсет) результаты Fable 5.1 после medium не становятся лучше. А если сравнивать medium vs max, то получим 50.9% vs 50.3%, при том, что medium почти в 5 раз дешевле max. Кроме того, в этом бенче Fable 5.1 medium даже вышел дешевле, чем Opus 5 medium, хоть и с чуть более скромным результатом (50.9 vs 53.4), что тоже слегка удивляет. А в карточке Антропик по этому поводу пишут, что на высоком ризонинге фейбл 5.1 начинает делать больше, чем ее просили. И пишут:
Если дополнительно попросить модель быть лаконичнее и не добавлять лишние комментарии или документацию, она реже вносит изменения вне заданного scope. Но опубликованные benchmark-результаты получены без такой дополнительной инструкции.
Напомню на всякий случай, что FrontierCode 1.1 от команды Devin - это один из немногих закрытых бенчмарков.
* Результаты Fable 5.1 в
DeepSWE v1.1: 67.4%. Но есть важный нюанс:
Антропики рапортают, что Фейбл сделала часть задач даже тщательнее, чем того требовало задание, поэтому часть скрытых тестов завалились (стр. 168).
* В DRACO (это бенчмарк на диприсерч от Perplexity), опус 5 почти на всех эффортах сильнее Fable 5.1 - вот и думайте) Любопытно, кстати, что у них там Opus 4.6 в кач-ве судьи над Опусом и другими - мб в этом дело.
* И ресерчеры из METR говорят, Fable 5.1 особенно сильна, когда у задачи есть понятный фидбек. Но когда надо самому придумать,
что проверять, куда копать дальше и как вообще выстроить исследование, всё заметно хуже. Вот вам и long-horzont tasks... Все равно, нужно четко критерии ставить и послеживать, чтобы не дрейфовала.
Из забавного: на моей памяти впервые Антропик замерили свои модели на бенчмарке FrontierSWE (ага, еще один фронтир - он, к слову, старее всех остальных фронтиров), это бенчмаре на ультра-большие задачи на десятки а то и сотни тысяч LoC, тем самым как бы легализовав его. Получилось вот так: Fable 5.1 (0.57), Claude Opus 5 (0.52), Claude Fable 5 (0.48), GPT-5.6 Sol (0.32). Что забавного? 1. В первой версии их бенчмарка грок 4.5 как-то оказался выше опус 4.8, при том, что грок 4.5 - модель откровенно слабая. 2. Вторая версия бенчмарка пока недоступна нигде, а
ссылка из System Card показыват 404. Видимо, ребята тормозят с релизом.
И немаловажный нюанс: cutoff date Fable 5.1 июнь 2026, а Opus 5 май 2026. При этом, знания GPT 5.6 sol заканчиваются на фервале 2026. Что нам с этого? То, что всякие современные знания про разработку агентнов и агентную разработку из коробки будут актуальнее всего у Fable 5.1. А по моему опыту агенты очень плохо пишут других агентов (если они хоть немного нестандартные).
Какой я для себя делаю вывод? Для большинства задач в Claude Code, видимо, продолжу использовать Opus medium, для планирования и второго мнения Fable 5.1 medium, а для чего-то особого сложного Fable 5.1 xhigh.
@ai_drive